Harness-1:20B 参数开源搜索智能体,通过“状态外化”架构超越 GPT-5.4,仅需 4,400 条训练数据即可实现高效复杂检索,Apache 2.0 许可商用友好
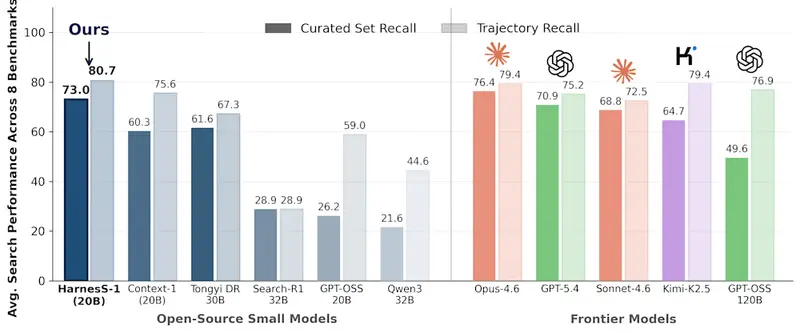
在复杂信息检索领域,传统 AI 智能体常因“搜索健忘症”而受困于不断膨胀的上下文窗口。Harness-1,一款由伊利诺伊大学厄巴纳-香槟分校、加州大学伯克利分校与 Chroma 联合推出的 200 亿参数开源搜索智能体,通过 “状态外化”(State Externalization) 架构,彻底改变了这一局面。它不仅以 73% 的平均召回得分超越了 GPT-5.4、Sonnet-4.6 等 proprietary 巨头,更证明了通过优化认知框架而非单纯扩大模型规模,也能实现顶尖性能。
- GitHub:https://github.com/pat-jj/harness-1
- 模型:https://huggingface.co/pat-jj/harness-1
核心亮点:状态外化、极致高效、开源自由
1. 状态外化框架:给 AI 一张“办公桌”
- 解决认知过载:传统智能体将搜索历史全部塞入上下文窗口,导致注意力分散。Harness-1 引入结构化软件环境作为“外部记忆”,接管繁琐的簿记工作(如引用追踪、路径记录)。
- 专注核心能力:模型只需专注于语义选择与决策,无需记忆细节,从而在长周期、多步骤搜索中保持极高的准确性与连贯性。
2. 数据效率大师课
- 极简训练:仅使用 899 条 经 GPT-5.4 教师代理生成的监督微调轨迹,以及 3,453 次 强化学习查询(总计约 4,400 个独特项目)。
- CISPO 算法:采用具有特定奖励函数(区分发现与选择)的强化学习算法,在 40 轮搜索周期内优化模型行为。
- 对比鲜明:相比竞品需海量数据且效果更佳,Harness-1 以极低成本实现了性能飞跃。
3. 性能全面领先
- 超越旗舰:在八个复杂搜索基准测试中,平均召回得分 73%,比下一个最准确的开源模型 Tongyi DeepResearch 30B 高出 11.4 个百分点,并优于 GPT-5.4。
- 泛化能力强:即便在训练数据之外的领域,仍能保持高精度的信息检索与整理能力。
技术架构:模块化 RAG 的新范式
Harness-1 并非取代 RAG,而是将其升级为 智能体化/模块化 RAG:
- 自主子智能体:Harness-1 充当独立的检索模块,执行多步骤搜索、筛选与验证。
- 证据包交付:搜索结束后,将高度精炼的文档集(证据包)传递给一个完全独立的、“冻结”的前沿生成模型。
- 解耦生成与检索:确保最终答案基于确凿证据,大幅降低幻觉风险,同时优化整体计算成本。
适用场景与企业价值
- 企业专有知识库检索:在数万份财务申报、法律文件或技术文档中进行深度挖掘,无惧上下文长度限制。
- 复杂市场调研:自动梳理分散的新闻、研报与数据源,生成结构化的事实综述。
- 低成本高性能部署:基于 OpenAI gpt-oss-20b 基座,可在单张或少量 GPU 上运行,显著降低推理成本。
- 合规与商业化:Apache 2.0 许可证 允许无缝集成至商业产品、内部工具或客户-facing 应用中,无法律后顾之忧。
Harness-1 通过将“文书工作”卸载至结构化框架,Harness-1 以更小的规模、更低的数据需求,实现了超越巨型专有模型的性能。
© 版权声明
文章版权归作者所有,未经允许请勿转载。