北京时间 8 月 12 日晚间,阿里通义千问(Qwen)团队迎来里程碑式时刻:Qwen3.8-2.4T-A95B 模型权重正式向全球开发者开放。这是 Qwen-Max 级别的旗舰模型首次实现权重开源,标志着开源社区在万亿参数混合专家(MoE)模型领域取得了重大突破。
该模型总参数量高达 2.4 万亿(2.4T),但在推理时每个 Token 仅激活 950 亿(95B) 参数,兼顾了超大模型的智力密度与高效的推理成本。原生支持 262,144 Token 上下文,并可通过扩展技术处理长达 1,010,000 Token 的超长文本,为长周期 Agent 任务和海量文档分析提供了坚实基础。
- Hugging Face:https://huggingface.co/Qwen/Qwen3.8-2.4T-A95B
- ModelScope:https://modelscope.cn/models/Qwen/Qwen3.8-2.4T-A95B
核心架构:稀疏 MoE 与多步预测
Qwen3.8 延续了 Qwen3.5 的先进混合架构,并在规模上进行了极致扩展:
- 超大规模 MoE:每个 MoE 层包含 512 个专家,每个 Token 动态选择 10 个路由专家,并同时激活 1 个共享专家。这种设计确保了模型在处理复杂逻辑时的专业性,同时保持了计算的高效性。
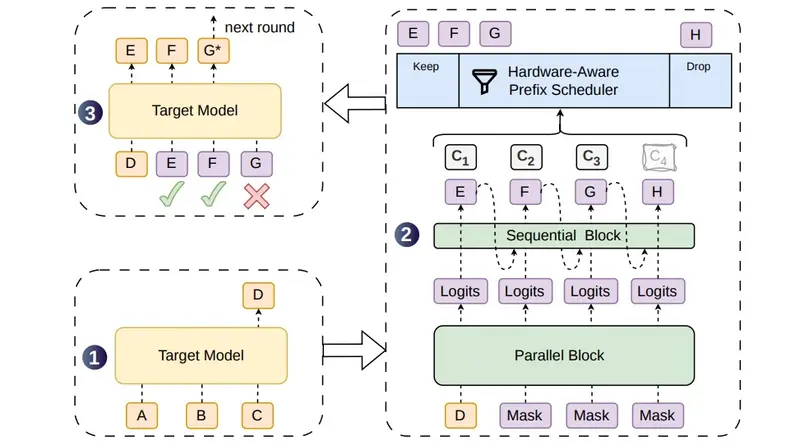
- 多步 Token 预测(MTP):模型经过多步 MTP 训练,能够一次性预测多个后续 Token。这不仅提升了推理速度,也为支持该机制的推理引擎(如 vLLM、TensorRT-LLM)提供了更优化的部署路径。
性能表现:对标国际顶尖闭源模型
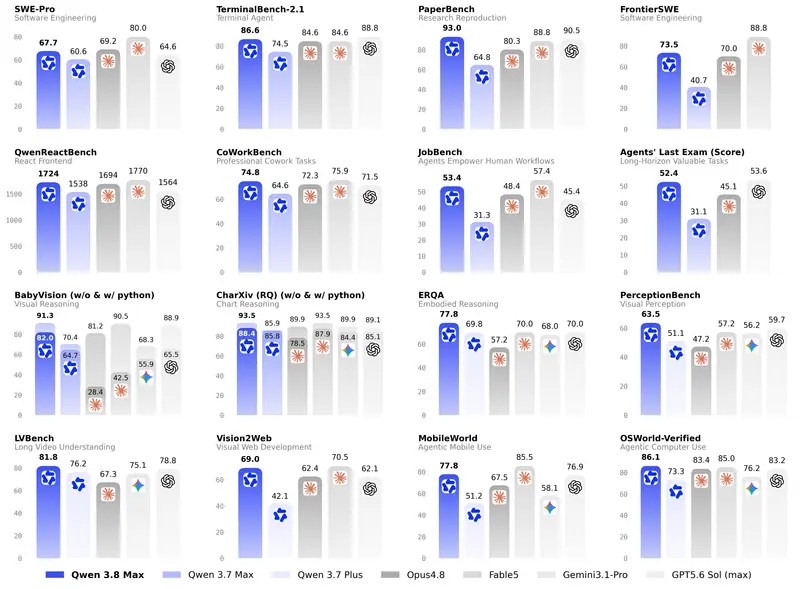
官方评测显示,Qwen3.8-2.4T-A95B 在编程 Agent、通用 Agent、专业工作及长上下文理解等多个维度上,与 Opus 4.8、Fable 5、GPT-5.6 Sol 等国际顶尖模型互有高低。特别是在 PaperBench(科研论文理解)和 IFBench(指令遵循)等硬核基准测试中,Qwen3.8 取得了所列模型中的较高成绩,证明了其在深度推理和复杂任务执行上的强大实力。
训练革新:三大支柱构建超级 Agent
为了提升模型在办公、科研及长周期 Agent 任务中的端到端完成能力,Qwen 团队在后训练阶段引入了三项关键创新:
- 真实环境的组合式扩展:
不再依赖逐一定制的环境集成,而是通过解耦“任务”(单任务→跨天任务)、“工作空间”(多文件→复杂异构目录)和“Harness”(技能/版本)三个维度,以组合方式自然生成海量的真实训练环境。这使得模型能够适应极其复杂的现实工作流。 - 统一的异构奖励系统:
构建了一个涵盖基于执行的校验、文本/视觉输出的 Rubric 评估以及 Agentic 检查的统一奖励系统。它消除了传统任务专用验证器(Verifier)的不一致性,为所有环境提供了一致、可靠的强化学习信号。 - 在线数据均衡器:
针对强化学习训练中 Batch 间梯度方差大的问题,开发了在线数据均衡器。它对每个 Batch 在任务、难度、工作区与 Harness 上的分布进行实时重构与均衡,确保了训练算力的稳定扩展和模型收敛的高质量。
生态影响:从云端到本地的范式转移
Qwen3.8-2.4T-A95B 的开源,意味着企业和个人开发者现在可以在本地或私有云上部署一个具备 Qwen-Max 级别能力的模型。虽然云端版 Qwen3.8-Max 会加入更多生产环境特有的优化和能力,但开源权重已经足以支撑绝大多数高阶应用场景,包括:
- 全栈代码生成与维护:处理百万行级代码库的重构与调试。
- 深度科研辅助:快速阅读并总结数百篇学术论文,提取关键实验数据。
- 复杂办公自动化:跨应用、跨文件的长周期任务编排与执行。
© 版权声明
文章版权归作者所有,未经允许请勿转载。