在追求极致响应速度的本地 AI 应用中,传统自回归模型的串行生成模式往往成为瓶颈。DiffusionGemma,谷歌最新推出的实验性开放模型,通过引入文本扩散(Text Diffusion)技术,彻底改变了这一局面。作为一个 260 亿参数的混合专家(MoE)模型,它在推理时仅激活 38 亿参数,却能通过并行生成整个文本块,在专用 GPU 上实现高达 4 倍 的文本生成速度提升,为交互式编辑、快速迭代及非线性文本构建打开了新大门。
- 官方介绍:https://blog.google/innovation-and-ai/technology/developers-tools/diffusion-gemma-faster-text-generation
- 模型:https://huggingface.co/google/diffusiongemma-26B-A4B-it
- GGUF:https://huggingface.co/unsloth/diffusiongemma-26B-A4B-it-GGUF
核心亮点:并行、极速、轻量
1. 突破串行瓶颈:从“打字机”到“印刷机”
- 并行块生成:不同于传统模型逐 Token 预测,DiffusionGemma 每次前向传递并行生成 256 个 Token 的完整段落。
- 硬件满载:将解码瓶颈从内存带宽转移到计算单元,充分利用 GPU 算力,避免单用户本地推理时的硬件闲置。
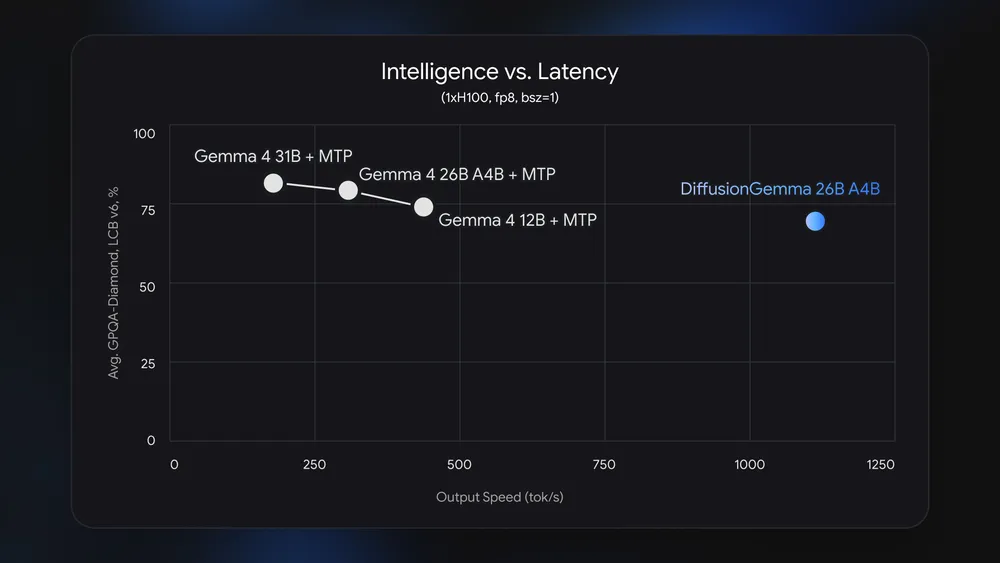
- 速度飞跃:在低并发、单加速器场景下,推理速度最高提升 4 倍,显著降低交互延迟。
2. 智能自校正与双向注意力
- 全局视野:采用双向注意力机制,每个 Token 都能关注到上下文中的所有其他 Token,确保语义连贯性。
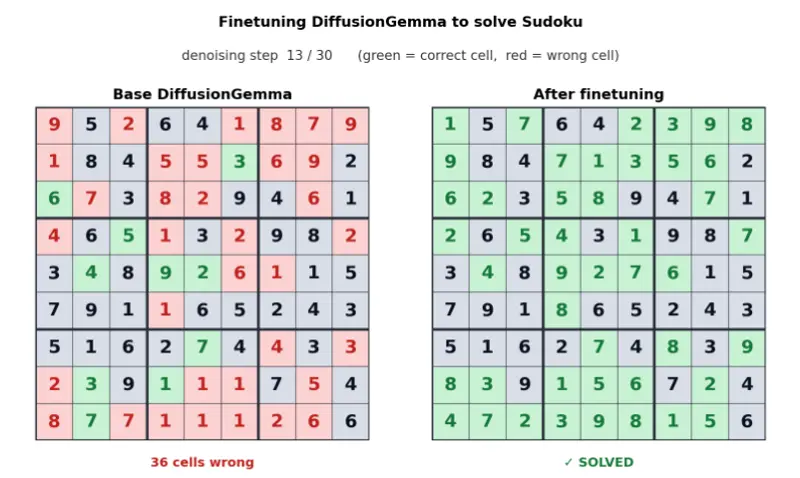
- 迭代优化:模型从随机噪声画布开始,通过多次遍历锁定正确 Token 并修复错误,具备类似图像生成的“去噪”能力,能实时完善 Markdown 格式或代码结构。
3. 消费级友好部署
- 低显存占用:得益于 MoE 架构,量化后可轻松适配 18GB 显存 的高端消费级 GPU(如 RTX 4090)。
- 广泛兼容:支持 MLX, vLLM, Hugging Face Transformers 等主流框架,并与 NVIDIA 硬件栈深度优化,确保从桌面到企业级的平滑体验。
技术原理:文本扩散如何工作?
- 初始化画布:模型从一组随机占位符 Token 开始。
- 迭代去噪:通过多次前向传递,模型逐步识别并锁定高置信度 Token,同时利用这些线索优化剩余部分。
- 收敛输出:经过几轮迭代,文本从混乱状态收敛为高质量、逻辑连贯的最终结果。
注:这种机制使其特别擅长处理需要全局一致性的任务,如代码补全、复杂格式排版及非线性叙事生成。
适用场景与权衡
| 场景 | 优势 | 注意事项 |
|---|---|---|
| 本地交互式应用 | 极低延迟,响应迅速,提升用户体验 | 需接受实验性模型的特性 |
| 行内编辑与补全 | 并行生成整段内容,无缝融入工作流 | 不适合长篇幅连续创作 |
| 代码实时生成 | 快速构建代码块,自动闭合标签/括号 | 复杂逻辑仍需人工审查 |
| 高并发云服务 | 不推荐(自回归模型在批处理下更高效) | 并行解码在高 QPS 下收益递减且成本更高 |
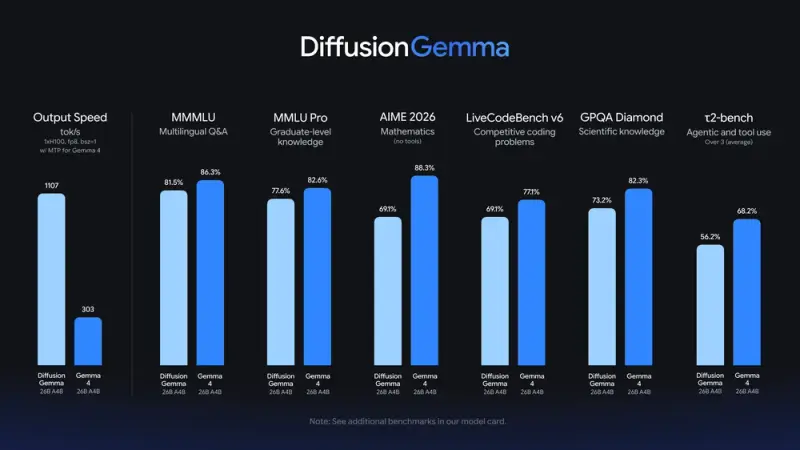
- 质量权衡:由于优先追求速度与并行布局,DiffusionGemma 的整体输出质量略低于标准的 Gemma 4 自回归模型。对于追求极致准确性与文学性的生产环境,建议仍使用 Gemma 4。
快速开始
- 获取权重:已在 Hugging Face 上开源(Apache 2.0 许可证)。
- 开发工具:
- 使用
vLLM或MLX进行高效服务。 - 参考官方提供的 Hackable Diffusion 微调教程。
- 探索
Unsloth和NVIDIA NeMo进行定制化训练。 llama.cpp支持即将上线。
- 使用
- 云端体验:可通过 Gemini Enterprise Agent Platform Model Garden 或 NVIDIA NIM 试用。
© 版权声明
文章版权归作者所有,未经允许请勿转载。