HRM-Text:Sapient 以 1500 美元成本从头训练 10 亿参数基础模型,摒弃 Transformer 采用分层循环架构,在 MMLU/GSM8K 基准上媲美更大开源模型
在大语言模型训练成本动辄数百万美元的今天,Sapient Intelligence 的研究团队提出了一条截然不同的路径。他们发布的 HRM-Text 模型,通过摒弃标准的 Transformer 架构,采用创新的分层循环模型(Hierarchical Recurrent Model, HRM),仅花费约 1500 美元 和 1.9 天 时间,就在 16 GPU 集群上从头训练出了一个 10 亿参数 的基础模型。该模型在 MMLU、GSM8K 等关键基准测试中取得了与更大规模开源模型相媲美的性能,证明了“样本效率”可以取代“蛮力扩展”。
- GitHub:https://github.com/sapientinc/HRM-Text
- 模型:https://huggingface.co/sapientinc/HRM-Text-1B
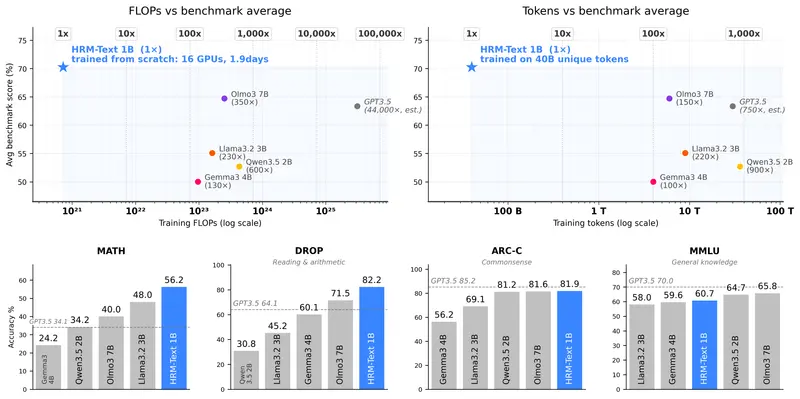
核心亮点:高效、低成本、新架构
1. 分层循环架构 (HRM)
- 计算解耦:将计算过程分为缓慢演化的战略层(Slow H Module)和快速演化的执行层(Fast L Module)。这种数学上必要的分离解决了传统循环架构在大规模语言任务中的不稳定性。
- 稳定机制:引入 MagicNorm 正则化技术和预热方法,确保内部信号稳定,防止神经网络反馈回路崩溃。
2. 极致成本效益
- 超低训练成本:总计算成本仅约 $1,500,相比传统 LLM 的数百万美元投入,降低了数个数量级。
- 数据高效:仅在 400 亿 Token 的精心挑选数据集上训练,而非数万亿 Token 的互联网全量数据。
- 快速迭代:1.9 天即可完成从头预训练,极大缩短了实验周期。
3. 任务导向的训练范式
- 拒绝盲目记忆:训练目标从“下一个 Token 预测”转变为**“任务完成”**,专注于指令-响应对。
- 推理与记忆解耦:证明模型无需记住整个互联网也能成为强大的推理引擎,更适合与企业外部知识库(RAG)配对使用。
性能表现
尽管参数量仅为 10 亿,HRM-Text 在多项权威基准测试中表现优异:
| 基准测试 | HRM-Text (1B) | 表现解读 |
|---|---|---|
| MMLU (多学科理解) | 60.7% | 媲美更大规模的开放权重模型 |
| GSM8K (数学推理) | 84.5% | 展现出强大的逻辑与计算能力 |
| MATH (高等数学) | 56.2% | 在复杂推理任务上保持竞争力 |
为什么 HRM-Text 重要?
1. 打破“规模即正义”的迷思
Sapient CEO Guan Wang 指出,业界长期陷入“当模型失败时,把它做大”的扩展成瘾症。HRM-Text 证明,通过架构创新提升样本效率,可以在更小的规模下获得更强的推理能力,避免收益递减。
2. 让基础模型预训练民主化
对于财富 500 强乃至中小企业而言,HRM-Text 将 AI 从昂贵的“基础设施问题”转化为可负担的“战略问题”。企业不再需要问“我们负担得起吗?”,而是可以问“我们的模型应该针对什么业务逻辑进行优化?”
3. 更适合企业现实场景
通过专注于指令跟随和任务完成,HRM-Text 更贴近企业用户对“针对性答案”的需求,而非泛泛的知识检索。结合外部知识库,它能构建出更精准、更可控的垂直领域专家模型。
© 版权声明
文章版权归作者所有,未经允许请勿转载。