月之暗面发布 Kimi K2.7 Code:万亿参数 MoE 编码智能体,推理 Token 消耗降低 30%,在复杂软件工程与长周期任务中显著超越 K2.6,逼近 GPT-5.5 水平
月之暗面(Moonshot AI)正式推出了专注于编码领域的智能体模型 Kimi K2.7 Code。基于强大的 Kimi K2.6 架构构建,这款拥有 1 万亿总参数(激活 320 亿)的混合专家(MoE)模型,旨在解决真实世界中长周期、高复杂度软件工程任务的痛点。通过优化推理路径,Kimi K2.7 Code 不仅显著提升了编码准确率,更将思考 Token 的使用量降低了约 30%,实现了性能与成本的双重突破。
- 模型:https://huggingface.co/moonshotai/Kimi-K2.7-Code
核心亮点:高效、精准、长程
1. 推理效率大幅提升
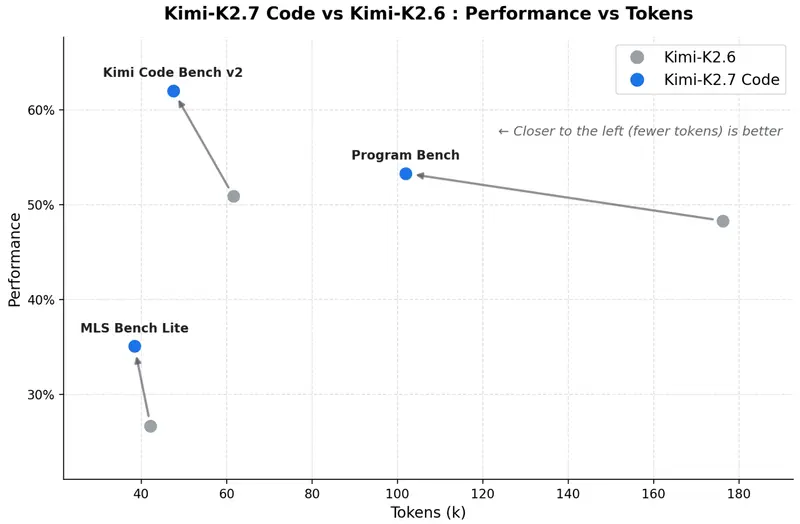
- 拒绝过度思考:针对编码任务特点进行了专项优化,减少了不必要的逻辑回溯与冗余推理。与 K2.6 相比,推理 Token 消耗降低 30%,显著降低了 API 调用成本并提升了响应速度。
- 高速模式预告:官方宣布即将推出 6 倍高速推理模式,进一步满足实时编码辅助的需求。
2. 编码性能全面跃升
在多项权威编码基准测试中,Kimi K2.7 Code 相比前代取得了显著进步:
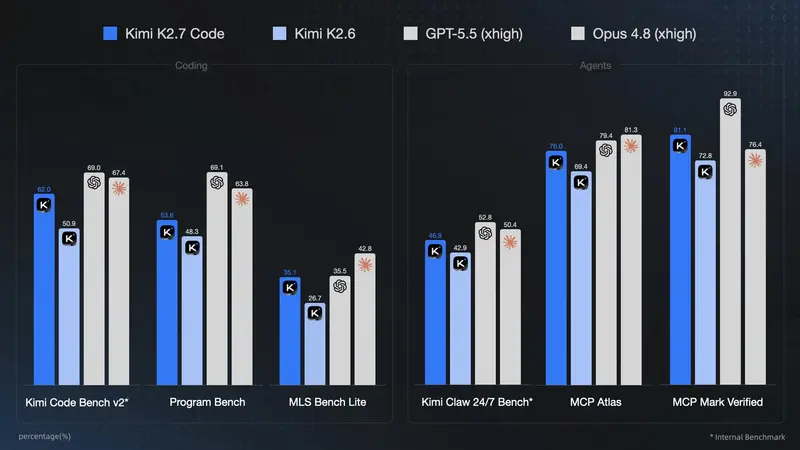
- Kimi Code Bench v2:提升 21.8%(达到 62.0 分)。
- Program Bench:提升 11.0%(达到 53.6 分)。
- MLS Bench Lite:提升 31.5%(达到 35.1 分),显示出在处理复杂机器学习代码时的强大潜力。
3. 强化智能体与长周期任务能力
- 端到端完成率提高:增强了在复杂软件工程工作流中的指令遵循能力,能够更稳定地执行多步骤、跨文件的代码重构与开发任务。
- MCP 协议深度集成:在 MCP Mark Verified 基准测试中得分高达 81.1,优于 Claude Opus 4.8,表明其在连接外部工具、数据库及执行系统级操作方面具有卓越能力。
模型规格与技术架构
| 参数 | 规格 |
|---|---|
| 架构 | 混合专家 (MoE) |
| 总参数量 | 1 Trillion (1T) |
| 激活参数量 | 32 Billion (32B) |
| 上下文长度 | 256K Tokens |
| 注意力机制 | MLA (Multi-Head Latent Attention) |
| 视觉编码器 | MoonViT (400M 参数) |
| 专家配置 | 384 个专家,每 Token 激活 8 个 + 1 个共享专家 |
性能对比:直面顶尖竞品
尽管与 GPT-5.5 等顶级模型仍有差距,但 Kimi K2.7 Code 在特定领域已展现出极强的竞争力,尤其在性价比与中文语境下的工程落地方面优势明显。
| 基准测试 | Kimi K2.6 | Kimi K2.7 Code | GPT-5.5 | Claude Opus 4.8 |
|---|---|---|---|---|
| Kimi Code Bench v2 | 50.9 | 62.0 | 69.0 | 67.4 |
| Program Bench | 48.3 | 53.6 | 69.1 | 63.8 |
| MLS Bench Lite | 26.7 | 35.1 | 35.5 | 42.8 |
| MCP Mark Verified | 72.8 | 81.1 | 92.9 | 76.4 |
适用场景
- 大型项目重构:利用 256K 上下文与长程记忆,处理跨模块的代码迁移与架构优化。
- 自主编码智能体:作为 Kimi Claw 等智能体的核心大脑,执行需要调用多个工具(MCP)的复杂开发任务。
- 成本敏感型开发:对于需要高频调用 API 的初创团队或个人开发者,30% 的 Token 节省意味着显著的运营成本降低。
- 数据科学辅助:凭借在 MLS Bench 上的优异表现,辅助编写复杂的机器学习管道与数据分析脚本。
© 版权声明
文章版权归作者所有,未经允许请勿转载。