在大语言模型(LLM)普遍存在“幻觉”和逻辑跳跃的背景下,webAI 发布了 TwIL-LM 系列模型。这是一个专为自动形式化(Auto-Formalization)设计的轻量级模型家族,包含 1.7B 和 3B 两个版本。它的核心任务是将自然语言翻译为一阶逻辑(FOL),并严格检查结论是否能从前提中推导出来。
- TwiL-LM(1.7B):https://huggingface.co/webAI-Official/TwIL-LM
- TwIL-LM3:https://huggingface.co/webAI-Official/TwIL-LM3
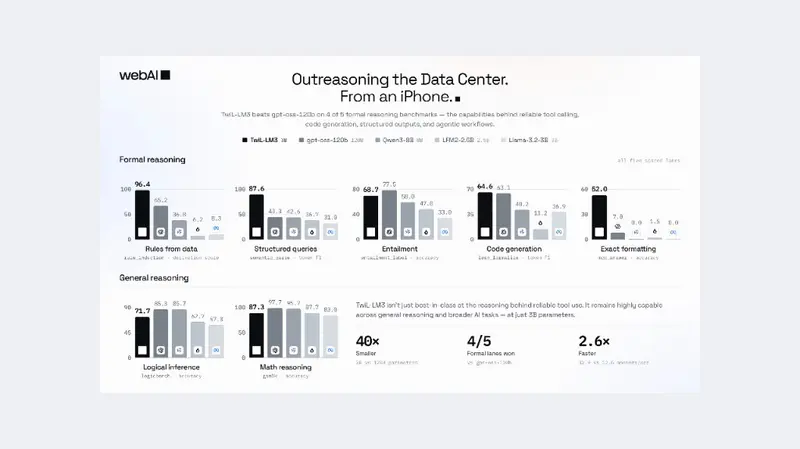
尽管参数量极小(3B 版本的 Q4_K_M GGUF 仅占 1.78 GiB),TwIL-LM3 在多个形式推理基准测试中表现惊人,甚至在某些指标上超越了参数量大其数十倍的开源模型。更重要的是,它完全可以在本地 CPU 或低显存设备上运行,为对数据隐私和逻辑严谨性要求极高的行业提供了新选择。
核心架构:微调、融合与回退的艺术
TwIL-LM3 并非简单的从头训练,而是基于 SmolLM3-3B 进行的一系列精细操作:
- LoRA 监督微调:在合成的形式逻辑语料库上进行初步训练。
- 检查点融合:对中间 SFT 检查点进行参数空间平均,平滑学习轨迹。
- WiSE-FT 插值回退:这是关键一步。通过 $\lambda = 0.25$ 的比例将微调后的权重向预训练基础模型回退。这意味着模型只保留了四分之一的微调增量,从而避免了“灾难性遗忘”,保持了强大的外推能力。
- MGPO 强化学习:最后通过熵加权的 GRPO 阶段,针对程序化验证器进行优化,确保输出的逻辑结构可被机器验证。
性能表现:小身材,大能量
| 指标 | TwIL-LM3 (3B) | gpt-oss-120b | LFM2.5-8B-A1B |
|---|---|---|---|
| 六赛道平均值 | 0.4488 | 0.5192 | – |
| 宏观门控得分 | 0.4218 | – | 0.3757 |
| 生成 Token 数 | 482 (极短) | – | – |
| 推理速度 (Ans/s) | 32.9 | 4.2 | – |
- 效率之王:由于生成的逻辑表达式极其精简,TwIL-LM3 的推理速度是 120B 模型的近 8 倍。
- 外推能力:它是项目中唯一在领域内性能提升的同时,外推能力(如 LogicBench)也同步提升的分支。
- 权衡取舍:为了保持逻辑严谨性,它在 GSM8K(数学应用题)和 IFEval(指令遵循)上的通用能力略有下降。
部署与应用:本地优先,非商业用途
- 硬件门槛极低:1.7B 版本量化后仅 1.06 GB,3B 版本仅 1.78 GB。这意味着它可以在任何现代智能手机、树莓派或老旧笔记本上流畅运行,无需云端 GPU。
- 适用行业:
- 法律与合规:自动审查合同条款的逻辑一致性。
- 金融风控:将复杂的监管规则转化为可执行的逻辑代码。
- 医疗制药:验证临床指南中的推理链条是否严密。
- 形式方法研究:作为 Lean 等证明助手的草稿生成器。
- 许可限制:目前采用 webAI 非商业许可证 ver. 1.0。任何创收用途需单独签署协议。
© 版权声明
文章版权归作者所有,未经允许请勿转载。