Mistral AI发布了其首个时间序列基础模型(TSFM)系列 Timestral。该系列包含 4 个参数规模从 5M 到 209M 的零样本预测模型。其最大亮点在于,即使在标准服务器 CPU 上也能高效运行概率预测,无需依赖 GPU 算力。
- GitHub:https://github.com/mistralai/timestral
- 模型:https://huggingface.co/collections/mistralai/timestral
核心性能与规模
Timestral 提供了 5M、28M、123M 和 209M 四个密集架构模型。最大的 209M 模型在 fp32 精度下权重仅 837 MB,最大支持 32,768 个时间步的上下文。
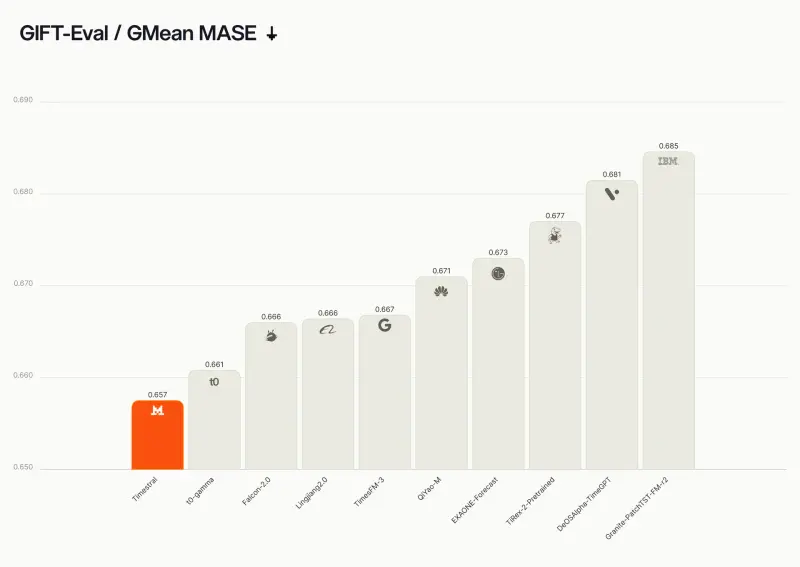
在零样本预训练模型的基准测试中,Timestral-209M 表现优异。在 GIFT-Eval 和 TIME 测试中,其 MASE 和 CRPS 指标均处于领先位置。在 fev-bench 测试中,其 SQL 技能分数达到 50.39,优于 Google TimesFM-3 的 48.99。值得注意的是,规模扩展在顶部已趋于平缓,123M 模型在 GIFT-Eval 上的得分与 209M 模型相差无几,而 28M 模型在部分测试中已击败参数量大约为其 4 倍的 Chronos-2。
技术架构与工作原理
Timestral 采用因果、基于补丁的 Transformer 架构,结合了时间注意力和变量注意力。209M 版本包含 24 层,嵌入维度为 768。每个补丁覆盖 32 个时间步,单次前向传递可预测最多 1,024 步。对于更长的预测视野,模型会逐块运行,并将每个块的中位数作为上下文反馈。
Mistral 在架构上引入了四项关键技术设计:
- 解耦视野预测 (DHF):学习到的预测 token 可读取完整历史。观察值保留在上下文中,避免了类似 TimesFM-3 中连续补丁掩码带来的信息损失。
- 协变量感知注意力:严格区分目标序列、仅过去协变量和已知未来协变量。信息仅从协变量单向流向目标,有效防止未来数据泄漏。
- 合成优先数据:训练数据主要由包含趋势、季节性、噪声和非线性跨序列依赖的合成数据构成。
- 两阶段训练:先在上下文长度为 8,192 的合成数据上预训练,随后在上下文长度扩大 4 倍的混合数据上进行后训练。损失函数采用 21 个分位数上的 pinball 损失,支持多变量目标的联合预测。
推理速度与部署
在 8 线程标准服务器 CPU 上的测试显示,基于 3 周(15 分钟间隔)的历史数据预测未来 1 天,5M 模型耗时仅 10 毫秒,209M 模型耗时 140 毫秒。123M 模型在延迟增加有限的情况下,性能已非常接近 209M 模型,为开发者提供了灵活的算力与精度权衡选项。
在部署方面,Timestral 采用修改版 MIT 许可证发布,相比 TimesFM-3 的非商业许可证更具开放性。开发者可通过 pip 直接安装,依赖 Python 3.10+ 和 PyTorch 2.4+ 等基础库。模型支持在本地、VPC 或气隙环境中部署。针对专有数据的微调需求,可通过 Mistral Forge 平台完成。
© 版权声明
文章版权归作者所有,未经允许请勿转载。