腾讯混元团队正式发布了 Hy3 的完整版本。作为一款拥有 2950 亿总参数、210 亿活跃参数的混合专家(MoE)模型,Hy3 最引人注目的变化是其采用了宽松的 Apache 2.0 许可证,彻底消除了此前预览版中针对欧盟、英国等地区的法律限制。这一举措使其成为企业级部署中极具吸引力的开源选项,尤其是在合规性要求严格的跨国业务场景中。
- GitHub:https://github.com/Tencent-Hunyuan/Hy3
- 模型:https://huggingface.co/tencent/Hy3
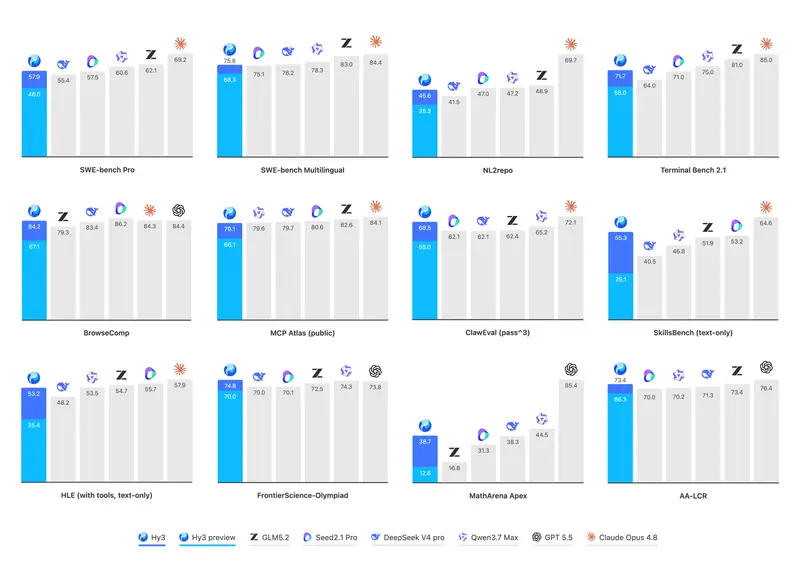
核心定位:可靠性与经济性优于极致编码性能
与智谱 AI 最新发布的 GLM-5.2(约 7440 亿参数,400 亿活跃参数)相比,Hy3 在参数量上仅为对手的一半左右。腾讯并未试图在纯编码能力上全面超越 GLM-5.2,而是选择了一条差异化的竞争路径:在搜索、工具编排和长上下文检索等智能体工作负载上确立优势,同时提供极高的部署经济性和生产可靠性。
1. 性能表现:非编码领域的全面胜出
根据腾讯内部的盲测与基准测试:
- 智能体搜索与工具链:在 BrowseComp (84.2分) 和 DeepSearchQA (91.0分) 上领先所有开放权重模型,表现可与 Claude Opus 4.8 和 GPT-5.5 媲美。
- 长上下文与多轮对话:在 MRCR 长对话基准上得分从预览版的 42.9% 跃升至 75.1%,显著提升了复杂交互中的稳定性。
- 编码能力:虽然在 SWE-bench 等编码基准上略逊于参数规模更大的 GLM-5.2,但在前端开发、CI/CD 及数据存储工作流中仍表现出强劲竞争力(盲测得分 2.67 vs GLM-5.1 的 2.51)。
2. 生产级可靠性:幻觉率减半
腾讯特别强调了 Hy3 在企业真实场景中的稳定性指标:
- 幻觉率:从预览版的 12.5% 降至 5.4%。
- 常识错误率:从 25.4% 降至 12.7%。
- 多轮交互问题率:从 17.4% 降至 7.9%。
这些改进得益于细粒度的数据清洗和针对明确行为模式的训练约束,旨在解决企业用户在生产环境中对“自信捏造”的担忧。
3. 部署经济性:适配受限硬件的高效架构
Hy3 的设计充分考虑了地缘政治背景下的硬件约束:
- 内存占用低:FP8 精度下权重占用低于 300GB,远低于 GLM-5.2 的 ~744GB。这意味着仅需 8x NVIDIA H20-3e(符合美国出口限制的增强版 H20)即可实现全精度服务,而无需昂贵的 H200 集群。
- 推理效率高:每 Token 计算量几乎减半,为 KV 缓存和批处理留出更多空间,显著降低了单次请求的成本。
- 广泛兼容性:由于对算力要求较低,该模型在西方数据中心常见的 H100/H200/B200 上运行更加轻松,支持 vLLM、SGLang 及 MTP 推测解码。
技术架构与迭代历程
- 架构细节:总参数 295B,激活参数 21B,路由前 8/192 专家,配备 3.8B 参数的多 Token 预测层用于推测解码,支持 256K 上下文窗口。
- 快速迭代:从 4 月预览版到正式版仅用时十周,期间收集了内部 50 多个产品团队的反馈,重点修复了任务执行和交互逻辑问题。
市场影响与展望
Hy3 的发布标志着中国开源模型策略的转变:从追求榜单上的绝对高分,转向提供合规、可靠且易于部署的生产级解决方案。
- 对于中国企业:Hy3 提供了在受限硬件(H20)上运行接近前沿能力模型的最佳路径。
- 对于全球企业:Apache 2.0 许可证消除了法律顾虑,使其成为除了 Llama 系列之外,少数可用于商业闭源产品的强大基座模型之一。
尽管其编码能力尚未超越 GLM-5.2,但 Hy3 在智能体搜索、工具调用及长文本处理上的优势,使其成为构建复杂 AI Agent 系统的理想选择。随着 OpenRouter 等平台提供免费试用,以及独立基准验证的跟进,Hy3 有望在全球开源模型生态中占据重要一席。
© 版权声明
文章版权归作者所有,未经允许请勿转载。