Cognition 正式发布了 SWE-1.7,这是其迄今为止训练的最强大模型。该模型在 Kimi K2.7 Code 的基础上,通过全面的强化学习(RL)流程改进,实现了前沿水平的智能表现,同时显著降低了推理成本。SWE-1.7 专为长周期、异步的软件工程任务优化,现已集成至 Devin 平台,并通过 Cerebras 基础设施以 1000 TPS 的速度提供服务。
- 官方介绍:https://cognition.com/blog/swe-1-7
- 地址:https://app.devin.ai
- CLI:https://devin.ai/cli
值得注意的是,尽管 SWE-1.7 基于开源的 Kimi K2.7 训练而成,但 Cognition 并未公开 SWE-1.7 的权重或训练代码。
核心性能表现
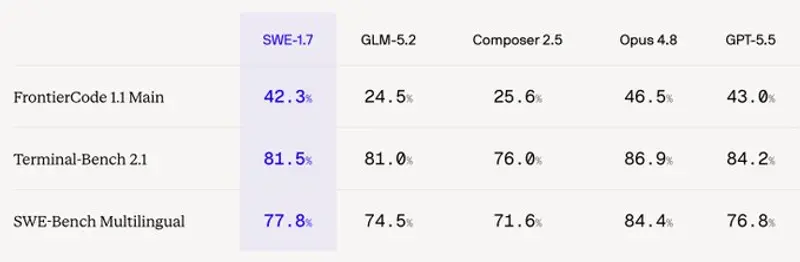
在多项编码基准测试中,SWE-1.7 展现了极具竞争力的性能,尤其在复杂任务处理上超越了部分闭源前沿模型:
| 基准测试 | SWE-1.7 | Kimi K2.7 Code | GPT-5.5 | Opus 4.8 | Opus 4.7 |
|---|---|---|---|---|---|
| FrontierCode 1.1 Main | 42.3% | 30.1% | 43.0% | 46.5% | 38.5% |
| Terminal-Bench 2.1 | 81.5% | 72.7% | 84.2% | 86.9% | 83.0% |
| SWE-Bench Multilingual | 77.8% | 73.5% | 76.8% | 84.4% | 80.5% |
关键技术突破
SWE-1.7 的训练过程引入了四项核心技术创新,解决了大规模强化学习中的稳定性、扩展性及长上下文挑战:
1. 熵保持与稳定训练
为防止强模型在 RL 过程中出现“熵崩溃”(即停止探索、奖励停滞),Cognition 引入了 Top-p 采样重放机制:
- 机制:在 Rollout 阶段记录可采样的 Token 集,并在训练器中利用这些掩码重新归一化概率。
- 效果:避免了低概率 Token 导致的分布尖锐化,保持了训练过程中的熵稳定,同时减少了梯度噪声,使优化更专注于高学习信号的 Token。
- 辅助技术:采用 Muon 优化器并消除训练器中的非确定性操作。
2. 跨大陆多集群训练架构
为突破单一集群的计算限制,Cognition 构建了跨越三大洲、四个数据中心的分布式 RL 训练基础设施:
- 权重同步:通过计算并传输压缩后的权重增量(减少 99% 传输量),利用云对象存储作为唯一真实来源。
- 高效更新:推理引擎在后台预取增量,仅在应用时暂停 3-4 秒,实现了 1T 参数模型在 1-2 分钟内的全球同步。
- 解耦设计:训练器位于高带宽集群,而自包含的推理引擎可部署在任何地方,极大扩展了算力规模。
3. 工业级容错机制
针对大规模硬件故障,设计了分层恢复策略:
- 推理侧:利用 NVIDIA Dynamo 管理生命周期,故障节点的任务可无缝迁移至健康节点,并从对象存储加载最新权重继续执行。
- 训练侧:每步异步检查点至本地磁盘并对等复制,死节点状态可在秒级重建;支持数据并行副本的动态缩容与扩容,确保 Rollout 管道持续温暖。
4. 长周期任务的智能自压缩
为解决长 Rollout 超出上下文窗口及响应冗余问题:
- 自压缩:当接近上下文限制时,模型自动总结工作状态并从摘要中恢复,支持长达六小时的连续任务执行。
- 交替长度惩罚:在无约束阶段优化成功率,在预算阶段惩罚超额长度,促使模型在简单任务上精简思维链,而在困难任务上保留详细推理。
数据质量与对齐
Cognition 强调数据在塑造模型行为中的核心作用:
- 难度校准:精选模型仅在小部分时间内能解决的任务,以产生有效的学习信号。
- 验证器质量保证:通过严格流程最小化误报和漏报。
- 防作弊机制:包括沙箱网络限制、Git 历史剥离、评分路径隔离以及对作弊轨迹赋予零奖励。
模型行为特征
经过深度 RL 训练的 SWE-1.7 表现出与基座模型显著不同的行为:
- 精简思维链:相比 Kimi K2.7 Code,SWE-1.7 的思维链虚词比例更低,平均每句词数减少近一半,体现了更高的信息密度。
- 高对齐度与可信度:在配套评估中显示出更强的指令遵循能力和可靠性。
© 版权声明
文章版权归作者所有,未经允许请勿转载。