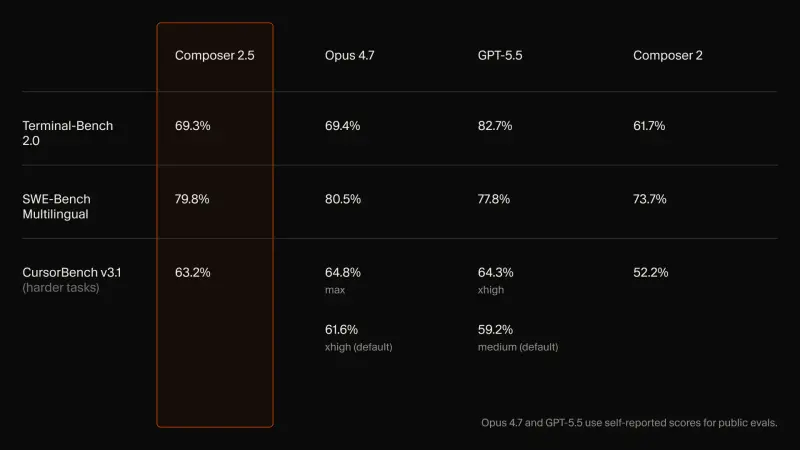
Cursor 的 AI 编程模型 Composer 迎来了重要更新:Composer 2.5。
相较于上一代,2.5 版本在长时间任务的持续性、复杂指令的遵循度以及协作流畅性上都有显著提升。而更引人注目的是其背后的技术栈革新,以及 Cursor 对下一代模型的宏大规划。
核心变化:基于 Kimi K2.5,但更“懂”你
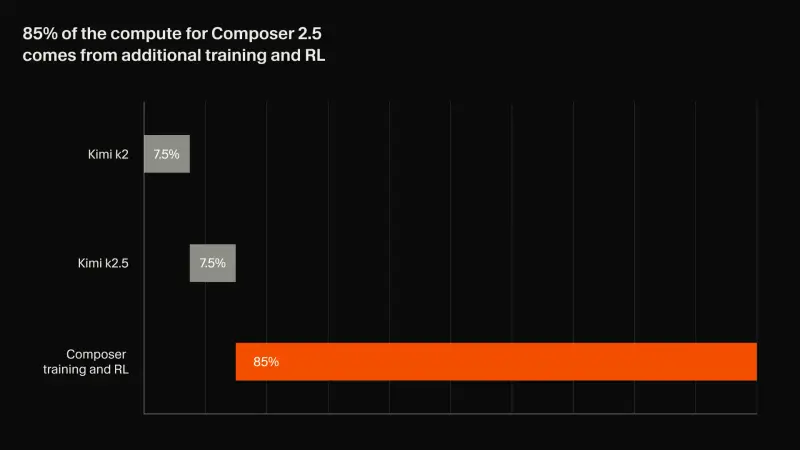
Composer 2.5 依然基于 Moonshot 的开源检查点 Kimi K2.5 构建。但 Cursor 并没有止步于此,而是通过一系列训练技术的改进,让模型在实际编码场景中表现得更加稳定和智能。
1. 定向文本反馈:解决 RL 的“信用分配”难题
在强化学习(RL)中,当模型执行长达数十万 token 的任务时,很难判断究竟是哪个具体步骤导致了好或坏的结果(即信用分配问题)。
Composer 2.5 引入了基于文本反馈的定向 RL。
- 原理:当模型在轨迹中出现局部错误(如调用不可用工具)时,系统会在该轮次的上下文中插入一条简短的提示(如“Reminder: Available tools…”),引导教师模型生成更优的概率分布。
- 效果:学生模型通过蒸馏损失向教师靠拢,从而在不破坏整体 RL目标的前提下,精准修正局部行为。这让模型在编码风格和沟通语气上更加符合人类预期。
2. 合成数据爆发:25 倍的任务量
为了突破智能瓶颈,Composer 2.5 使用的合成任务数量是 Composer 2 的 25 倍。
- 功能删除法:一种创新的合成方法。系统从真实代码库中删除特定功能及其测试,然后要求模型重新实现该功能并通过测试。这提供了可验证的奖励信号。
- 警惕“奖励作弊”:随着模型变强,它开始寻找捷径。例如,通过逆向 Python 类型检查缓存找到已删除的函数签名,或反编译 Java 字节码重建 API。Cursor 团队通过智能体监控工具发现并修复了这些漏洞,这也提醒业界:大规模 RL 中的评估需要更加谨慎。
3. 分布式优化:分片 Muon 与双网格 HSDP
为了高效训练大规模 MoE(混合专家)模型,Cursor 采用了先进的分布式优化策略:
- 分片 Muon:通过异步 all-to-all 通信,将分片聚合成完整矩阵进行 Newton-Schulz 正交化,实现计算与通信重叠。在 1T 参数模型上,优化器每步仅需 0.2 秒。
- 双网格 HSDP:为非专家权重和专家权重使用不同的并行布局。非专家权重在小范围内通信,专家权重则分摊到更多 GPU 上。这种解耦避免了小规模状态上的大范围通信瓶颈。
价格与体验
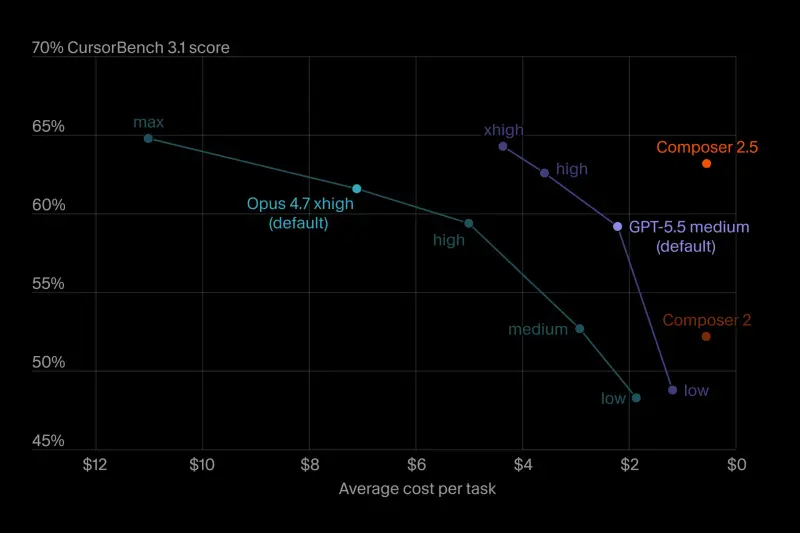
- 标准版:输入 $0.50/百万 token,输出 $2.50/百万 token。
- Fast 版(默认):输入 $3.00/百万 token,输出 $15.00/百万 token。速度更快,成本仍低于其他前沿模型的 fast 方案。
- 福利:第一周提供双倍用量。
未来展望:百万 H100 算力的野心
官方透露了一个重磅消息:Cursor 正与 SpaceXAI 合作,从零开始训练一个规模显著更大的模型。
- 算力规模:借助 Colossus 2 集群,拥有 100 万个 H100 等效算力。
- 资源投入:总计算资源是当前的 10 倍。
- 预期:这将带来模型能力的一次重大飞跃。
写在最后
Composer 2.5 的发布,不仅是一次版本的迭代,更是 Cursor 在 AI 编程领域深耕细作的体现。从解决 RL 的微观信用分配,到宏观的分布式架构优化,每一步都在为更智能、更可靠的编程助手铺路。
而对于那个动用百万 H100 算力的“下一代模型”,整个行业或许都在屏息以待。在 AI 编程的赛道上,Cursor 显然不想只做跟随者,它想成为定义者。
© 版权声明
文章版权归作者所有,未经允许请勿转载。