在大型语言模型普遍追求参数规模膨胀的今天,上海人工智能实验室推出了 Intern-S2-Preview——一款仅含 350亿(35B)参数 的科学多模态基础模型。令人惊叹的是,它在多个核心专业科学任务上的表现,竟与参数量高出数个数量级的 万亿级模型 Intern-S1-Pro 相当。
- 模型:https://modelscope.cn/models/Shanghai_AI_Laboratory/Intern-S2-Preview
Intern-S2-Preview 基于 Qwen3.5 继续预训练而成,其核心突破在于提出了 “任务扩展”(Task Scaling) 新范式:不再单纯依赖数据堆砌,而是通过增加科学任务的难度、多样性与覆盖范围,并将数百个专业任务融入从预训练到强化学习(RL)的全链路流程。这不仅赋予了模型强大的通用推理与多模态理解能力,更使其成为首个兼具材料晶体结构生成能力与通用智能的开源模型。
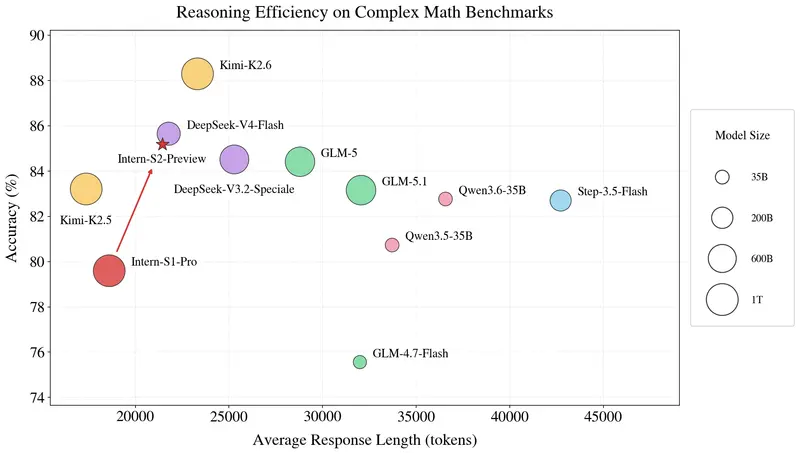
核心亮点:任务扩展、晶体生成、高效推理
1. “任务扩展”范式:小参数撬动大智慧
- 全链路科学增强:将数百个高难度专业科学任务(如分子性质预测、反应路径规划等)深度嵌入预训练、监督微调(SFT)及强化学习(RL)阶段。
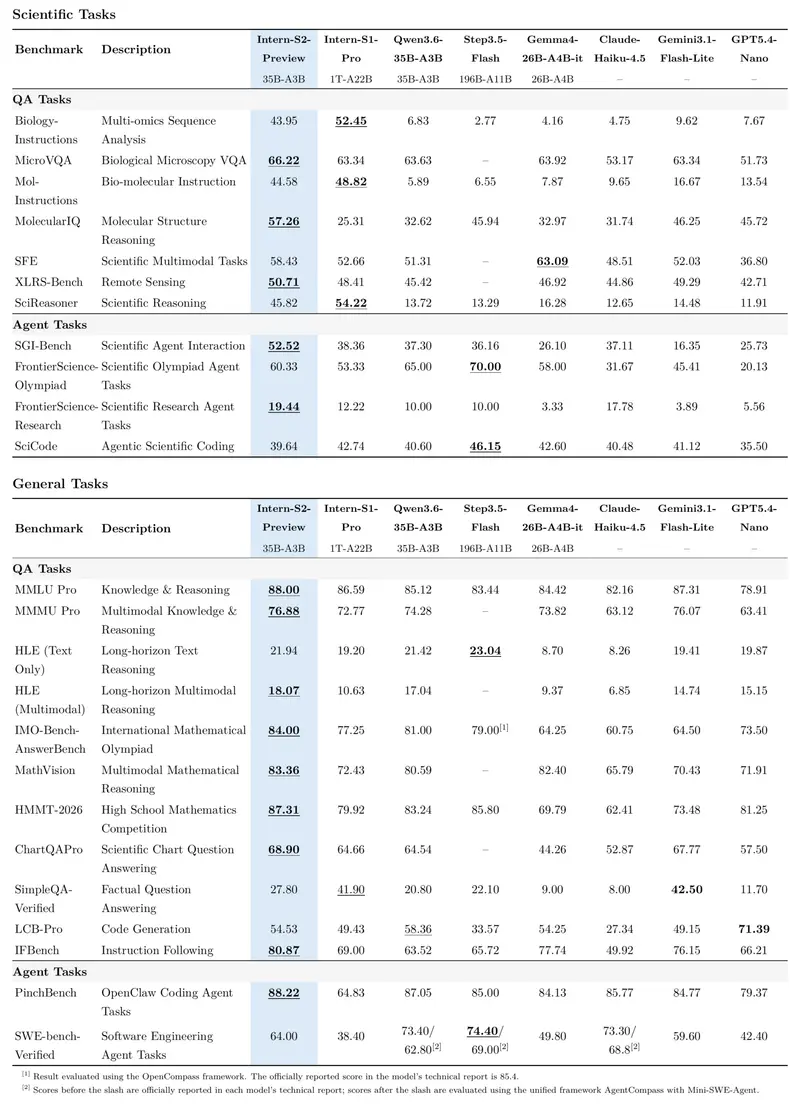
- 性能越级:仅用 35B 参数,在化学、材料、生物等垂直领域的基准测试中,性能追平甚至超越部分万亿参数模型,证明了“高质量任务驱动”比“盲目扩大规模”更高效。
- 通用能力保留:在专精科学的同时,未牺牲通用逻辑推理、多模态理解及 Agent 协作能力,实现“专才”与“通才”的完美平衡。
2. 首创晶体结构生成与实值预测
- 空间建模突破:增强了对小分子及晶体结构的三维空间建模能力,能够精准理解原子间的几何关系。
- 实值预测模块:引入专门的实值预测头,直接输出连续的物理/化学属性数值,而非离散token,显著提升科学计算的精度。
- 材料设计利器:作为首个开源的支持材料晶体结构生成的通用模型,为新材料发现、药物分子设计提供了强大的AI辅助工具。
3. MTP + CoT 压缩:极致高效的推理引擎
- MTP(Multi-Token Prediction)优化:在RL阶段采用共享权重的MTP机制,并结合 KL loss 约束,大幅减少训练与推理行为的不匹配,显著提高 MTP 接受率。
- CoT(Chain-of-Thought)压缩:引入思维链压缩技术,在保留完整逻辑推理路径的前提下,大幅缩短响应长度。
- 双重提速:既提升了 Token 生成速度(吞吐量),又降低了推理延迟,使复杂科学问题的求解更加实时、经济。
4. 增强的科学工作流 Agent 能力
- 自主实验规划:显著提升了在科学场景下的 Agent 能力,能够自主调用工具、规划实验步骤、分析中间结果。
- 基准测试领先:在多个科学智能体基准测试中取得优异成绩,展现出处理长程、多步科学任务的稳健性。
性能对比概览
| 模型 | 参数量 | 核心优势 | 科学任务表现 | 通用能力 |
|---|---|---|---|---|
| Intern-S2-Preview | 35B | 任务扩展、晶体生成、高效推理 | 媲美万亿模型 (SOTA) | 强 (基于Qwen3.5) |
| Intern-S1-Pro | ~Trillion | 规模效应、广泛知识覆盖 | SOTA | 极强 |
| 其他开源VLM/LLM | 7B-70B | 通用对话、基础多模态 | 中等/较弱 | 强 |
注:Intern-S2-Preview 在保持极低参数量的同时,通过任务扩展实现了科学领域的性能跃迁。
技术架构详解
- 基座选择:基于 Qwen3.5 进行继续预训练,继承其强大的语言理解与代码能力。
- 数据策略:构建高质量科学指令集,涵盖化学、材料、生物、物理等领域,强调任务的多样性与难度梯度。
- 训练流程:
- Pre-training:注入科学领域知识。
- SFT:对齐科学问答与推理格式。
- RL (PPO/DPO):利用 MTP 加速采样,结合 KL 约束稳定训练,引入 CoT 压缩优化输出效率。
- 模块创新:
- Spatial Encoder:增强3D结构感知。
- Real-value Head:支持连续数值预测。
© 版权声明
文章版权归作者所有,未经允许请勿转载。