大型语言模型(LLM)正变得日益庞大,万亿级参数成为常态。然而,对于大多数应用而言,只需模型的一小部分能力(如代码生成或数学推理)。传统的单体模型或标准混合专家(MoE)模型往往需要加载全部参数,造成巨大的计算浪费和内存开销。
- 官方介绍:https://allenai.org/blog/emo
- GitHub:https://github.com/allenai/EMO
- 模型:https://huggingface.co/collections/allenai/emo
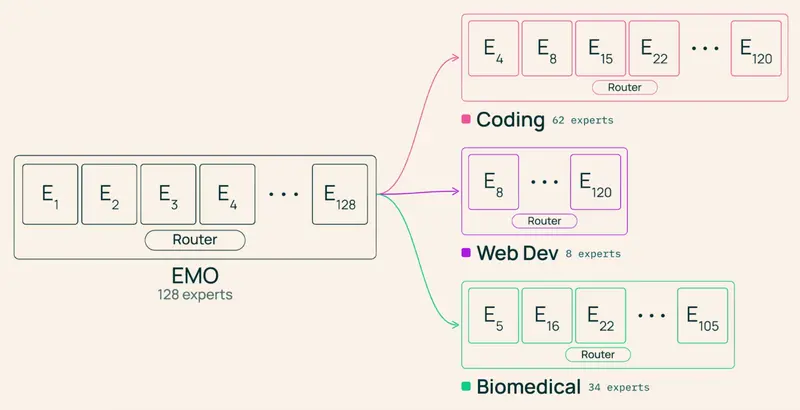
今日,Allen Institute for AI (Ai2) 正式发布 EMO (Emergent Modular Experts),一种全新的端到端预训练 MoE 模型。EMO 的革命性在于其模块化结构直接从数据中涌现,无需人为定义先验知识。它允许用户针对特定任务仅激活 12.5% 的专家,同时保持接近全模型的性能,真正实现了“按需使用,高效运行”。
核心突破:为什么 EMO 与众不同?
1. 真正的“语义模块化”
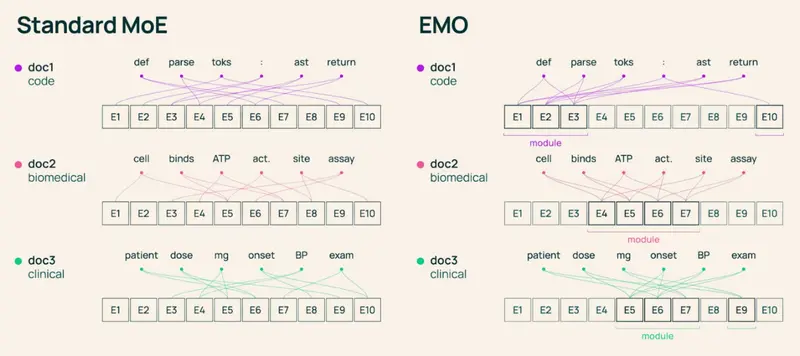
传统 MoE 的专家往往基于低层次语法特征(如介词、标点)进行分工,导致单个任务仍需调用大量分散的专家。
- EMO 的创新:专家自动聚合成连贯的语义群组(如“医疗健康”、“新闻报道”、“政治选举”)。
- 结果:来自同一领域的 Token 稳定路由到同一组专家,使得选择性激活一小部分专家成为可能且高效。
2. 极致效率:12.5% 专家 ≈ 100% 性能
- 参数规模:总参数 14B,激活参数仅 1B(8/128 专家)。
- 性能保留:
- 保留 25% 专家:性能下降仅约 1%。
- 保留 12.5% 专家:性能下降仅约 3%。
- 相比之下,标准 MoE 在同等剪枝下性能急剧崩塌,甚至低于随机水平。
3. 灵活适配:少样本即可定位专家
- 低成本选择:无需完整验证集,仅需少量少样本示例即可识别出最适合当前任务的专家子集。
- 兼容性强:支持与现有专家剪枝方法(如 Easy-EP)结合使用,进一步提升效率。
技术原理:如何让模块化“涌现”?
EMO 的核心在于训练期间引入的文档级路由约束与全局负载均衡机制:
1. 文档池约束 (Document Pool Constraint)
- 假设:同一文档内的 Token 通常属于同一语义领域。
- 机制:在训练过程中,限制同一文档内的所有 Token 只能从一个共享的专家池中选择激活对象。
- 动态选择:路由器自动计算文档内 Token 的偏好,选出最常用的专家组成该文档的专属池。不同文档可使用不同池,从而让专家组结构从数据中自然形成。
2. 全局负载均衡 (Global Load Balancing)
- 挑战:局部负载均衡会迫使同一文档内的 Token 分散到不同专家,破坏模块化。
- 解决方案:在跨大量文档的全局尺度上应用负载均衡。
- 微观一致性:鼓励同一文档内 Token 使用连贯专家池。
- 宏观多样性:鼓励不同文档共同覆盖所有专家,防止模型崩溃到少数专家。
3. 随机池大小采样
- 训练时随机采样文档池大小,防止过拟合单一子集规模,使模型在推理时能灵活支持不同大小的专家子集。
基准测试与可视化洞察
| 指标 | EMO | 标准 MoE (基线) |
|---|---|---|
| 全量性能 | ✅ 相当 | ✅ 相当 |
| 12.5% 专家性能 | 🟢 下降 ~3% | 🔴 急剧崩塌 |
| 专家聚类特征 | 语义领域 (如医疗、政治) | 语法特征 (如介词、冠词) |
| 文档内路由稳定性 | 高 (集中于一类专家) | 低 (分散于多类专家) |
💡 直观对比:
- 健康文章:EMO 几乎将所有 Token 路由至“医疗健康”专家簇;标准 MoE 则根据“the/your”等虚词分散路由。
- 结果:EMO 的专家子集代表真实能力,可独立运行;标准 MoE 的专家子集无法独立构成完整逻辑。
应用价值
- 低成本专用模型:企业可为不同业务线(客服、代码、法务)部署仅包含相关专家子集的轻量级模型,大幅降低显存和算力成本。
- 动态推理优化:根据用户请求类型,实时动态加载最相关的专家子集,实现毫秒级响应与资源节约。
- 可解释性与控制:模块化结构使得模型内部运作更透明,便于调试、审计和针对性更新特定领域能力。
© 版权声明
文章版权归作者所有,未经允许请勿转载。