MiniMax(稀宇科技)今日正式宣布开源其最新一代模型 MiniMax M3.1 Flash。该模型总参数量达 4280 亿,每 token 激活参数为 230 亿,是一款专为编程、智能体工作流、计算机操作及网络安全设计的原生多模态混合专家(MoE)模型。
- Hugging Face:https://huggingface.co/MiniMaxAI/MiniMax-M3.1-Flash
- 魔搭社区:https://modelscope.cn/models/MiniMax/MiniMax-M3.1-Flash
架构升级与核心优化
在上一代 M3 模型的基础上,M3.1 Flash 引入了多项底层优化,旨在实现任务性能与推理效率的代际飞跃:
- 全模型稀疏注意力(MSA):将模型前三个全注意力层替换为稀疏注意力机制,显著降低计算开销。
- 量化感知训练(QAT NVFP4):路由 MoE 专家(共享专家除外)从 MXFP8 迁移至 NVFP4 W4A4 精度;同时,稀疏注意力索引器和主分支从 Q8KV8 迁移至 Q8KV4,在保持模型能力的同时大幅压缩显存占用。
- DSpark 推测解码:取代了此前类似 EAGLE 的 MTP 方法。本次发布内置了草稿头(draft head),可与兼容的推理服务框架无缝配合,进一步提升生成速度。
- Power-aware scheduling:通过对计算卡功耗的精细分配,确保硬件持续维持算力高位,极致压榨底层硬件效率。
多模态能力与性能表现
M3.1 Flash 支持文本、图像和视频作为输入,并提供高质量的文本输出,其上下文窗口最高可扩展至 1,000,000 tokens,能够轻松处理超长文档与复杂多模态任务。
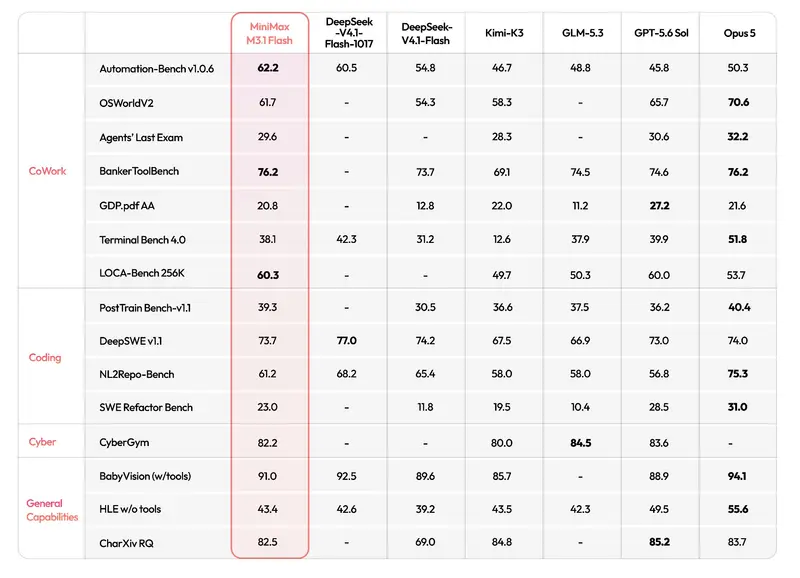
在多项权威基准测试中,该模型展现了卓越的专业能力:
- BankerToolBench:76.2 分
- DeepSWE v1.1:73.7%
- OSWorld V2:61.7 分
- Agents’ Last Exam:29.6 分
- CyberGym:82.2 分
自 10 月 19 日上线以来,M3.1 Flash 展现了极强的工程稳定性与用户需求,72 小时内真实用户处理量已突破 100 万亿 Token。
广泛的开源生态与产业合作
为推动大模型的普惠与广泛应用,MiniMax 宣布了广泛的生态合作计划。在硬件层面,模型已携手华为昇腾、平头哥、昆仑芯、摩尔线程、壁仞、海光、沐曦、天数、NVIDIA、AMD 等海内外主流芯片厂商进行深度适配。
在云服务与推理框架层面,Together AI、Fireworks、Nebius、Baseten、Modal、DigitalOcean 等推理和云服务平台将在开源首日接入该模型。同时,vLLM、SGLang、智源 FlagOS 以及 Hugging Face、魔搭等主流开源社区也将同步提供支持,共同推动 M3.1 Flash 在不同芯片、云平台和开发环境中的无缝部署,持续拓展全球 AI 开源生态。
© 版权声明
文章版权归作者所有,未经允许请勿转载。