Cohere 正式发布了新一代检索重排序模型家族 Rerank 5。该模型分为 Pro 和 Fast 两个层级,旨在 LLM 处理搜索结果前提供更精准的重排序。此次更新引入了段落级上下文聚焦(Context Focus)和校准的相关性分数两大核心功能,为 RAG(检索增强生成)和 AI 代理开发者提供了“发送更少、更优质 Token”的高效解决方案。
- 地址:https://cohere.com/rerank
双层级设计与基础能力
Rerank 5 针对不同场景提供了灵活的模型选择:
- Rerank 5 Pro:面向推理密集型查询和长篇领域特定文档,追求极致的排名质量。
- Rerank 5 Fast:面向需要运行大量搜索的 AI 代理,专注于低延迟与高吞吐量。
两个模型均支持 100 多种语言、32K token 的上下文窗口,并原生支持对 JSON、表格和 YAML 等半结构化数据进行重排序。开发者无需重新索引现有数据,只需更改模型参数即可无缝升级现有的关键词、向量或混合搜索管线。
两大核心技术创新
- Context Focus(段落级上下文聚焦):
这是一个可选功能,开启后可在一次重排序调用中,不仅返回文档的整体分数,还能返回带有评分的字符跨度(包含指向原始文本的起止偏移量)。开发者可通过relevant_spans字段设置阈值和最大跨度数。- 效能提升:Cohere 测试表明,移除一半的检索文本仍能保留 96% 的答案质量。在搜索代理测试中,启用 Context Focus 可将每任务的 Token 消耗削减 19% 至 34%,同时准确率从 49% 提升至 57%-58%。在深度搜索基准中,Token 消耗下降 41%,准确率从 39% 跃升至 52%。
- 校准的相关性分数(Calibrated Relevance Scores):
Rerank 5 的输出分数被校准为概率值(例如,0.7 分意味着该文档有 70% 的概率是有用的)。其预期校准误差(ECE)在人类评分者和 NIST TREC-DL 评估中均低至约 0.06,显著优于 Voyage AI Rerank 3(0.234/0.307)和前代 Rerank 4 Pro。这使得开发者可以基于绝对阈值进行动态过滤,而非依赖固定的 top-k,代理也能更可靠地判断何时未返回相关结果。
基准测试与性能表现
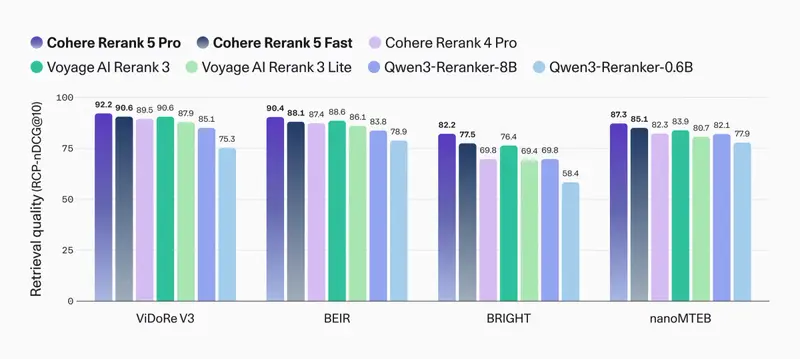
根据 Cohere 使用 RCP-nDCG@10 指标的自报数据,Rerank 5 在多项基准中表现优异:
- Pro 模型:在 46 个复合数据集中的 39 个排名第一。在 BRIGHT 基准上得分 82.2(比 Voyage AI Rerank 3 高出 5.8 分),在 ViDoRe V3 上得分 92.2,BEIR 上 90.4,nanoMTEB 上 87.3。在解析的 PDF 数据集上平均得分 89.9,并在 19 种非英语语言中的 14 种上排名第一。
- Fast 模型:在全部 4 个主要基准上击败了 Voyage AI Rerank 3 Lite、Qwen3-Reranker-8B 和 Rerank 4 Pro。在 ViDoRe V3 上与 Voyage AI Rerank 3 并列第一(90.6)。
部署方案与定价
Rerank 5 提供多样化的部署选项,包括 Cohere API、Model Vault、Microsoft Foundry、Amazon SageMaker,以及支持私有 VPC 和本地部署。
- API 定价:Pro 层级为每 100 万 token 0.05 美元,Fast 层级为 0.02 美元。Model Vault Medium 层级定价为每实例每小时 4.00 美元。
- 生态集成:官方已提供与 LangChain、Haystack、Elasticsearch 和 Weaviate 等主流检索框架的集成文档。
对于致力于优化 RAG 系统成本与精度的开发团队而言,Rerank 5 通过精准的段落提取和高度可信的概率评分,提供了一条在不牺牲准确性的前提下大幅压缩 LLM 上下文窗口的有效路径。
© 版权声明
文章版权归作者所有,未经允许请勿转载。