Hugging Face联合中关村学院、意大利那不勒斯费德里科二世大学,推出开源基因组大模型Carbon-X,可以同时理解DNA序列与自然语言,研究人员能用对话方式查询DNA片段、预测基因突变带来的生物学效应,模型支持笔记本本地部署,敏感基因组数据无需上传云端。
- 模型:https://huggingface.co/HuggingFaceBio/Carbon-X
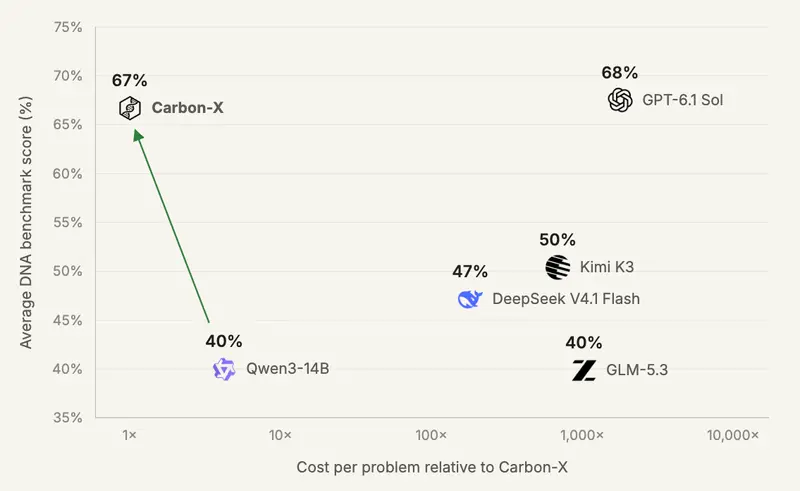
Carbon-X基于Qwen3-14B改造,在合计3000亿token混合数据集上完成训练,数据包含多物种DNA序列(哺乳动物、脊椎动物、植物、真菌等,不含病毒基因组,规避潜在滥用风险)、生物文献文本;模型扩展专属六碱基DNA分词器,相比普通BPE分词,编码DNA时token用量缩减至约1/3。许可证为Apache 2.0,允许研究人员本地部署、二次微调。
核心能力与性能
- 任务能力:解读DNA序列、预测突变致病/良性效应、补全DNA序列、生成新DNA片段;可作为子专家代理,嵌入其他大模型,专门负责基因组解析。测试中接入Kimi K3后,其DNA智能指数从49.4%提升至60.5%。
- 基准表现:在五项DNA基准测试上,Carbon-X超过同级别所有开源模型,平均成绩接近GPT-6.1 Sol,但单次推理成本仅为后者的1/1800。例如大规模遗传变异筛查,240万条未知影响变异使用Carbon-X推理预估仅需300美元,闭源前沿模型成本可达数万至数百万美元。
- 硬件部署:140亿参数,兼容llama.cpp,支持Mac笔记本本地离线运行;单次输入DNA片段上限约50000碱基对,不支持一次性上传完整人类基因组。
典型案例:输入携带A→G单点突变的人类8192碱基窗口,Carbon-X能够识别该变异会破坏剪接位点AG,判定为致病突变。
训练方案设计
整个训练流程分为三阶段:中期预训练 → 监督微调SFT → 带可验证奖励的强化学习RL。
团队专门构建序列确定性验证器,用来校验模型输出的生物学结论,减少幻觉;强化学习阶段针对突变效应预测、DNA问答等任务优化,在突变效应预测任务上获得最大提升。
局限性(重点)
- 尚未经过湿实验室实验、临床验证,预测结果不能直接当作临床诊断依据;
- 长序列场景容易出错:碱基计数、基因坐标定位、长DNA生成容易出现偏差;
- 缺少上下文时会产生生物学幻觉,需要搭配基因注释资料交叉核验;
- 基础生物学问答题上,顶尖闭源模型依旧具备优势。
安全考量
训练集排除病毒基因组,降低生物安全双重用途风险;模型在危险序列编辑任务上能力有限,性能不及传统确定性生物信息工具。开源发布也方便学术界独立评估风险。
© 版权声明
文章版权归作者所有,未经允许请勿转载。