AI 初创公司 Recursive 正式发布了其首个大语言模型 Flint。作为一款专为本地硬件优化的专家混合(MoE)编码模型,Flint 不仅在性能上对标甚至超越了部分更大规模的模型,其开发过程本身也具有标志性意义:该模型几乎完全由 Recursive 自研的自动化研究系统“Eureka Machine”在不到四个月内从头构建完成。
- 模型:https://huggingface.co/RecursiveSI/flint
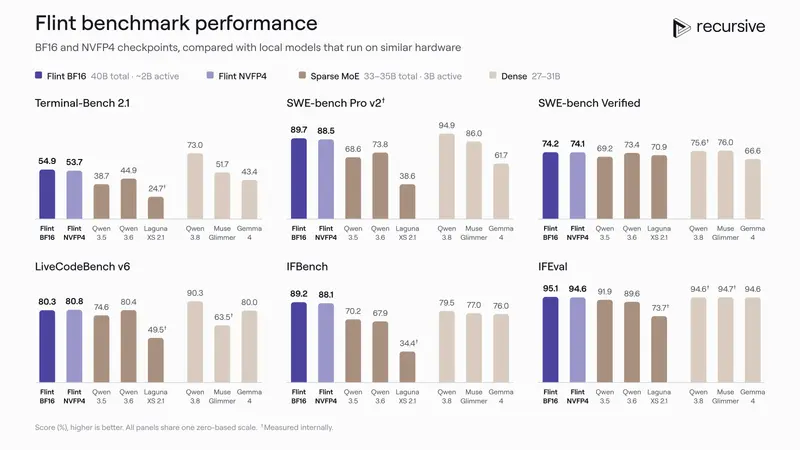
核心架构与性能表现
Flint 采用 MoE 架构,总参数量为 400 亿,但在处理任何给定任务时,每个 token 仅激活 25 亿参数。这种稀疏性使其能够轻松在普通笔记本电脑上运行,同时保持强大的编码能力。
在性能方面,Flint 在 SWE-Bench Verified、Terminal-Bench 2.1 等代理编码基准测试中,领先于所有总参数低于 500 亿的 MoE 模型,并匹敌 250 亿至 400 亿参数的密集模型。得益于优化的推理栈,其生成速度显著优于同类模型:
- 在搭载 Apple M4 Pro 芯片的 MacBook Pro 上,生成速度超过 125 token/秒(实测可达 131 token/秒),是 Gemma 4 或 Nemotron 3.5 Lightning 等模型的两倍。
- 在配备 64GB 显存的 NVIDIA RTX 显卡上,短上下文生成速度超过 150 token/秒。
Eureka Machine:AI 驱动的自动化研发
Flint 的诞生是 Recursive 长期愿景“递归自我改进”的一次成功验证。其自动化研究系统 Eureka Machine 深度参与了模型构建栈的几乎每一个环节:
- 架构搜索:系统探索了不同的专家配置和宽度,最终确定了 400B 总参数与 25B 激活参数的组合,以在本地硬件的吞吐量与编码性能之间取得最佳平衡。
- 量化策略:为缩小内存占用,Eureka Machine 采用了非常规的量化配方,将输出层(lm_head)量化为 4 位。为弥补精度损失,系统引入了离线蒸馏阶段,让量化模型在自发现的 coreset 上进行预采样训练。最终生成的 NVFP4 模型体积缩小了 71%,且在基准测试中的得分与 16 位模型相差不到 0.7 分。
- 内核优化:系统针对 Apple 芯片和 NVIDIA 硬件生成了专用的底层计算内核。例如,在 M4/M5 芯片上,它融合了解码前向传递的整个流程,生成了高效的 Metal 巨型内核。
本地部署与生态兼容
Flint 以 Apache 2.0 许可证在 Hugging Face 上开源。本地运行的特性使其具备数据隐私保护、离线可用以及零 API 成本的优势。
在生态兼容性上,Flint 支持主流的推理框架,包括 llama.cpp、Ollama、Unsloth、LM Studio、vLLM 和 SGLang。此外,Recursive 还发布了专属的轻量级推理引擎 rec,针对 M4 Pro 和 M5 Pro/Max 芯片进行了深度优化,用户可通过简单的设置快速启动。模型支持高达 512k token 的上下文窗口,但官方建议在 256k token 以内以获得最佳编码体验。
局限性与未来展望
尽管表现优异,Recursive 也坦诚指出了 Flint 的当前局限:在处理复杂任务时,它可能需要比大型闭源编码助手(如 Claude 或 Codex)更多的明确指导,建议开发者将大任务拆解为更小的子步骤。
从长远来看,Flint 只是 Recursive 宏伟蓝图的第一步。公司 CEO Richard Socher 表示,其最终目标是构建由人类监督、能够在出错时停止的完全递归自我改进的超级智能系统。随着 Flint 的发布,Recursive 证明了更有能力的模型可以反哺 Eureka Machine,使其成为更高效的研究员,从而以相同的成本更快地交付下一代更强大的 AI 模型。
© 版权声明
文章版权归作者所有,未经允许请勿转载。