记忆张量正式发布并开源了 MemT 1.0 记忆原生大模型。与目前主流的外挂式记忆方案不同,MemT 1.0 将记忆机制直接内化至模型的底层架构中。通过特定训练,模型能够自主完成记忆的读写、更新与调用,使经验积累成为模型计算过程的内在组成部分。
- GitHub:https://github.com/MemTensor/MemT-1.0
- 模型:https://huggingface.co/collections/MemTensor/memt-1
核心架构与运行机制
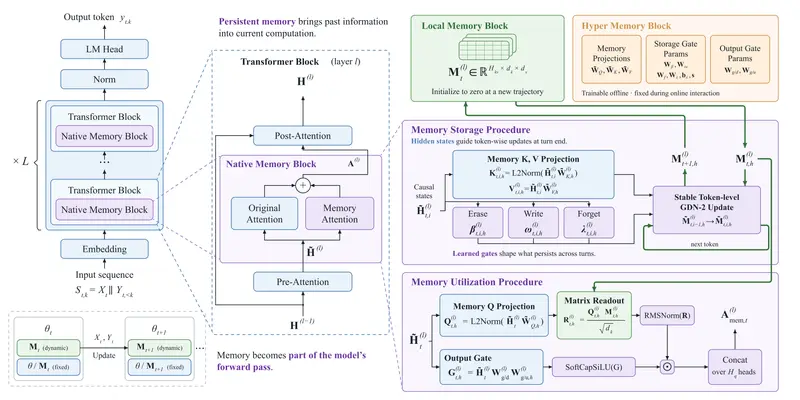
MemT 1.0 的核心在于原生记忆模块(Native Memory Block),该模块与骨干模型的注意力模块并行运行,主要包含两个组件:
- 局部记忆模块(Local Memory Block):维护一个动态的多通道记忆矩阵,在连续交互中不断演化。
- 超记忆模块(Hyper Memory Block):包含可训练的记忆 Query、Key 和 Value 投影,以及擦除门、写入门、遗忘门和输出门。
在生成过程中,记忆注意力从当前记忆状态中读取信息,经归一化和门控处理后,叠加至骨干模型的注意力输出上。每轮交互或片段结束时,Stable GDN-2 会执行 token 级别的记忆更新,生成供后续步骤使用的新状态。此外,模型引入了 Mixture-of-Storage (MoS) 机制以进一步扩展记忆容量。
这种设计带来了显著的工程优势。模型的持久状态大小保持恒定,当历史长度达到 128K 时,与保存完整上下文的传统 KV Cache 相比,存储开销可减少约 66 倍。持续交互仅刷新已有矩阵,长周期运行的边际成本趋于平缓。
模型规格与基准表现
本次开源包含两个规格的模型:
- MemT-1.0-Nano:基于 Qwen3.6-35B-A3B 骨干,总参数量 36B,激活参数量 3B,可训练记忆参数量 451M,动态记忆状态 10M。
- MemT-1.0-Flash:基于 DeepSeek-V4-Flash 骨干,总参数量 288B,激活参数量 17B,可训练记忆参数量 3.61B,动态记忆状态 336M。
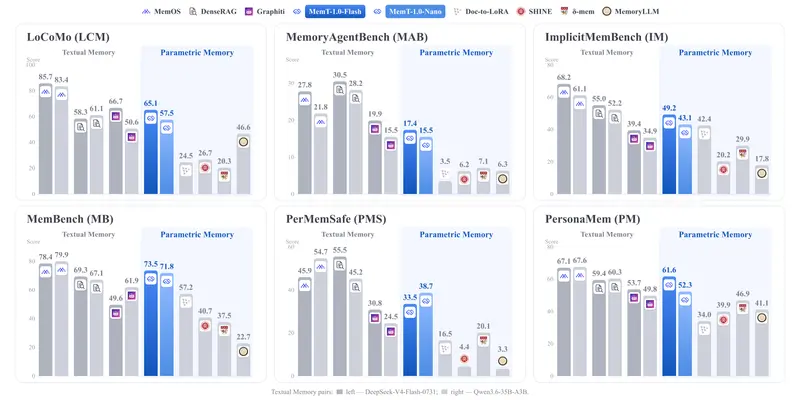
在 11 个记忆基准测试中,MemT-1.0-Flash 和 MemT-1.0-Nano 在已评测的参数化记忆方法中分别位列第一和第二。技术报告展示了一项针对性测试:在跨度 500 多轮、约 6.6 万 token 的聊天记录中,模型在完全脱离原始文本的“闭卷”状态下,准确报出了展览的原定与改期时间(周日),并清晰区分了未被采纳的周一备选方案,同时确认场地、票价和联系人信息未变。
经验引导的智能体编程应用
MemT 1.0 展示了一种在长程编程任务中复用程序性经验的智能体框架。检索到的经验被存入原生记忆,在执行过程中通过记忆注意力直接访问,无需将冗长的经验文本塞入任务上下文。
在 SWE-bench Verified 的 500 项任务实测中,团队验证了两种模式:
- 提前写入经验:在任务开始前将经验写入内部记忆状态。模型平均成功率从无经验的 66.07% 升至 69.33%,同一题目独立运行三次全部成功的比例从 54.00% 提升至 61.60%,表现与直接在上下文中注入文本经验的对照组相当。
- 实战动态触发:模型先独立执行任务,当系统检测到报错、空返回或连续无效操作时,当场将匹配的排错经验写入其内部记忆状态。这种按实时反馈更新记忆的机制,将平均成功率推高至 69.73%,三次全成率提升至 62.80%,均优于文本经验组。
在覆盖九种编程语言、包含 300 项任务的 SWE-bench Multilingual 测试中,采用实战动态触发机制后,Nano 模型的平均成功率从 60.00% 提升至 63.56%,三次全成率从 45.33% 跃升至 55.33%,同样优于文本经验对照组。
工程价值与应用前景
传统的短对话可以通过拉长上下文或挂载向量数据库来解决,但在长周期伴随场景中,推理延迟和显存开销会持续膨胀。MemT 1.0 通过固定体积的动态记忆状态,解决了这一扩展性瓶颈。
外部系统负责从业务反馈中提炼经验并捕捉异常信号,模型则依靠训练出的记忆原生读写能力,将这些规范内化为下一步的行动修正。这种协同机制为智能体走向自主持续演进提供了底层支撑,使其在跨月度跟进或长周期个性化服务中,能够基于历史交互沉淀出稳定的能力壁垒。
© 版权声明
文章版权归作者所有,未经允许请勿转载。