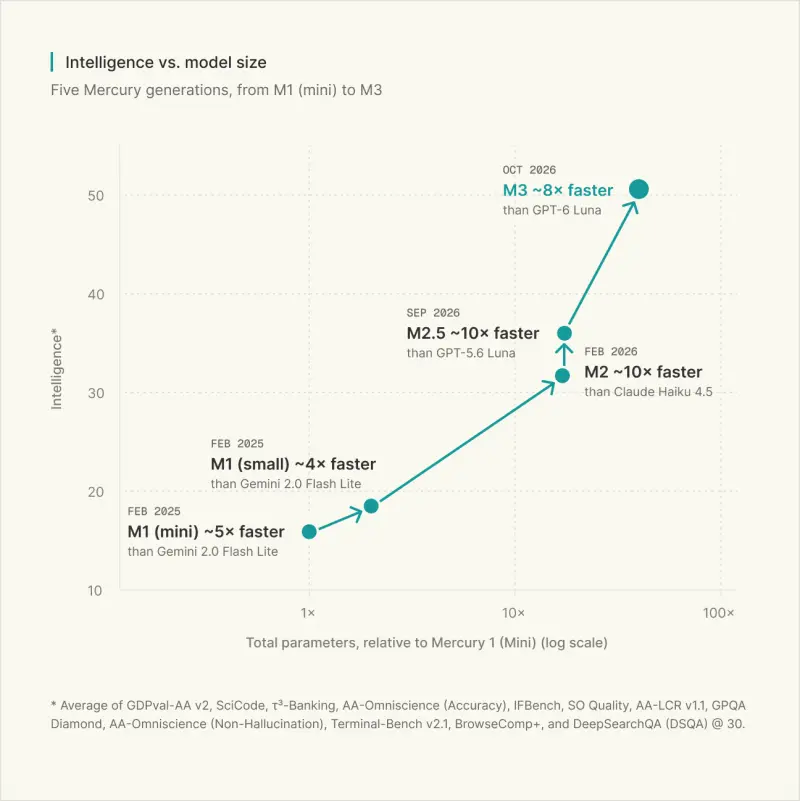
Inception 推出 Mercury 3,这是其目前能力最强的基于扩散架构的大语言模型。该模型在多项基准测试中表现优于 GPT-6 Luna 和 Claude Haiku 5.5,同时在 NVIDIA GPU 上实现了每秒 1068 个 token 的生成速度,比同类速度优化模型快 4 到 8 倍。
核心指标与定价
Mercury 3 的上下文窗口扩展至 100 万 token,较 Mercury 2.5 的 260K 有大幅提升。在定价方面,标准价格为每百万输入 token 0.20 美元,输出 0.70 美元。发布期间提供五折优惠,即输入 0.10 美元,输出 0.35 美元。此外,缓存 token 在输入价格基础上享受九折。
技术突破:验证扩散模型的扩展定律
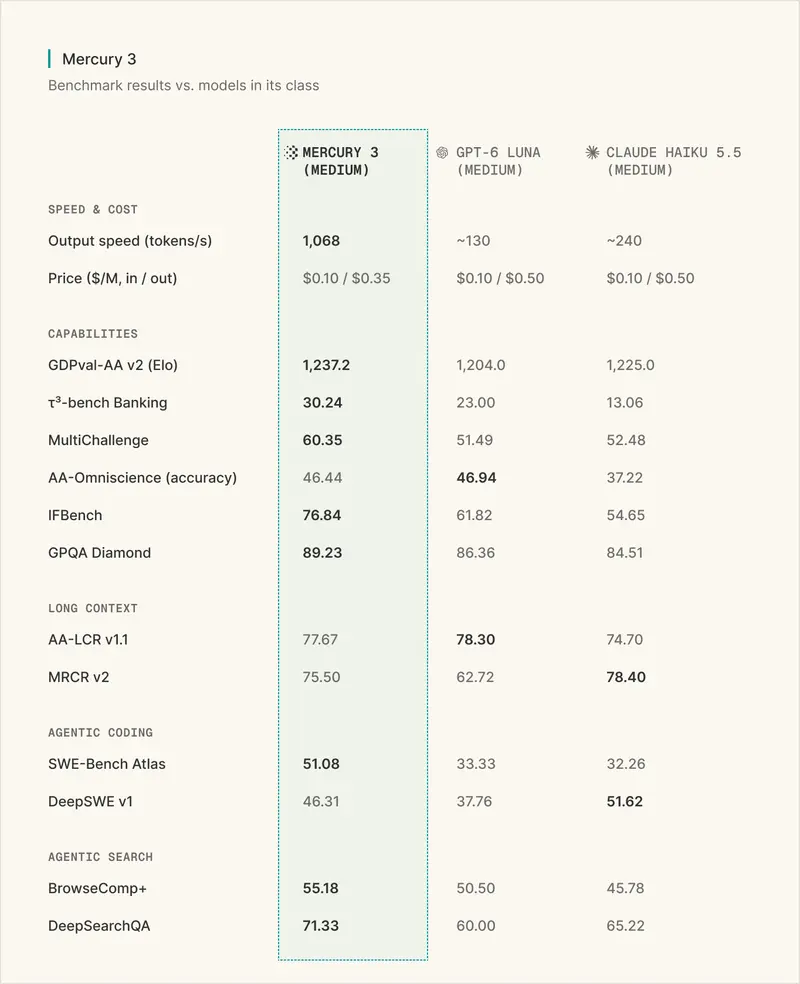
此前推出的 Mercury 1 曾作为扩散 LLM 商业化的初步验证。Mercury 3 的总参数量在此基础上扩大了 40 倍以上。在标准基准测试中,其智能水平较 Mercury 1 提升了 3 倍,且保持了同等的高推理速度。这一结果证实了驱动自回归模型发展的扩展定律,同样适用于扩散架构。
生产环境表现
早期访问合作伙伴已将 Mercury 3 部署于对延迟敏感的应用中,涵盖以下场景:
- 浏览器使用代理:TinyFish AI 联合创始人 Shuhao Zhang 指出,代理任务中每次传递的延迟会迅速累积。在 50 个实时 Mind2Web 导航任务测试中,Mercury 3 完成了其中 50% 的任务,完成率高于 GPT-6.1-Sol。在 token 消耗量和代理步骤相同的情况下,其每 token 成本大幅降低。
- 交互式教育:General Learning (RevisionDojo) 联合创始人兼 CTO Michael Tong 表示,Mercury 3 能在不牺牲推理质量的前提下提供即时反馈。提示处理、答案批改和概念定义通常在 1 秒内返回,可作为现有技术栈的直接替换方案,避免学生因等待而中断学习节奏。
- 实时搜索代理:Octen AI 创始人兼 CEO Kuan Zou 提到,在智能眼镜等对延迟敏感的设备上,Mercury 3 提供了速度与质量的最佳平衡。其 Sense API 测试显示,模型中位生成时间为 0.9 秒,端到端中位响应时间为 2.2 秒。
- 客户支持:Lorikeet 技术员工 Michael Gribben 补充,在跨语音、聊天和邮件的复杂企业礼宾服务中,Mercury 3 在早期测试中不仅降低了延迟,还在评估和生产环境中保持了更高的准确性。
实时产品组合与部署
Mercury 3 是 Inception 实时 AI 产品矩阵中的旗舰模型。该矩阵还包括:
- Mercury Voice:专为语音应用定制,重点优化极端低延迟和最小化首答案 token 时间(TTFAT),目前已接入 Audivi AI、Altur 和 OpenCall。
- Mercury Decide:面向高容量分类任务的决策模型,在 JevBench 和 LegalBench 基准测试中表现优于 Jev。
目前,Mercury 3 已通过 Inception API Platform 以及 OpenRouter、Baseten 和 Vercel 提供服务。它兼容 OpenAI API,支持无缝接入现有技术栈。针对企业级需求,平台还提供专用容量、自动扩展、合规控制及可配置的数据保留选项。
© 版权声明
文章版权归作者所有,未经允许请勿转载。