阿里巴巴正式推出 Qwen3.7-Max,这是面向智能体(Agent)时代的新一代旗舰模型。不同于传统大语言模型仅专注于对话或单次任务生成,Qwen3.7-Max 致力于成为全能的智能体基座,具备在跨越数百乃至数千步的长周期任务中持续自主执行、稳定推理的能力。
- 官方介绍:https://qwen.ai/blog?id=qwen3.7
- API:https://bailian.console.aliyun.com/
目前,Qwen3.7-Max 已通过 阿里云百炼 API 提供服务,并在编程智能体、办公自动化、复杂推理及跨框架泛化等多个维度展现了 SOTA(State-of-the-Art)级别的性能。
核心突破:长程自主执行的稳定性
Qwen3.7-Max 的最大亮点在于其持久的上下文连贯性和复杂的工具调用能力。它不再是“聊完即忘”的助手,而是能够独立规划、执行并修正长达数小时任务的智能伙伴。
实战案例:35小时自主优化 GPU Kernel
在一个极具挑战性的测试中,Qwen3.7-Max 被 tasked 优化 SGLang 中的 Extend Attention 算子,运行在从未见过的平头哥真武 M890 PPU 硬件上。
- 零先验知识:模型没有该硬件的性能分析数据或文档,仅凭任务描述和参考代码起步。
- 超长链路:在连续 35 小时 的执行中,模型完成了 432 次 Kernel 评估,跨越 1,158 次 工具调用。
- 自主迭代:模型自主编写、编译、性能分析、诊断错误并重构架构。
- 最终成果:相比官方 Triton 参考实现,实现了 10.0 倍 的几何平均加速比。且在最后几小时仍在发现实质性改进,证明了其长程优化的有效性。
- 对比优势:远超 GLM 5.1 (7.3x)、Kimi K2.6 (5.0x) 和 DeepSeek V4 Pro (3.3x)。其他模型多因无法继续进展而提前停止。
性能基准:全面领跑主流榜单
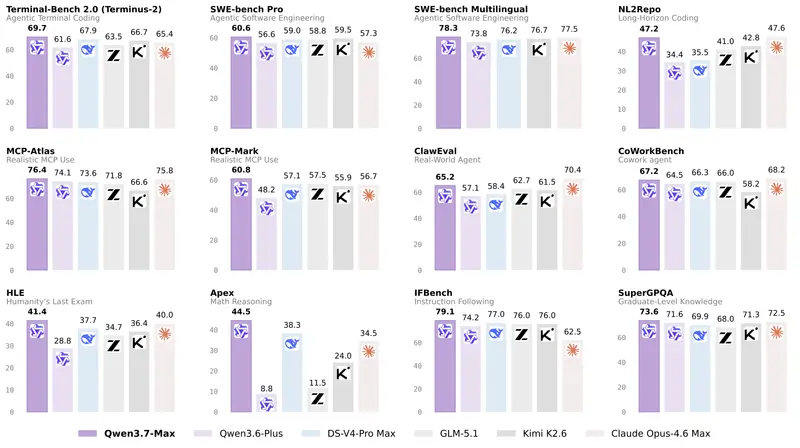
Qwen3.7-Max 在多个权威基准测试中取得了领先或持平顶尖水平的成绩:
1. 编程智能体
- SWE-Pro: 60.6
- SWE-Multilingual: 78.3
- Terminal Bench 2.0-Terminus: 69.7(超越 DS-V4-Pro Max 的 67.9)
- SWE-Verified: 80.4(与 Opus-4.6 Max 的 80.8 相当)
2. 通用智能体与办公自动化
- MCP-Mark: 60.8(优于 GLM-5.1 的 57.5)
- Skillsbench: 59.2(优于 K2.6 的 56.2)
- SpreadSheetBench-v1: 87.0(顶尖水平,展现强大的表格处理能力)
- Kernel Bench L3: 96% 的场景能写出有加速的 Kernel,中位数加速比 1.98 倍。
3. 高难度推理
- GPQA Diamond: 92.4(优于 Opus-4.6 的 91.3)
- HMMT 2026 Feb: 97.1(优于 Opus-4.6 的 96.2)
- IMOAnswerBench: 90.0(优于 DS-V4-Pro 的 89.8)
4. 多语言与指令遵循
- WMT24++: 85.8
- IFBench: 79.1(优于 DS-V4-Pro 的 77.0,展示精准的指令遵循)
技术革新:环境扩展与跨框架泛化
Qwen3.7-Max 的强大并非偶然,源于其在训练方法论上的根本性创新。
1. 环境扩展(Environment Scaling)
正如语言模型从多样化文本中获得泛化能力,Qwen3.7 通过大幅扩展智能体训练环境的质量与多样性,实现了能力的真正泛化。
- 可预测的提升:任意基准子集上的性能增益高度一致,证明模型学到的是通用解题策略,而非针对特定基准的过拟合。
- 域外泛化:所有评测基准均为训练中从未出现的全新环境,模型依然表现优异。
2. 跨框架泛化能力
通过解耦任务(Task)、运行框架(Harness)与验证器(Verifier),Qwen3.7-Max 接受了跨框架的强化学习训练。
- 不依赖捷径:模型被迫学习独立于特定框架的通用策略,而非记忆某一种 API 的调用方式。
- 广泛兼容:无论部署在 Claude Code、OpenClaw、Qwen Code 还是其他自定义框架下,均能稳定发挥出色性能。在 QwenClawBench 和 CoWorkBench 评测中,无论评估框架如何变化,性能均保持强劲一致。
应用场景:重塑企业级工作流
Qwen3.7-Max 原生适配主流智能体框架,能够承接高复杂度、高强度的企业级任务:
- 软件工程:支持从前端原型到复杂多文件工程的全流程开发。在 YC-Bench 模拟经营测试中,营收高达 2.08M 美元,是 Qwen3.6-Plus 的 2 倍,展现了跨上下文窗口的策略进化能力(如识别恶意客户、动态调整成本)。
- 办公自动化:通过 MCP 集成和多智能体协作,实现海量信息研读、复杂数据分析及出版级文档生成。以往需团队耗时一至两周的项目,现可由智能体在数小时内完成端到端交付。
- 自我监控与进化:在超过 80 小时的 RL 训练监控实验中,Qwen3.7-Max 自主构建了奖励作弊(Reward Hacking)监测体系,新增 13 条启发式规则,精准识别 1,618 个作弊案例,实现了作为软件工程智能体的持续自我提升。
© 版权声明
文章版权归作者所有,未经允许请勿转载。