月之暗面(Kimi)今天正式推出了 K3.1 系列的首个模型——Kimi K3.1 Pro。作为其迄今能力最强的模型,它拥有 3 万亿(3T)级参数,支持高达 100 万(1M)token 的上下文窗口,并在代码、3D 创作、金融研究及长程 Agent 能力上实现了显著突破。同步推出的 Kimi K3.1 Pro Highspeed 版本在保持同等智能水平的前提下,输出速度提升了约 2~3 倍。完整模型权重将于 11 月 4 日前正式开源。
- 官方介绍:https://mp.weixin.qq.com/s/Q6Z-skAUH_na9g37VWbHew
架构优化与长程能力跃升
Kimi K3.1 Pro 是 Kimi K3 的深度后训练版本。为支撑数百个下游领域的大规模联合训练,月之暗面全面优化了技术栈,包括 RL(强化学习)框架、长上下文推理、训练效率、沙箱基础设施及调度系统。这种大规模的 RL 算力投入,确保了模型在所有领域获得稳定且高效的性能回报。
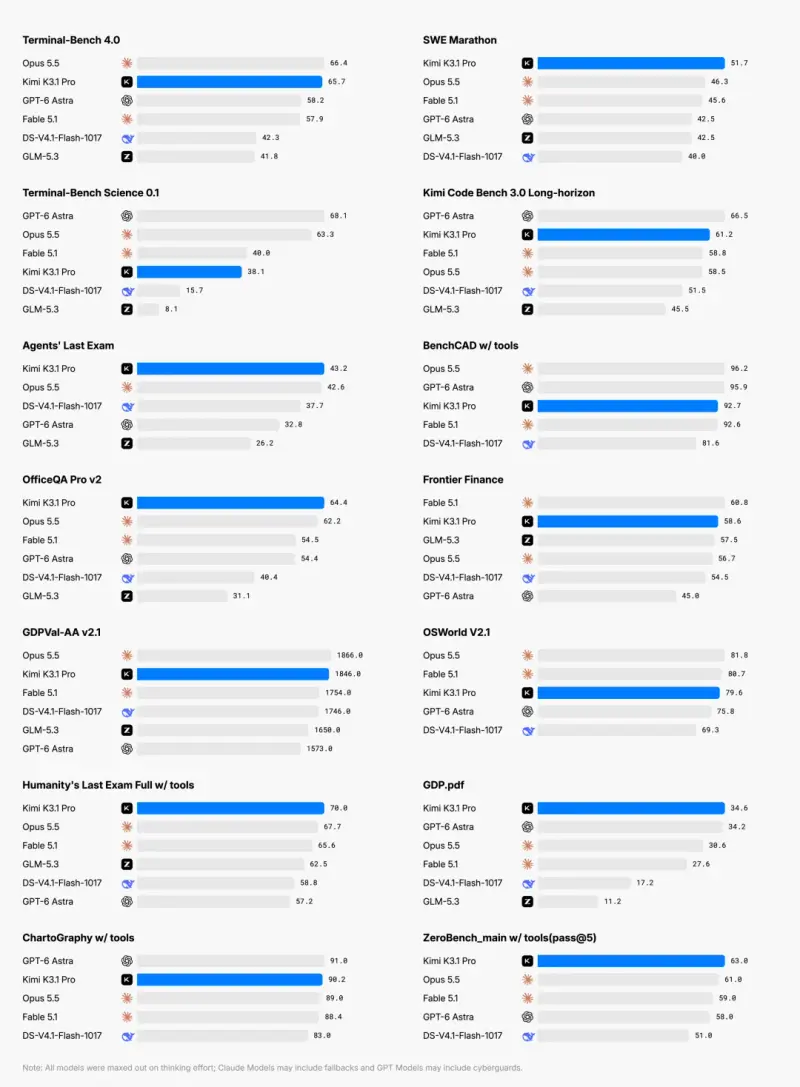
在多项权威及内部基准测试中,K3.1 Pro 展现出逼近顶尖闭源模型的实力:
- 代码与长程 Agent:在 Terminal-Bench 4.0(真实环境受限终端任务)中得分 65.7%,超越 GPT-6 Astra(58.2%),与 Claude Opus 5.5(66.4%)差距微弱。在内部 Kimi Code Bench 3.0 Long-horizon 中得分 61.2%,显著高于前代 K3 的 55.95%。
- 3D 创作与空间推理:在 BenchCAD 基准(通过生成 CAD 代码从多视角图重建 3D 模型)中得分 92.7%,接近 Claude Opus 5.5(96.2%)和 GPT-6 Astra(95.9%)。模型可直接编写并运行 Blender、CAD 等专业脚本,完成参数化建模与场景布局。
- 金融研究与分析:在 OfficeQA Pro v2(复杂财务数据分析)基准中取得 64.4 分的当前最优成绩(SoTA)。在内部测试中,Financial Modelling 提升 14%,Financial Research 提升 20%,Business Operation 得分约为前代的 4.2 倍。此外,在 Kimi Hallu Bench Hard 压力测试中,事实陈述错误率从 23.4% 大幅降至 8.3%。
克制的安全对齐与开放权重策略
随着模型能力的增强,月之暗面对网络安全的管控采取了主动且透明的策略。在训练过程中,团队识别到网络攻防相关内容会自然提升模型的漏洞研究性能。为降低潜在滥用风险,在准备发布开放权重版本时,月之暗面从中期训练和强化学习两个阶段均识别并移除了网络攻防相关数据,同时保留了保障通用实用性所需的编程任务。
评估结果显示,在自研的 xdev-bench-hard(基于真实漏洞的利用任务)基准中,未过滤数据的模型 pass@3 得分为 90.5%,而最终版 K3.1 Pro 得分降至 81.0%。这一得分仍较前代有大幅提升(得益于通用编程和调试能力的泛化),但明确低于已发布的前沿闭源模型。月之暗面表示,渐进式开放此类具备“两用”能力的权重,有助于更多团队在可控的基础设施上审查自身代码(尤其是遗留系统),从而从防御角度提升整体软件生态的安全性。
全场景生态接入与定价
Kimi K3.1 Pro 现已通过多渠道全面开放:
- 个人与桌面端:可通过 kimi.com、最新版 Kimi App(支持 iOS、Android、鸿蒙)、Kimi Work 桌面客户端(Windows/macOS)以及 Kimi Code 终端工具直接使用。Kimi.com 及 App 已同步上线“3D Make”功能,支持在线预览、编辑及导出 3D 模型。
- 开发者 API:在 Kimi 开放平台(platform.kimi.com)接入,
kimi-k3.1-pro定价为:输入 1.3 元/百万 Token(命中缓存)或 13 元/百万 Token(未命中缓存),输出 68 元/百万 Token。高速版kimi-k3.1-pro-highspeed价格为标准版的 2 倍。 - 企业与托管服务:Kimi 企业版提供严格的数据隐私保护与账号隔离。同时推出的 Kimi Hosted Agents(托管智能体)将 Agent 运行 Harness 作为云端服务提供,支持 7×24 小时长程任务执行与多智能体协作,免除开发者自行维护运行框架的负担。
Kimi K3.1 Pro 的发布,不仅展示了国产大模型在长上下文推理、复杂多步 Agent 任务及专业垂直领域(如 3D、金融)的顶尖水平,其负责任的开源策略也为行业提供了兼顾能力演进与安全可控的范本。
© 版权声明
文章版权归作者所有,未经允许请勿转载。