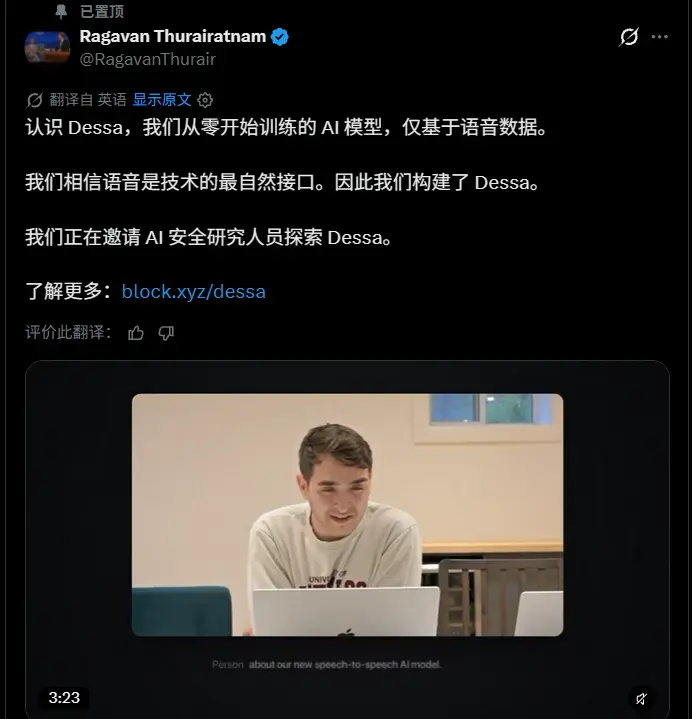
Jack Dorsey 旗下的金融科技公司 Block 今天宣布推出了一款名为 Dessa 的全新 AI 模型。该模型由 Block 内部一个由前多伦多深度学习初创公司 Dessa 成员组成的小型 AI 研究实验室开发,其最大亮点在于:这是一个完全从头开始在人类对话语音上训练的“纯语音到语音”(Audio-to-Audio)模型,彻底摒弃了传统的文本中转环节。
- 官方介绍:https://block.xyz/dessa
核心技术突破:真正的语音原生交互
Dessa 的设计旨在解决当前语音 AI 将声音“压平”为文本从而丢失大量非语言信息的痛点。其核心技术特性包括:
- 纯语音训练(Audio-only Training):Dessa 没有使用任何文本数据或预训练的文本大语言模型(LLM)。它像婴儿学习说话一样,仅通过聆听真实的人类对话来学习语言、口音、停顿、呼吸、讽刺、幽默以及情感语调。
- 真正双工(Duplex)能力:模型能够同时聆听和说话,支持自然的插话和实时反馈(如“yeah!”、“got it!”)。其推理速度快于实时,消除了传统语音 AI 中常见的尴尬等待延迟。
- 情感与副语言感知:Dessa 能够原生理解并生成笑声、沮丧的叹息、因悲伤而破裂的声音等细微差别。例如,当用户要求它大声说话时,它会自然地提高音量;它甚至能在句子中间自然地笑,而非像传统模型那样在提示结束后机械地笑。
- 高效的本地部署:尽管处理高维度的音频数据极具挑战性,Dessa 经过优化后,已能够在 MacBook Pro M4 Max 或更高配置的设备上进行本地运行,无需依赖云端。
研发动机:好奇心、人机理解与 AI 安全
Block 团队阐述了开发 Dessa 的三个核心动机:
- 好奇心与探索:验证模型是否能像人类婴儿一样,在从未见过书面文字的情况下,仅凭听觉学会复杂的语言和对话规则。
- 改善人机理解:语音是与任何智能体交互最自然的接口。Dessa 旨在恢复被文本化过程所丢弃的丰富语境和情感维度。
- 提升 AI 安全:随着 AI 获得更多自主权,无法感知用户声音中的情感(如极度痛苦或紧急状况)构成了潜在的安全风险。Dessa 旨在通过原生理解声音情感,迈出修复这一盲区的重要一步。
当前状态与访问限制
由于纯语音模型代表了一个全新的深度学习范式,其行为模式和潜在风险尚未经过广泛验证。Block 团队明确表示,目前 Dessa 仅向一小群经过筛选的 AI 安全研究人员提供早期访问权限。此举旨在借助外部专家的力量,发现和评估该模型在现实应用中可能存在的、开发团队未预料到的风险。
Dessa 的出现为语音 AI 的发展提供了一条截然不同的技术路径。它证明了在不依赖海量文本数据的情况下,模型依然能够掌握复杂的语言交互与情感表达,为未来构建更具同理心和响应能力的智能体奠定了基础。
© 版权声明
文章版权归作者所有,未经允许请勿转载。