Liquid AI 正式发布 d1,一款面向结构化选择而非文本生成的决策模型。输入上下文与自定义类型问题,模型在单次API调用内输出校准后的概率,输出token数量为0。目标承接原本交给通用大模型处理的固定选项任务:分类、工单路由、内容审核、打分、重排序、LLM裁判评估等场景。
- 模型页面: https://docs.liquid.ai/lfm/models/decision-models
- 使用指南: https://docs.liquid.ai/guides/decision-model-guide
- GitHub: https://github.com/Liquid4All/cookbook/tree/main/examples/road-decider
d1现已上线托管API,模型标识d1:free;仅支持线上API调用,不提供GGUF、MLX、ONNX权重,无法本地自托管,不支持微调。
10月6日更新:
Liquid AI正式推出带视觉能力的d1决策模型,这是该团队首款决策模型,支持纯文本、图像或者图文混合输入。
d1和传统大语言模型完全不是一类设计:它不逐词生成文本,一次前向传播直接输出判定概率,输出Token数量为0。纯文本类决策任务延迟仅200~300ms,速度极快。
Liquid在六项真实场景任务中将d1和GPT-6.1 Sol、Claude Opus 5.5做对照测试,场景包含工单过滤、电路板质检等;d1在其中四项任务持平或超越GPT-6.1 Sol。成本优势突出,价格比GPT-6.1 Sol、Claude Opus 5.5低19倍至200倍,所有任务响应速度都更快。
核心能力
- 结构化决策输出
支持三类判定问题:是/否、多选项选择、打分评估,直接返回校准后的概率值,适合工单分流、内容审核、路由判定、模型打分这类任务。
- 视觉质检
可直接读取摄像头图片完成零部件检测,VisA数据集四类检测任务(电路板、蜡烛、腰果、口香糖)准确率达到85%~97%。无需针对任务做专项微调,只依靠简短任务描述就能识别缺陷。
- 游戏画面视觉决策
直接读取游戏截图,输出下一步动作:
- 俄罗斯方块:屏幕视觉输入后,消除行数从70提升至81
- Wordle:12局全部通关,平均仅需3.8次猜测;直接读取截图棋盘,不需要额外导出文本棋盘信息
什么是决策模型
决策模型基于给定信息,从调用前预先定义的候选集合中输出类型化判断,不会生成文本,接口返回usage.output_tokens始终为0。
官方迁移指南给出划分原则:答案属于有限已知选项集合,选用决策模型;需要拼接生成全新字符串,继续使用传统生成式LLM。
三大基础原语:Noul、Choice、Score
- Noul:是非类判断,返回0~1概率值。例如判断消息是否投诉,输出0.999。
- Choice:从候选列表挑选结果,输出最优选项、完整概率分布与置信度。如账单重复扣费工单,匹配billing分类置信0.9997。
- Score:在有序评分标尺上打分,返回概率加权分值,索引从0开始。4级紧急度标准范围0~3,生产中断场景可输出2.9995。
单次请求能够混合多种原语,模型在一轮调用并行评估全部问题。
d1 API调用逻辑
请求由模型标识、状态(纯文本/JSON)、问题三部分组成,接口地址:POST [https://api.liquid.ai/decisions/v1/systemone](https://api.liquid.ai/decisions/v1/systemone)
密钥在console.liquid.ai获取,以liquid_开头;配套SDK为TypeSafe AI的typesafe-sdk(Python)与@typesafe-ai/sdk(TypeScript)。
from typesafe_sdk import TypeSafeClient, Noul
client = TypeSafeClient(api_key=os.environ["LIQUID_API_KEY"],
                        base_url="[https://api.liquid.ai](https://api.liquid.ai)")
result = client.system_one(
    model="d1:free",
    state="I have been waiting over three weeks for my order...",
    questions={"is_complaint": Noul(
        instructions="Is this message a complaint from the customer?")},
)
print(result.answers["is_complaint"].noul)  # 0.999
相比带结构化输出LLM的核心优势
- 不计输出token费用:传统LLM哪怕仅输出单个标签,也要收取输出token费用;
- 延迟稳定:不存在逐token解码,延迟不会随输出长度增加;
- 无Schema解析错误:输出严格匹配定义类型,消除畸形JSON、重试开销;
- 输出不确定性信息:返回校准概率,不是模型自报的置信数字;
- 减少接口轮次:多个串行分类任务合并单次调用。
概率输出方便设置分层阈值:例如内容审核,0.8以上直接拦截、0.2以下放行,中间区间流转人工复核;工单路由在置信度低于0.5时,降级使用更强的生成大模型兜底。
同时同一输入重复评估结果一致性更高,减少裁决翻转问题。
适用边界:摘要、文案起草、多轮对话、代码生成、复杂长链推理,依然交给生成式LLM。
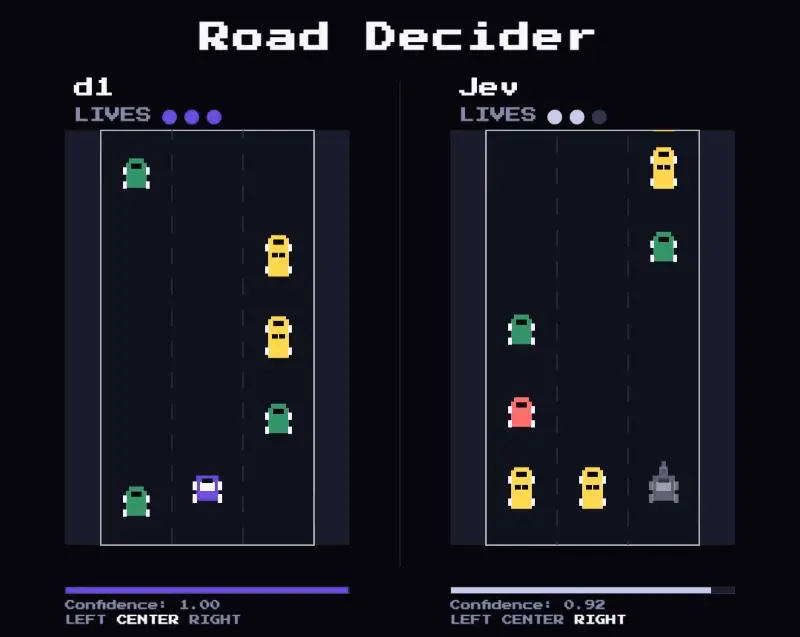
Demo:Road Decider像素赛车演示
Liquid提供road-decider示例项目,像素风生存赛车游戏。d1通过Choice任务选择左/中/右车道,每帧决策2~5次每秒。基于Node.js18+原生JS,Vite代理保护API密钥。内置对战模式,d1可与TypeSafe Jev 1.13在OpenRouter上竞速。实践发现,传入车道障碍物距离摘要,比原始道路网格图像,决策置信度更高。
竞品横向对比
| 特性 | Liquid AI d1 | TypeSafe Jev 1.13 | Convai Laya | AutoTrust JEV-27B |
|---|---|---|---|---|
| 访问方式 | Liquid托管API | OpenRouter API | 开放权重 | 开放权重 |
| 基础原语 | Noul、Choice、Score | Noul、Choice、Score | Noul、Choice、Score | 布尔、2~16选、0-5分打分 |
| 输出token | 0 | 0,输出不计费 | 0(编码器) | 决策0,也支持文本生成 |
| 上下文窗口 | 未公布 | 32K tokens | 英文512,多语言1024 | 4096 tokens |
| 模型规模 | 未披露 | 未披露 | 英文421M,多语言322M | 27B骨干,108.9M可训练参数 |
| 定价 | d1:free免费层;付费价格暂未公开 | 每百万输入token $0.042 | 自托管 | 自托管 |
| 开源许可 | 仅托管API | 托管API | Apache 2.0 | Apache 2.0 |
| 微调 | 不支持 | 文档未说明 | 支持 | LoRA微调 |
| SDK | Python/TS TypeSafe SDK | TypeSafe SDK、OpenRouter SDK | Hugging Face | Hugging Face |
数据采集时间:2026-09-29,查阅各厂商官网。
核心要点总结
- d1为决策模型,输出带校准概率,输出token等于0;
- Noul、Choice、Score三类原语,覆盖绝大多数有限选项判定任务;
- 当前可使用
d1:freeAPI,无模型权重,无法本地部署; - 最佳场景:工单路由、内容审核、分类、重排序、替代LLM裁判;
- 生成写作、聊天、多步复杂推理场景,继续使用生成式大模型。
© 版权声明
文章版权归作者所有,未经允许请勿转载。