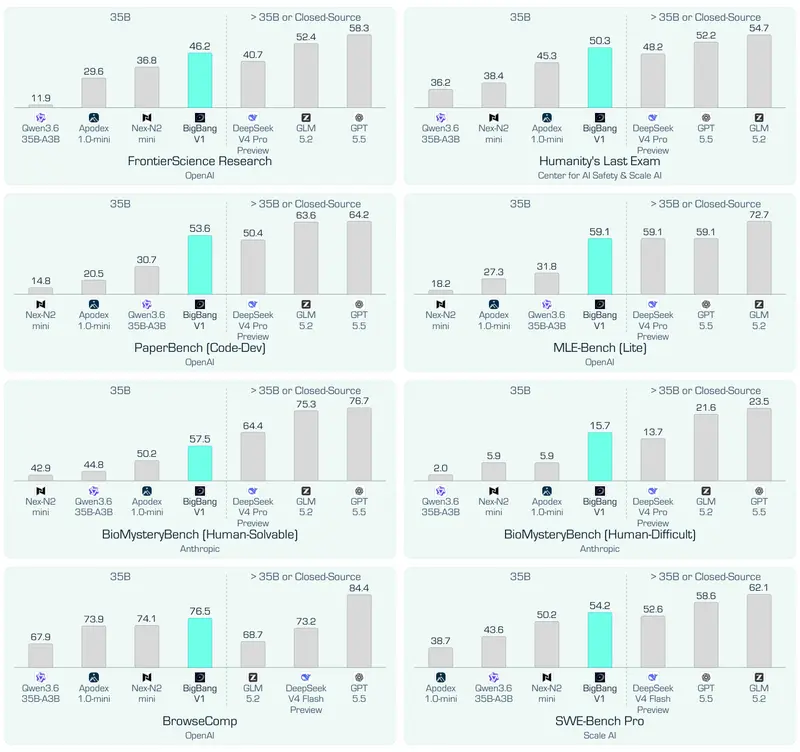
NaiveAI正式推出 Naive-N0.5-Flash,一款面向代码编写、AI模型研发的开放权重MoE大模型。它最大亮点在于由AI参与完成模型架构探索、训练调优与推理系统迭代,人类研究员只负责方向设定、约束定义与关键决策,走向递归自我改进(RSI)的技术路线。
- GitHub:https://github.com/NaiveAI-Labs/Naive-N0.5-Flash
- 模型:https://huggingface.co/NaiveAI/Naive-N0.5-Flash
模型基础概况
Naive-N0.5-Flash总参数309B,激活参数量15.5B,基于MiMo-V2.5底座改造。
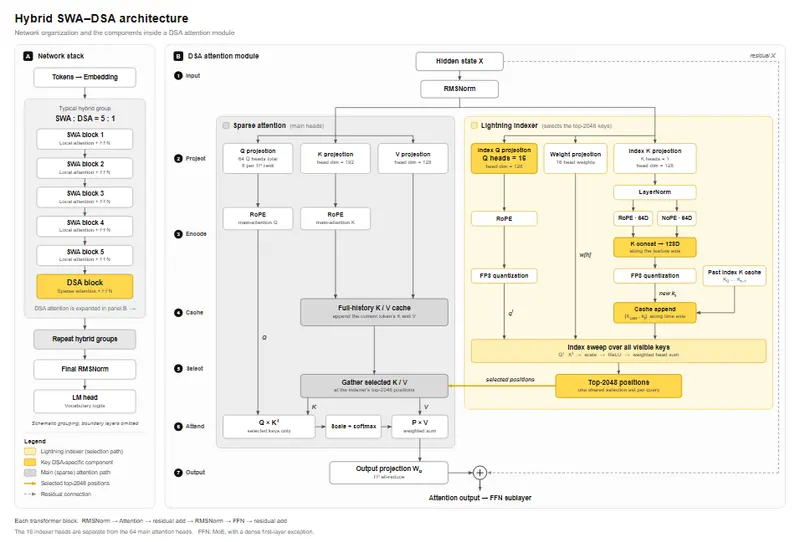
采用SWA滑动窗口注意力 + DSA稀疏注意力混合架构,全程无全注意力层,原生支持1M上下文窗口。
推理配套自研NaiveRT推理引擎,融合mega-kernel融合、程序化依赖启动、投机解码:标准模式50 tokens/s,Ultrafast极速模式最高可达 2000 tokens/s。
核心特性
- 混合稀疏注意力设计
整体采用5:1的SWA-DSA布局,网络分为8个六层模块。大部分层使用128token窗口滑动窗口注意力,少量层替换为DSA稀疏注意力;索引器对全部历史打分,骨干仅选取top2048 token做注意力计算,大幅降低长上下文算力与内存开销。同时以GQA4替代原有MLA实现,降低部署成本。
- 训练流程
架构改造后完成合计3.25T token多阶段训练:50B token索引器预热、3T token稀疏注意力主训练、200B token学习率衰减收尾,专门强化编码与AI研发相关能力。
- 开放协议与API定价
模型权重、推理代码采用MIT许可证开放。
API收费:输入 $0.10 /百万token,输出 $0.40 /百万token,缓存读取 $0.01 /百万token。
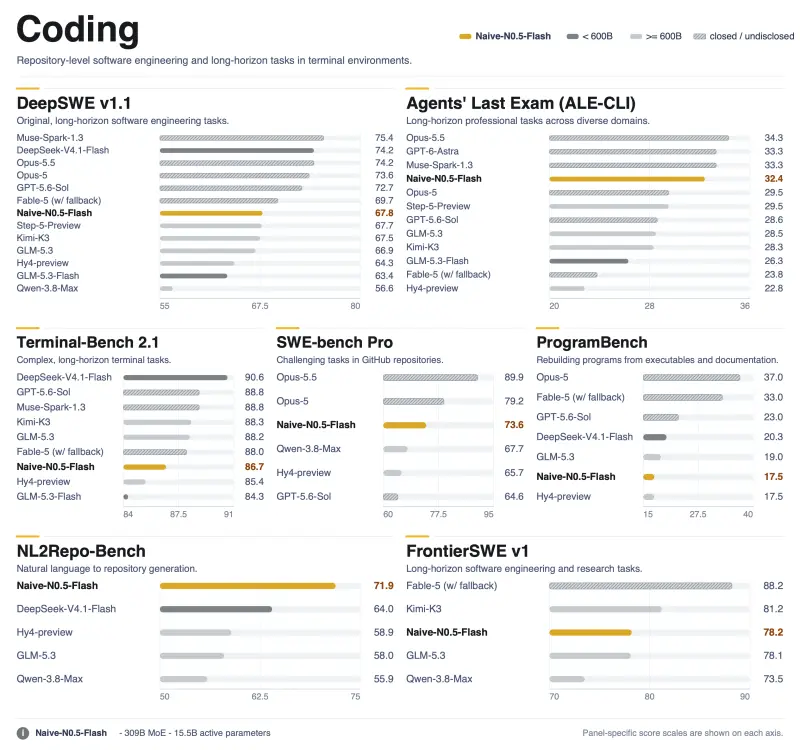
NaiveAI的AI驱动研发体系
NaiveAI搭建生产级基础设施,给AI模型提供沙箱环境与GPU访问权限。系统每周承载近千万沙箱任务,峰值同时运行10万个活跃沙箱,统一管控计算资源、运行环境、工具调用与安全权限。
整套模型的架构探索、训练实验、结果分析迭代都由AI承担,人类聚焦方向把控与关键决策,这套体系也用于训练Naive-N0.5-Flash本身,让模型可以直接参与大模型研发工作。
© 版权声明
文章版权归作者所有,未经允许请勿转载。