JetBrains 正式推出 Mellum2.1,一款专为编码代理、轻量子代理打造的开源MoE思考模型。它延续Mellum2原有架构,总参数量12B,每token激活2.5B参数,采用Apache 2.0许可证,已发布在Hugging Face。本次升级没有改动模型架构,性能提升几乎全部来自真实软件沙盒环境下的强化学习训练,模型可以自主探索代码仓库、修改文件并校验自己的代码改动。
- 模型:https://huggingface.co/collections/JetBrains/mellum21
训练升级要点
本次迭代重心全部放在后训练阶段,强化学习从简短收尾环节变成训练核心:
- 扩充任务集:新增数学、竞技编程、科学推理、工具调用、软件工程类RL任务,融合公开数据集与自研任务;同时严格过滤脏数据,剔除无效测试、无法验证或者难度不适配的样本。
- 真实仓库沙盒训练:搭建大规模训练基础设施,在数千个环境中启动数百万次沙盒运行。模型可调用Shell、文件编辑工具,代码测试通过即可获得奖励,训练更贴近真实开发场景。
模型基础规格
- 架构:28层,64个专家,每次激活8个专家;分组查询注意力,每4层中3层使用1024 token滑动窗口
- 上下文:131072 token,词表98304
- 权重:bfloat16发布;GGUF量化版本最低7GB,推荐Q4_K_M(8.1GB),适配llama.cpp、Ollama、LM Studio本地运行
- 推理服务:支持vLLM、SGLang,在单张NVIDIA H200上完成速度测试
基准表现(JetBrains自测,统一评估流水线)
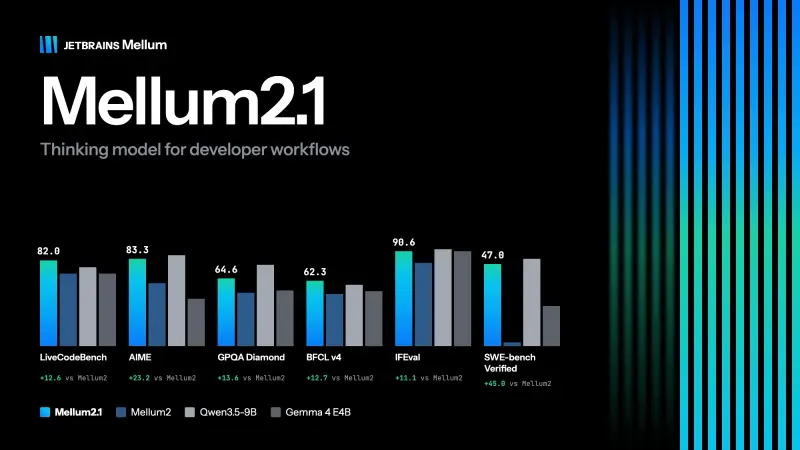
对比Mellum2,Mellum2.1在17项基准中的15项取得提升,代理编码能力提升最为惊人:
- SWE-bench Verified:从2.0提升至47.0;SWE-bench Pro从0.0提升至28.0
- LiveCodeBench v6达到82.0,超过Qwen3.5-9B(75.4)与Gemma4 E4B(69.4)
- BFCL v4 62.3分,同样优于对照组
短板方面,Terminal-Bench 2.1得分17.4,低于Qwen3.5-9B的21.7;GPQA Diamond、AIME数学推理任务,Qwen3.5-9B依旧领先。
安全性同步优化,HarmBench分数由21.5下降至8.5(分数越低安全性越好)。
推理速度
架构不变,推理速度与Mellum2持平。在H200高负载场景,token吞吐约为Qwen3.5-9B的2倍;借助MTP多token预测,单请求速度提升约1.6倍,vLLM推测解码的MTP头即将上线。
本地部署配置
vLLM部署基础命令需指定推理解析器,启用工具调用需要额外参数;推荐参数:temperature 0.6、top_p 0.95、top_k 20。
GGUF量化版本:
- MXFP4_MOE:7.0GB
- Q4_K_M:8.1GB(推荐)
- Q6_K:10.9GB
- Q8_0:12.9GB
- BF16原版:24.3GB
横向对比
| 特性 | Mellum2.1 | Mellum2 Thinking | Qwen3.5-9B | Gemma 4 E4B |
|---|---|---|---|---|
| 架构 | MoE 64专家,8个激活 | MoE同2.1 | 混合Gated DeltaNet | 密集模型 |
| 总参数 | 12B | 12B | 9B | 8B |
| 活跃参数 | 2.5B | 2.5B | 9B | 4.5B |
| 上下文 | 131072 | 131072 | 262144 | 128K |
| 许可证 | Apache 2.0 | Apache 2.0 | Apache 2.0 | Apache 2.0 |
注:不同厂商评估流水线会带来分数差异,Qwen官方模型卡的成绩与JetBrains测试结果并不一致。
要点小结
- 定位:JetBrains Mellum2.1,12B MoE思考模型,面向本地编码代理与子代理,Apache2.0开源。
- 核心提升:依托真实代码仓库沙盒强化学习,SWE-bench Verified大幅上涨,仓库级代码修改能力显著增强。
- 强弱项:代码生成LiveCodeBench表现突出;复杂终端任务、数学推理略逊于Qwen3.5-9B。
- 本地友好:GGUF量化最低7GB,普通消费级GPU即可搭建自托管编码代理。
- 性能:H200上吞吐接近Qwen3.5-9B两倍,安全性相比前代大幅改善。
© 版权声明
文章版权归作者所有,未经允许请勿转载。