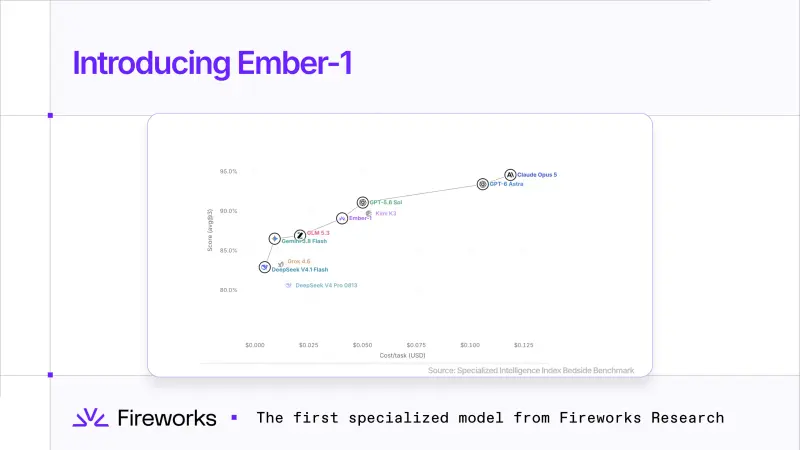
Fireworks AI发布Ember-1,由Fireworks Research基于月之暗面开源权重Kimi K3做后训练得到。核心目标:压缩推理轨迹,在基本维持任务准确率的同时,整体token用量减少约40%。
- 地址:https://fireworks.ai/models/fireworks/ember-1
注意:这和直接调低模型推理努力参数不是一回事。调低推理努力会明显损失效果;Ember-1是通过专项训练,让模型学会自动剔除冗余思考循环,保留必要的自省推理步骤。
背景:推理模型的token开销痛点
Kimi K3这类推理模型,生成内容中超90%token都消耗在内部思考过程。在Agent多轮任务场景下,成本会持续放大:每一轮对话都会把上一轮长长的推理文本继续塞进上下文,token数量随轮次近似二次增长,计费也随之叠加。
很多客户想要K3强大的编码能力,但难以承受高额开销,直接降推理努力又会掉精度,因此Fireworks选择通过后训练改造模型本身。
训练思路
训练集覆盖数学、编码、指令遵循、对话、搜索、工具调用、软件工程,包含独立问题与长多步交互任务,借助环境反馈做on-policy规划学习。项目累计跑了50+训练实验,200+评估,配套自研新训练算法暂未公开。训练使用Fireworks自有数据,不会使用客户业务数据。
基准测试对比
Fireworks在三档推理努力设置下,把Ember-1和原版Kimi K3做对照:
| 基准 | Ember-1 | K3 Max | 效果变化 | 成本降幅 |
|---|---|---|---|---|
| Terminal Bench 2.1 | 82.0% | 80.9% | 超越 | -51.9% |
| SWE-bench Verified | 92.2% | 93.2% | 小幅回落 | -15.5% |
| SWE-Interact | 20.0% | 21.3% | 小幅回落 | -32.5% |
| DeepSWE 1.1 | 75.2% | 66.4% | 明显超越 | -23.7% |
| τ-2 Bench Airline | 66% | 64% | 小幅超越 | -5.9% |
在7个基准与两家客户真实业务流量测试中,推理token压缩区间为35%~50%,整体精度基本持平。在医生验证的临床案例集Bedside Bench上,Ember-1打出新的成本-效果帕累托最优结果。
生产环境A/B测试
针对编码业务负载,两家客户上线对照实验:
- 单任务输出token:49.3K → 29.9K
- 推理token下降71.3%,总token下降39%
- 任务得分:Ember-1 0.753,原版K3 0.751,性能几乎不变
- 平均执行步数由23.8降至21.4
Ember-1计费单价沿用Kimi K3标准:输入 $3.00 /M tokens,缓存输入 $0.30 /M tokens,输出 $15.00 /M tokens。成本节约不是降价,而是模型生成更少token。
部署限制
当前仅作为研究预览,只能通过Fireworks无服务器API调用,模型权重、训练代码、完整训练算法均未对外发布,暂不支持本地自托管。
核心要点汇总
- Ember-1是Kimi K3的后训练版本,通过训练精简推理路径,并非调低推理强度。
- 整体token减少约40%,大量场景维持原有能力,部分编码基准超过原版K3 Max。
- 生产A/B验证:推理token降幅71.3%,任务质量几乎无损失。
- 仅API预览,权重不开放,计费单价同Kimi K3。
© 版权声明
文章版权归作者所有,未经允许请勿转载。