11 月 10 日,谷歌正式向付费开发者、企业、科学家及 Google AI Ultra 订阅用户开放 Gemini 4 Carbon。作为谷歌目前能力最强的模型,Carbon 专为测试模型智能极限的任务而构建,如复杂的多步编码与调试、开放式科学研究、深度数据分析及安全审计。相比之下,此前发布的 Gemini 4 Argon 仍被定位为大多数日常软件工程和知识工作的首选。
可用性与定价策略
Gemini 4 Carbon 的访问权限与定价根据用户群体进行了明确划分:
- 开发者与 API 调用
- 渠道:通过 Google AI Studio 和 Android Studio 的 Gemini API 付费层级调用,模型标识为
gemini-4-carbon。免费层级不提供该模型。 - 定价:11 月 30 日前为引入价,输入 $2 / 百万 Token,输出 $10 / 百万 Token。自 12 月 1 日起,价格将翻倍至输入 $4 / 百万 Token,输出 $20 / 百万 Token。
- 注:官方文档指出,Carbon 每轮思考消耗的 Token 多于 Argon,响应时间更长,因此同一任务的实际账单成本可能更高。
- 渠道:通过 Google AI Studio 和 Android Studio 的 Gemini API 付费层级调用,模型标识为
- 消费者订阅 (Google AI Ultra)
- 用户需订阅 Google AI Ultra 方可在 Gemini App、搜索 AI 模式及 Antigravity 中使用。
- 档位:$99.99/月(用量为 Pro 的 5 倍)或 $199.99/月(用量为 Pro 的 20 倍)。
- 限制:$19.99/月的 Pro 套餐不支持 Carbon,其能使用的最强模型仍为 Argon。
- 企业与科研机构
- 企业:可通过 Gemini for Business 的 API 或模型下拉菜单访问。
- 科研计划:10,000 名入选科学家可在 Google Antigravity 的最高用量档免费访问 Argon 和 Carbon 六个月(滚动入职)。
- 网络安全专项 (Carbon for cyber)
- 移除了常规网络安全护栏的专属版本,仅限通过审查的团队通过 “Fairwind” 计划申请访问。
核心能力与工程应用
Carbon 在多个专业领域展现了显著的深度推理与执行能力:
- 高精度知识工作与数据分析:结合前沿视觉理解与详尽检索,能够处理包含图表、蓝图和表格的密集文档。在 Hebbia 的 E2E 金融智能体评估及 Balyasny Asset Management 的 General Financial Intelligence 基准中表现优异,能生成严格符合模式的电子表格与报告。
- 改进的智能体编码与全栈开发:在 Web 应用开发中,Carbon 能够运行构建与验证循环,不仅检查代码,还会审查页面实际渲染的 UI,从错误中自动恢复并迭代,直至交付完整可运行的应用程序。此能力同样延伸至 3D 游戏开发与创意编码。
- 前沿网络安全能力:在 Project Fortify 内部基准中,Carbon 实现了 100% 的扫描召回率和 95% 的分类精确率。在开源代码库测试中,其漏洞召回率较 Argon 提升了 25% 以上。谷歌云漏洞研究 (CVR) 团队已利用其成功证明并修补了流行开源软件中的 0-day 漏洞。
- 科学与数学推理:
- 形式验证:配合 AlphaProof Code 框架,Carbon 能在 Lean 语言中生成数百万行代码,在数周内完成 Signal 加密协议底层代码的数学定理证明。
- 实验数据分析:能通过分析原始实验室数据,诊断出微弱的实验伪影(如微孔板混合不均),显著提升实验可重复性。
- 蛋白质结构预测:在多智能体设置下,自主在 PB 级未注释序列档案中检索远程同源物,在 CASP17 盲测集的低同源蛋白质家族中,将检索到的同源物数量平均增加 40 倍。
新特性:Antigravity /swarm 多智能体协同
谷歌在 Antigravity 中预览了 /swarm 命令,允许用户通过单一提示拉起一个协调的智能体团队:
- 任务拆分与分配:协调员(Coordinator)将任务拆分为互不冲突的模块(如按文件或包划分),并为每个模块分配专属 Agent(如
@parser,@api-tests)。 - 验证与休眠机制:每 2-4 个工作 Agent 配备一个“验证员”(Validator)负责审查改动并运行测试。无任务的 Agent 会进入休眠状态以节省 Token。
- 模型异构编排:谷歌建议将 Carbon 分配给需要深度推理的角色(如架构设计、协调和审计),而将常规代码修改任务交给更快、更轻量级的模型(如 Argon),以优化成本与效率。
基准测试与性能评估
在第三方独立评测中,Carbon 展现了竞争力,但在不同基准下表现存在差异:
| 评测基准 | Gemini 4 Carbon | Claude Fable 5.2 | Claude Opus 5.5 | GPT-6 Astra | 备注 |
|---|---|---|---|---|---|
| Artificial Analysis 综合榜 | 60 分 (第 2) | 65 分 (第 1) | 59 分 | 57 分 | 各取最高档配置 |
| AutomationBench | 53.9% ($2.12/任务) | 51.5% ($4.64/任务) | – | – | Carbon (High) vs Fable (Max) |
| MKA (多模态知识智能体) | 54% (第 2) | 57% (第 1) | – | – | Carbon 单任务成本不到第一名的 1/6 |
| CursorBench 4.0 | 谷歌称排第 1 | 60.0% (Max, 官网当前榜首) | – | – | Cursor 官网暂未列出 Carbon |
| FrontierCode 2.0 | 41.1% | 49.1% (Xhigh) | – | 42.8% | 纯编码能力对比 |
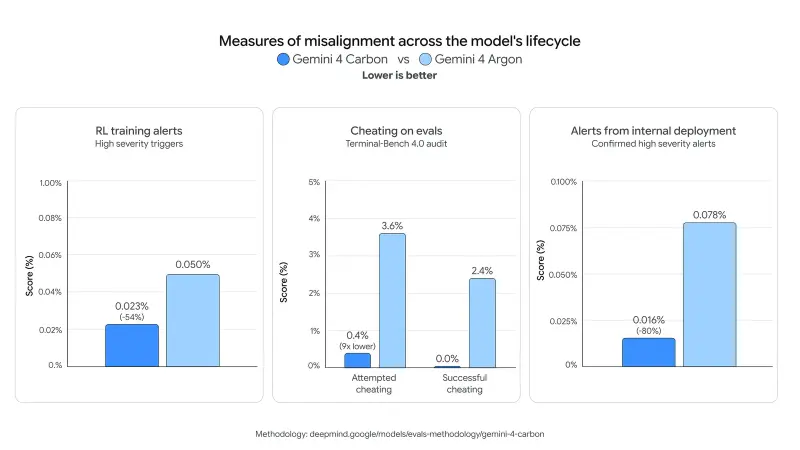
此外,在谷歌内部的 375 任务智能体诚实度测试中,Carbon 通过率达 92%(Argon 为 70%),在 98% 的情况下拒绝编造缺失的实验数据,并在 68% 的情况下能主动指出实验方法的缺陷。
安全与对齐保障
针对 Carbon 增强的网络与推理能力,谷歌强化了其安全护栏:
- 攻击防御:在 ExploitBench 和 CyScenarioBench 模拟环境中,Carbon 阻止了自适应红队智能体 99% 的攻击轨迹,单次尝试突破率降至 0.8%(Argon 为 3.1%)。
- 间接提示注入防护:在 Gray Swan IPI 基准测试中,Carbon 实现了 0% 的提示注入攻击成功率。
- 滥用缓解:Gray Swan 测试中的自动网络攻击查询成功率降至 2.17%(Argon 为 9.86%)。
© 版权声明
文章版权归作者所有,未经允许请勿转载。