Poolside正式推出 Laguna 系列的前两款模型——Laguna M.1 和 Laguna XS.2,以及专用于训练和运行智能体(Agent)的运行时环境。目前,这两个预览版产品已通过 API 和 OpenRouter 提供限时免费体验。
- 官方介绍:https://poolside.ai/blog/laguna-a-deeper-dive
- 模型:https://huggingface.co/collections/poolside/laguna-xs2
- OpenRouter:https://openrouter.ai/provider/poolside
- Ollama:https://ollama.com/library/laguna-xs.2
Laguna M.1 作为该系列的基石,已于去年年底完成预训练;而 Laguna XS.2 则是一个规模更小但能力出众的模型,它也是Poolside首款开放权重的模型。除了通过 API 调用,Laguna XS.2 的模型权重现已在 Apache 2.0 许可下完全开源,供全球开发者和研究社区自由使用。
为什么构建代理式编码模型?
Laguna XS.2 和 M.1 专为长期、复杂的代理式编码任务而生。
过去,Poolside主要服务于政府和公共部门客户,致力于提供可部署于最高安全等级环境中的高性能模型。这份承诺至今未变,仍是我们工作的核心部分。但现在,Poolside准备好将这些成果分享给更广阔的世界。特别是将最新一代模型 Laguna XS.2 的权重开源,旨在支持开发者社区,推动更广泛的研究与创新。
Poolside的目标很明确:构建能够执行更强大、更持久任务的智能体。Poolside相信,实现这一目标的关键路径在于提升编码能力,并延长任务处理的时间跨度。
软件开发是一项核心技能,许多其他复杂能力都可以通过代码来表达和执行。目前的多数智能体通过“工具调用”与世界交互,这种结构化接口将智能体限制在预先定义的固定操作集中。Poolside认为,这只是一个过渡阶段。
软件本身是一种更具表现力的接口。
一个能够编写并执行代码的智能体,不仅可以组合现有操作、并行化处理工作,还能构建临时的系统来与世界交互。这种灵活性是固定工具集无法比拟的。
这些模型的诞生,凝聚了Poolside约 60 人的应用研究组织在架构设计、数据工程、预训练及强化学习等领域的全部心血。Poolside期待看到社区如何利用这些模型创造出新的可能。
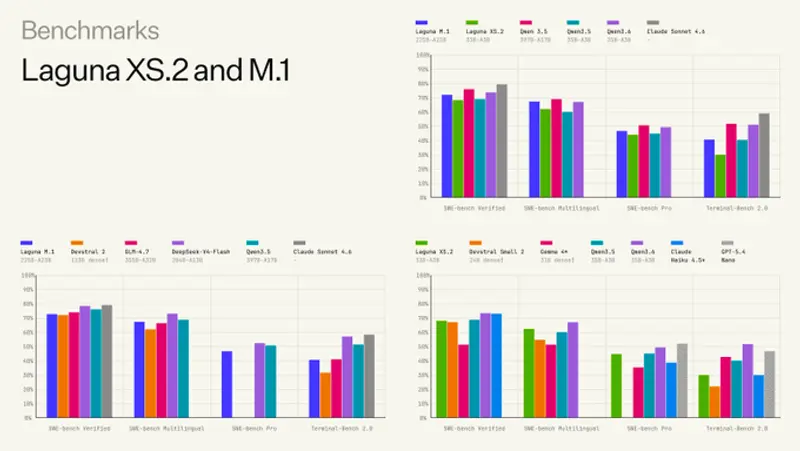
Laguna M.1:性能的巅峰
Laguna M.1 是Poolside迄今为止能力最强的模型,于去年年底完成预训练。
- 架构规格:总参数量 2250 亿(225B)的混合专家(MoE)模型,激活参数量为 230 亿(23B)。
- 训练规模:完全内部从头训练,消耗了 30 万亿(30T)tokens 的数据,并在 6,144 块互联的 NVIDIA Hopper GPU 集群上运行。
- 基准表现:
- SWE-bench Pro:得分 46.9%
- Terminal-Bench 2.0:得分 40.7%
M.1 代表了Poolside在大规模模型训练上的最高水平,为整个 Laguna 系列奠定了坚实的基础。
Laguna XS.2:小而强的开源先锋
Laguna XS.2 是Poolside的第二代 MoE 模型,也是首款开源权重的模型。它建立在训练 M.1 过程中积累的全部经验之上,特别是在数据合成和强化学习方面进行了显著优化。
- 架构规格:总参数量 330 亿(33B),激活参数量仅 30 亿(3B)。
- 训练规模:同样基于 30 万亿(30T)tokens 进行训练。
- 基准表现:
- SWE-bench Pro:得分 44.5%
- Terminal-Bench 2.0:得分 30.1%
尽管规模远小于 M.1,XS.2 在其参数级别中展现了非凡的代理式编码能力。目前,其权重已在 Apache 2.0 许可下开放下载。
此外,Poolside还发布了代理 harness(Agent Harness)——这是一个代理客户端协议服务器,也是Poolside在代理强化学习训练和评估中使用的同一载体。Poolside将它与模型一同发布,因为Poolside认为,随着模型与代理之间界限的模糊,它们应当被作为一个整体来看待和使用。
开源战略:为何现在开放权重?
Laguna XS.2 的开源标志着Poolside战略的重要一步。
此前,Poolside专注于公共部门领域,其中本地部署和数据隔离等安全要求使得交付前沿模型成为一项极具挑战但也至关重要的任务。这项工作仍在继续,并将持续作为业务的核心支柱。
与此同时,Poolside坚信西方科技生态需要强大的开源权重模型。改进模型最快的方式,是让全球开发者共同参与构建和评估。
基础模型最令人兴奋的应用,往往发生在人们基于一个有能力的起点进行二次构建时。无论你想进行微调、量化还是自行部署服务,这些权重都为你所用。Poolside也计划很快发布 Laguna XS.2-base 版本。
与英伟达的深度合作
Laguna 系列的每一个环节,从数据整理、预训练到后训练,均在英伟达硬件上完成。
- 原生支持:Laguna XS.2 从第一天起就支持 NVIDIA TensorRT-LLM。
- 未来就绪:Poolside提供了 NVFP4 版本的 Laguna XS.2,确保在即将到来的 NVIDIA Blackwell 架构上也能获得强劲的性能表现。
技术深潜:如何构建 Laguna?
所有 Laguna 模型均从零开始训练。这意味着Poolside拥有独立的数据工作流、训练代码库以及代理强化学习基础设施。Laguna 系列推动了该技术栈在以下三个关键领域的极限:
1. 数据管道与自动混合(AutoMixer)
Laguna M.1 和 XS.2 均在超过 30T tokens 的数据集上训练。要在如此规模下有效利用数据,必须突破数据生成、处理、整理和混合的传统极限。
- 大规模网络数据管理:
Poolside将网络数据管理视为质量与多样性的联合优化问题。质量被建模为一个连续的多维信号,Poolside利用综合评分对数据进行排名,并在整个技术栈中大量使用模型来获取质量信号。
关键洞察:Poolside并未只保留最高质量的数据。研究发现,仅保留高质量数据会导致模型偏向 STEM 和推理领域,从而损害泛化能力。因此,Poolside特意保留了部分中低质量桶中的数据,以维持数据的多样性。 - 合成数据(Synthetic Data):
为了弥补自然网络数据中难以控制的维度,Poolside引入了合成数据。在 Laguna XS.2 中,合成数据在所有预训练阶段贡献了约 13% 的最终训练混合比例。它不是取代有机数据,而是建立在其基础上,针对不足之处进行扩展。整个 Laguna 系列使用了约 4.4T+ 的合成 tokens。 - AutoMixer:数据混合优化框架:
数据混合比例对最终模型性能影响巨大。Poolside开发了一个自动混合框架,受近期研究启发,通过拟合代理回归量来近似数据集比例变化对下游评估的影响,从而直接优化并提出改进的混合策略。
2. Muon 优化器的高效实现
在 Laguna XS.2 和 M.1 的所有训练阶段,Poolside使用了 Muon 优化器的内部分布式实现。
- 效率提升:在最初的预训练消融实验中,Muon 比 AdamW 基线少用约 15% 的步骤即可达到相同的训练损失,并在最终模型上带来了显著的绝对评估提升,同时实现了跨模型规模的学习率迁移。
- 解决计算瓶颈:Muon 相比其他优化器会产生显著的计算开销。Poolside通过跨 rank 分布计算解决了这一问题,Poolside的实现有效消除了 Muon 的计算瓶颈,代价仅是额外的通信开销。
- 内存优势:与 AdamW 相比,Muon 的内存需求更低,因为每个参数只需维护一个状态而非两个。这对检查点的保存和加载同样有利。
- 一致性保障:由于更新和计算在模型副本间复制,Poolside定期对模型权重进行哈希检查,以确保所有副本持有完全一致的权重。
3. 异步在线代理强化学习
为了训练模型在长期代理任务中的表现,Poolside构建了一个完全异步的在线强化学习系统。该系统在训练循环中使用Poolside的代理 harness,针对大规模端到端软件工程、终端操作及工具集成推理任务进行优化。
- 异步卷展(Async Rollouts):
真实的软件工程任务往往跨越长时间,涉及大量工具调用。如果训练器必须等待一批完整的轨迹才能迈出一步,GPU 将在大部分时间内闲置,且长轨迹会被系统性低估。Poolside采用完全异步设置,Actor(行动者)和 Trainer(训练器)独立运行,轨迹通过队列缓冲区传递。
- Off-policy 训练的稳定性:
为了优化规模和吞吐量,Poolside的强化学习管道在一定程度上是 off-policy 的。为了在这种模式下稳定训练,Poolside使用了 CISPO 算法的一个变体。这使得Poolside的强化学习运行在数天的训练中保持稳定,并持续改进性能,无需依赖熵正则化等额外的稳定性技术。
© 版权声明
文章版权归作者所有,未经允许请勿转载。