在移动端部署高质量 AI 模型一直面临着“体积大、速度慢、耗电高”的挑战。今天,腾讯混元团队推出了基于 Hy-MT1.5-1.8B 基础模型的两个极致压缩版本——Hy-MT1.5-1.8B-1.25bit 和 Hy-MT1.5-1.8B-2bit。
- Hugging Face:https://huggingface.co/collections/AngelSlim/hy-low-bit-model
- 魔搭:https://modelscope.cn/collections/AngelSlim/Hy-MT15-Quant
这两个模型不仅体积小巧,更在综合性能上实现了惊人突破:仅凭 1.8B 参数,它们在翻译质量上全面超越了规模大得多的开源模型(如 Tower-Plus-72B、Qwen3-32B)以及主流商业翻译 API(如 Microsoft Translator、豆包翻译)。
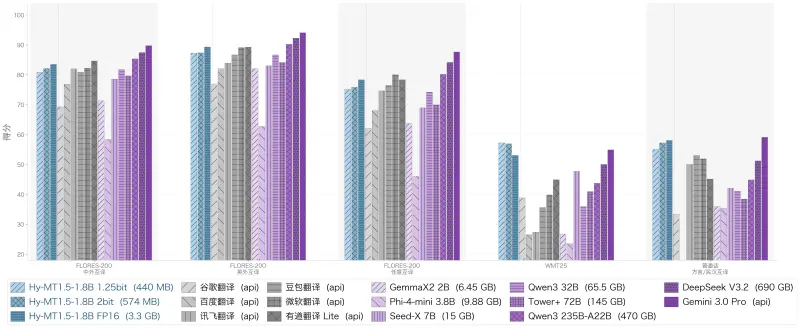
核心亮点:小体积,大能量
1. Sherry 框架:1.25-bit 极致量化(仅 440MB)
1.25-bit 版本采用了腾讯混元团队最新提出的 Sherry 量化框架(已被 ACL 2026 接收)。这是一种硬件高效的三值量化技术,通过创新的 3:4 细粒度稀疏策略 实现极致压缩:
- 原理:每 4 个模型权重中,保留最重要的 3 个为 1-bit(值为 {-1, +1}),其余 1 个归零。
- 效率:将 4 个权重打包到仅 5 个比特中,实现有效的 1.25-bit 位宽,同时保持与 2 的幂对齐,便于硬件加速。
- 成果:将原始 3.3GB 的 FP16 模型压缩至仅 440MB,精度损失极小。
搭配专为移动 CPU 设计的定制 STQ 内核,该模型实现了完美的 SIMD 指令集对齐。这意味着即使是内存有限的普通智能手机,也能流畅运行高质量的离线翻译。无需互联网连接,数据完全本地处理,隐私绝对安全。
2. SEQ 技术:2-bit 高性能量化(仅 574MB)
2-bit 版本则采用了业界领先的**拉伸弹性量化(SEQ)**技术,并结合了量化感知蒸馏:
- 原理:将模型权重量化为 {-1.5, -0.5, 0.5, 1.5} 四个离散值。
- 成果:将模型压缩至 574MB,同时保持了接近无损的翻译质量。
- 优化:针对支持 Arm SME2 的移动设备(如 Apple M4 系列芯片、vivo X300 等)进行了深度优化,可在手机端实现快速、完全离线的翻译体验。
强大基础:Hy-MT1.5-1.8B
这两个压缩模型均基于强大的 Hy-MT1.5-1.8B 基础模型构建。该模型是腾讯混元团队通过整合以下多阶段训练流程开发的专用翻译模型:
- 面向机器翻译的预训练
- 监督微调(SFT)
- On-policy 蒸馏
- 强化学习(RL)
原生支持能力:
- 33 种语言
- 5 种方言/少数民族语言
- 1,056 个翻译方向
尽管参数量仅为 1.8B,但其在综合性能上的表现足以媲美甚至超越数百亿参数的大型模型,真正实现了“小而美”。
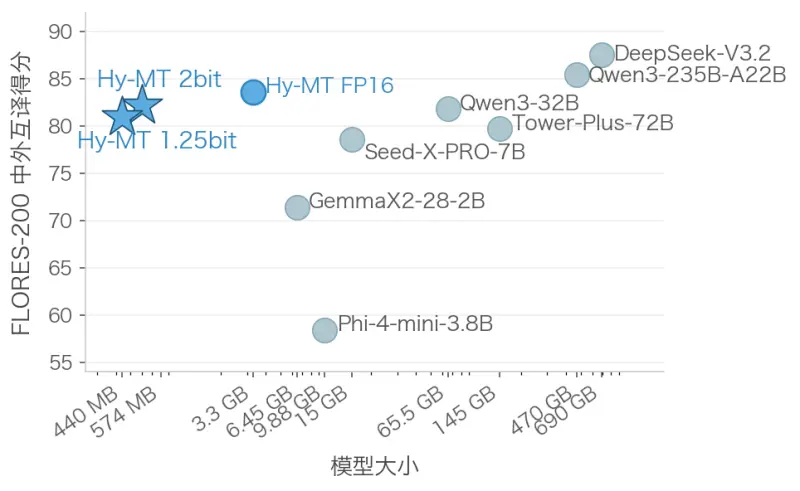
实战演示:Android 离线翻译应用
为了展示这一技术的实用性,腾讯混元提供了一款即用型 Android 离线翻译演示应用。
- 后台单词提取模式:无需切换应用,即可在手机上的任意界面(电子邮件、网页、聊天消息)获得即时翻译。
- 完全离线:无需网络连接,一次性下载即可永久使用。
- 隐私保护:不收集任何用户数据,所有处理均在本地完成。
下载资源
你可以从 ModelScope 社区获取模型权重、GGUF 格式文件及演示应用:
- 1.25-bit 模型权重:Hy-MT1.5-1.8B-1.25bit
- 1.25-bit 模型 GGuf:Hy-MT1.5-1.8B-1.25bit-GGUF
- 2-bit 模型权重:Hy-MT1.5-1.8B-2bit
- 2-bit 模型 GGUF:Hy-MT1.5-1.8B-2bit-GGUF
- Android 演示应用 APK:Hy-MT-demo.apk
© 版权声明
文章版权归作者所有,未经允许请勿转载。