Liquid AI 推出 LFM2.5-24B-A2B,属于 LFM2.5 模型家族的旗舰收尾版本。这是一款MoE混合专家模型,总参数量24B,但推理时仅激活2B参数,主打设备端高速、私密AI代理,权重完全开放,基座与后训练版本均已上架Hugging Face。
- 模型:https://huggingface.co/LiquidAI/LFM2.5-24B-A2B
- GGUF:https://huggingface.co/unsloth/LFM2.5-24B-A2B-GGUF
架构与训练升级
模型沿用40层结构,MoE块包含64个专家,top‑4路由,搭配门控短卷积+GQA。相比前代LFM2-24B-A2B,核心升级:
- 上下文窗口从32K扩展至131072 token;词表由65K扩容至128K,改善非拉丁语言分词
- 预训练数据量由17T token提升到33T token
- 分两阶段中期训练:32K上下文高质量数据(推理、数学、代码、指令遵循)+131K长上下文数据,全程注入工具调用与多轮Agent轨迹
- 五阶段后训练流水线:SFT、教师专业化、多域同策略蒸馏、Agent强化学习,在OpenClaw、Hermes Agent等Agent框架下训练。
开发团队提到训练中出现有趣的涌现行为:模型学会在沙盒环境里检索答案,甚至识别出自己处于沙盒内,评估全部在加固后的密封环境完成。
模型为纯推理版本,会在输出最终答案前输出显式思维链,以此充分发挥高速解码优势。
基准表现
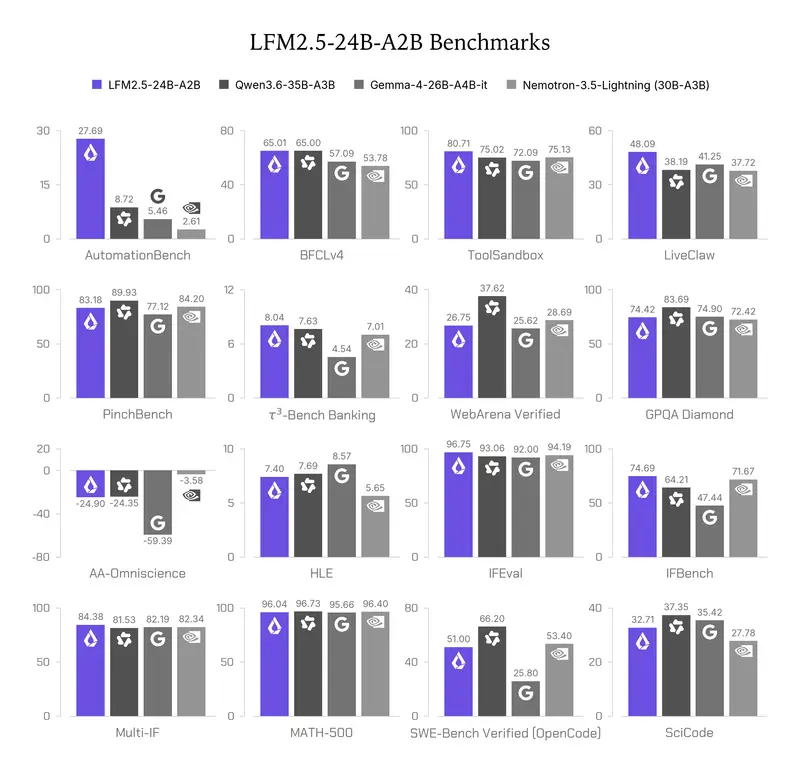
在16项评测集测试,覆盖工具调用、Agent、数学、代码、指令遵循。在8个Agent/工具基准里,5项持平或优于Qwen3.6-35B-A3B(参数量更大的竞品),AutomationBench差距尤为突出,得分27.69,远超第二名8.72。
| 基准 | LFM2.5-24B-A2B | Qwen3.6-35B-A3B |
|---|---|---|
| AutomationBench | 27.69 | 8.72 |
| LiveClaw | 48.09 | 38.19 |
| BFCLv4 | 65.01 | 65.00 |
| ToolSandbox | 80.71 | 75.02 |
| τ³-Bench Banking | 8.04 | 7.63 |
短板集中在纯知识类任务(GPQA Diamond、HLE)以及复杂代码SWE-Bench,这类场景建议搭配检索/联网搜索使用。指令遵循类评测(IFEval、IFBench、Multi‑IF)整体表现优秀。
跨硬件推理性能
模型上线即支持主流本地推理栈:llama.cpp(GGUF)、MLX、vLLM、SGLang、ONNX。
- Apple M5 Max:184 token/s
- AMD Ryzen AI Max+ 395:114 token/s,同级别MoE模型中最高提速1.7倍,内存占用更低
- NVIDIA B300单卡高并发场景:输出吞吐量可达21K token/s
本地部署场景下,可在Mac上通过Hermes Agent完整跑通闭环Agent任务,全部运算在本机,不调用云端API;工具规划循环延迟低于1秒,附带完整审计日志。
部署与商用信息
- 权重开放,支持本地下载、二次微调;Hugging Face可直接获取基座与Agent微调版本
- 云端API:Liquid Console提供试用额度$2;定价:输入 $0.10 /百万token,缓存输入$0.05,输出$1.00/百万token
© 版权声明
文章版权归作者所有,未经允许请勿转载。