智谱推出领域专用法律大模型 GLM-Legal,以GLM-5.3-Flash(320B总参、18B活跃参数MoE)为底座,面向代理式法律工作专项训练,主打合同审查、证据分析、合规调研。
- 官方介绍:https://z.ai/blog/glm-legal
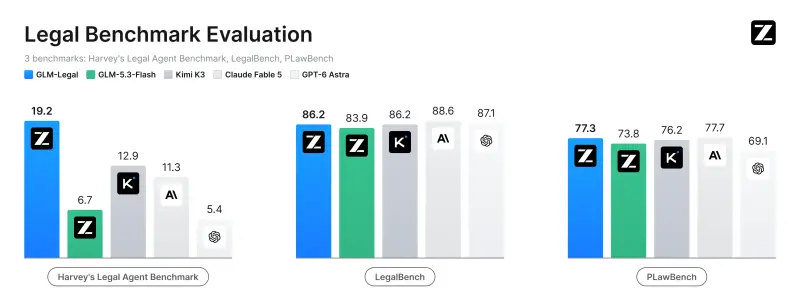
在Harvey LAB法律代理基准测试中,GLM-Legal取得19.17%任务全通过率,是基础模型6.67%的近3倍,在Vals AI的79个参评模型里排第7,超过Kimi K3、Claude Fable 5、GPT-6 Astra。
注意:GLM-Legal无公开权重,仅支持申请制托管API;基础模型GLM-5.3-Flash可自托管。
训练方案
训练分为两个阶段:
- 中期训练:在扩充法律语料上训练,强化从事实、规则推导结论的法律推理链路;
- 后训练:基于数万套法律任务环境做强化学习,代理执行框架(harness)与模型协同迭代,持续暴露边界案例并修复评测环境瓶颈。
基准测试解读
Harvey LAB是开源法律Agent基准,覆盖24个业务领域,合计1250项任务,依靠75000+专家编写评分标准,任务必须全部标准达标才算通过(全通过指标)。评测环境禁用联网,Agent可调用文档工具,支持docx/pptx/xlsx文件处理。
| 模型 | Harvey LAB全通过率 | LegalBench | 法律研究基准 | 单次测试成本 | 平均耗时 |
|---|---|---|---|---|---|
| GLM-Legal | 19.17% | 86.23% | 41.83% | $0.15 | 72分钟 |
| GLM-5.3-Flash(底座) | 6.67% | 83.93% | 45.19% | $0.57 | 52分17秒 |
| Kimi K3 | 12.92% | 86.21% | 46.15% | $3.83 | 13分58秒 |
| Claude Fable 5 | 11.25% | 88.56% | 49.52% | $19.23 | 26分53秒 |
| GPT-6 Astra | 5.42% | – | 39.42% | $26.16 | 24分49秒 |
- 优势:Harvey LAB全通过率大幅领先同场对比模型,成本优势极强,单次测试花费仅为Claude Fable 5的1/128;单项标准通过率达92.5%,处于顶尖梯队。LegalBench分数和Kimi K3基本持平,略低于Claude Fable 5。
- 短板:法律研究基准分数反而弱于底座模型;推理速度偏慢,单任务平均耗时72分钟;目前API需要申请,官方暂未公布定价,模型权重不对外发布。排行榜上仍有6款模型分数更高,榜首为Muse Spark 1.2(25.42%)。
接入方式
- GLM-Legal:面向律所、法务团队、法律科技公司申请开通托管API;未来计划接入智谱桌面代理AutoClaw,但暂无上线时间。HuggingFace暂无模型仓库。
- GLM-5.3-Flash底座:可直接调用API,也支持vLLM/SGLang多GPU FP8自托管,输入$0.15 / 百万token,输出$0.50 / 百万token,可先用底座完成原型,后续切换GLM-Legal。
© 版权声明
文章版权归作者所有,未经允许请勿转载。