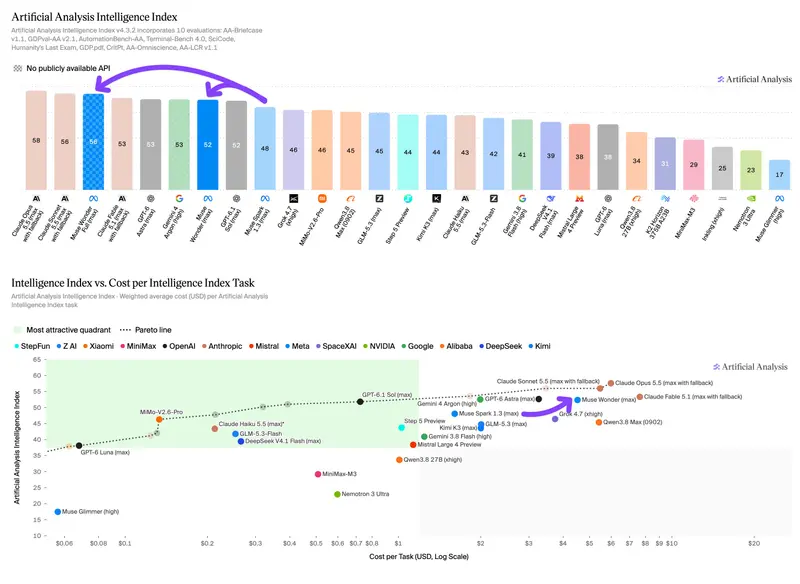
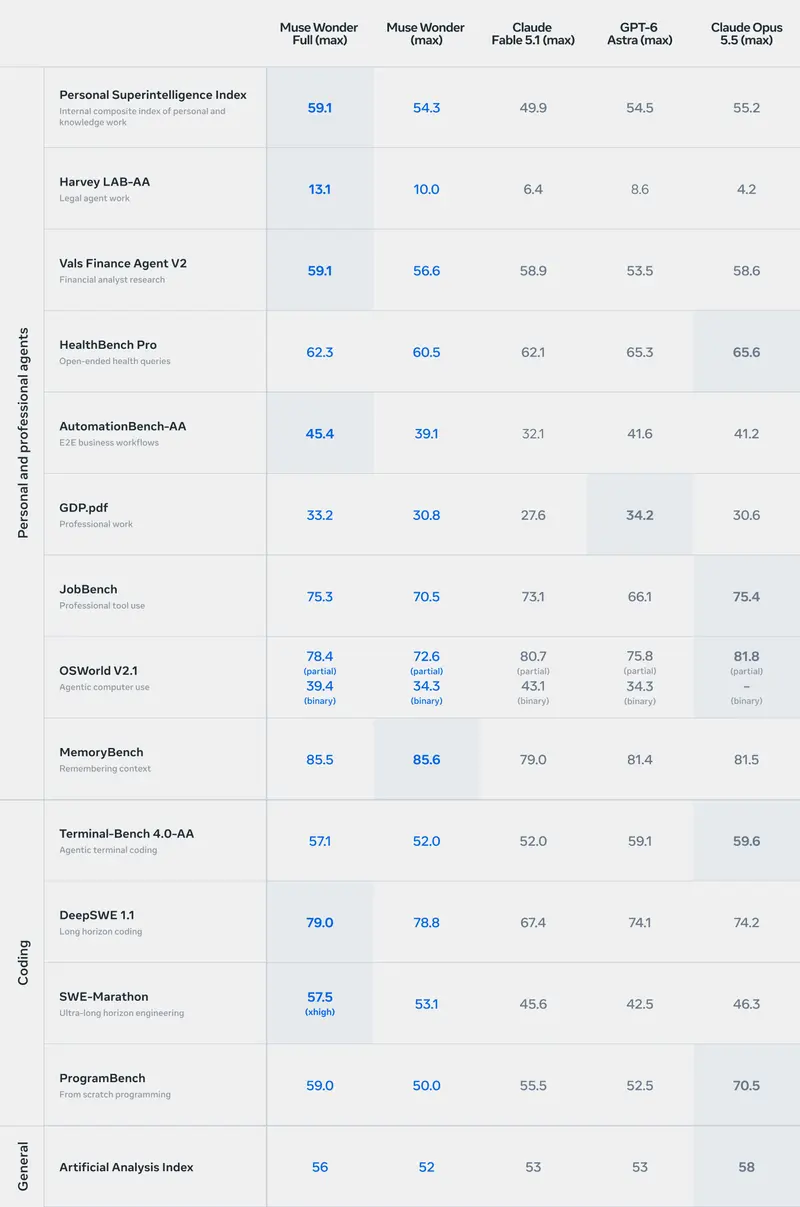
Meta超级智能实验室发布全新前沿模型家族:Muse Wonder 与 Muse Wonder Full,这也是Meta推出的第一款顶级前沿大模型。此前Meta已经发布轻量模型Muse Spark,主打低延迟推理;本次Wonder系列定位更高阶,基准成绩更强,在编程等复杂任务上表现更好,官方自测性能可对标Fable 5.1、GPT-6 Astra。
整套模型在Meta俄亥俄州中部Prometheus数据中心完成训练,该数据中心于今年早些时候正式投产。本次发布也是Alexandr Wang去年8月接管Meta AI业务重组之后,Meta首次发布旗舰级前沿模型。新模型将作为Muse智能体的底层基座。
版本区分与定价
| 模型 | 访问渠道 | 定价规则 |
|---|---|---|
| Muse Wonder | Meta Model API + Muse Code | 输入:$4 /百万token,输出:$20 /百万token |
| Muse Wonder Full | 仅Muse Code订阅用户,不开放API调用 | 订阅内专属 |
Wonder的API成本大致和GPT-6 Sol、Claude Opus 5.5处于同一区间。后续Muse产品内的相关体验也会逐步切换至Muse Wonder驱动,优先面向订阅用户开放,同时支撑artifact生成与复杂流程任务。Meta还计划基于Wonder继续开发专项模型,向全体Muse用户落地。
四大核心能力
主动记忆
这是本次发布最核心亮点。模型可以跨对话留存、综合用户信息,长期记住用户关键信息。Meta使用MemoryBench评测该项能力,官方测试中Muse Wonder得分超过Fable、Opus、Astra,目标支持长达数月级别的记忆留存,适配个人智能体场景。
主动专注
面向长周期复杂任务,模型能够持续朝着目标推进,尝试多种方案、处理障碍,必要时主动向用户确认信息。相关能力通过FocusBench、SWE-Marathon(长期软件工程任务)评估,适配多步骤持续执行的智能体工作流。
领域专业能力
覆盖法律、金融、健康等专业场景,可解析租约、财务资料、健康信息,在Harvey法律代理基准LAB等专业评测中验证文档处理与指令执行能力。
前沿编程能力
结合记忆与专注能力,处理从小型应用到大型软件项目的开发工作,在长期迭代、多轮调试类软件工程任务上做专项优化。
泛化能力
Muse Wonder与Wonder Full常规基准分数接近,但Wonder Full处理陌生、未见过任务的泛化能力更强。测试数据显示,在分布外任务上,Wonder Full的性能优于Muse Spark 1.3的预期趋势,更强的基座模型让后训练带来的能力增益,能够更好迁移到训练时未见过的任务,这一点对多变的个人智能体场景至关重要。
安全对齐
Meta针对个人智能体场景强化安全对齐。模型会谨慎处理消息、日历、私人文档等敏感信息;针对CBRN生化放射核、网络滥用场景提供更强防护。同时遵循Meta超级智能扩展框架,保留防御性场景下的网络能力访问。完整安全评估报告将后续放出。
要点小结
- Meta发布Muse Wonder、Muse Wonder Full,是其重组AI团队后首款前沿旗舰模型,对标GPT-6 Astra、Fable 5.1。
- 版本权限区分明显:Wonder开放API,Wonder Full仅Muse Code订阅用户可用,不对外提供API。
- 核心亮点为主动记忆+主动专注,专为个人/专业智能体长任务设计,MemoryBench官方测试成绩优于竞品。
- 在Prometheus千兆瓦级数据中心训练,兼顾法律、金融、编程能力;同时针对私人数据、高危场景做安全对齐。
© 版权声明
文章版权归作者所有,未经允许请勿转载。