德国AI公司Aleph Alpha在德国统一日正式发布全新开放权重大模型Kolibri,定位面向公共行政、工业、航空航天等强监管领域的主权关键任务模型,权重在Hugging Face公开,采用Apache 2.0许可证,企业可自由本地部署。
- 模型:https://huggingface.co/collections/Aleph-Alpha/kolibri-1
Kolibri是英德双语混合专家(MoE)Transformer架构,总参数781亿,单次推理仅激活34.6亿参数,最高支持100万token上下文窗口。它源自同团队更早的Kolibri Origin,依托自研Model Factory自动化训练管线,仅用三个月完成两代模型跨越式迭代。
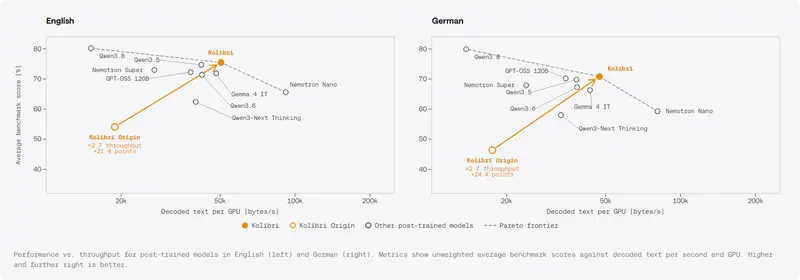
模型基础规格对比
| Kolibri Origin | Kolibri | |
|---|---|---|
| 预训练完成时间 | 2026.6.11 | 2026.9.11 |
| 总参数 | 30.6B | 78.1B |
| 单Token活跃参数 | 3.27B | 3.46B |
| 预训练Token总量 | 7.51T | 20T |
| 最长训练上下文 | 65,536 token | 262,144 token |
| 知识截止 | 英:2024-09,德:2025-08 | 英/德统一至2026-06-18 |
Kolibri采用50层全MoE架构,384个专家,每次激活6个专家;注意力采用混合方案,仅10层使用全注意力,其余40层使用512token滑动窗口,大幅降低长上下文推理开销。
团队选择78B而非更大的123B版本,核心考量推理并发:同等硬件下78B可承载18个256k长上下文并发请求,123B仅能跑3路,且78B解码速度快28%。
整套训练在768片B200 GPU上分三阶段完成,合计近24T训练token。
核心特性:主权合规 + 原生英德双语 + 抑制幻觉
1. 面向欧盟法规的AI主权设计
Kolibri从设计之初就对齐EU AI法案、GDPR与版权规范。模型在德国开发,训练基础设施位于德国、芬兰,全程由Aleph Alpha掌控完整数据、训练、评估全链路,无境外主体控制。
主权包含两层含义:完整可控的模型构建供应链;交付给客户后,客户拥有完整部署自主权与知识产权安全,数据无需外发第三方云端推理服务。
2. 原生英德双语,并非英语模型附加德语
预训练数据中德语占比21.3%,约4.3T token,仅6%来自机器翻译,最大限度规避翻译腔、外来文化偏见。
团队自研UniBPE双语分词器,结合BPE与Unigram优势,适配德语大量复合词形态,相比传统分词器压缩效率更高,减少德语场景token消耗,降低推理成本。
德语语料来源分三类:原生网络德语文档、德语原文改写扩充、少量翻译文本;80%德语数据由团队自行整理生成,仅20%取自公开数据集。
3. Merlin-Arthur协议,内置主动弃权,减少幻觉
这是Kolibri面向政企场景的关键能力:当上下文不足以支撑答案时,模型主动输出“我不知道”,拒绝编造信息。
团队设计Merlin-Arthur三方博弈训练框架,自动生成正负样本:一部分样本提供充足证据,另一部分刻意剥离关键证据诱导模型幻觉。模型需要自行判断证据是否存在,在证据缺失时选择弃权。
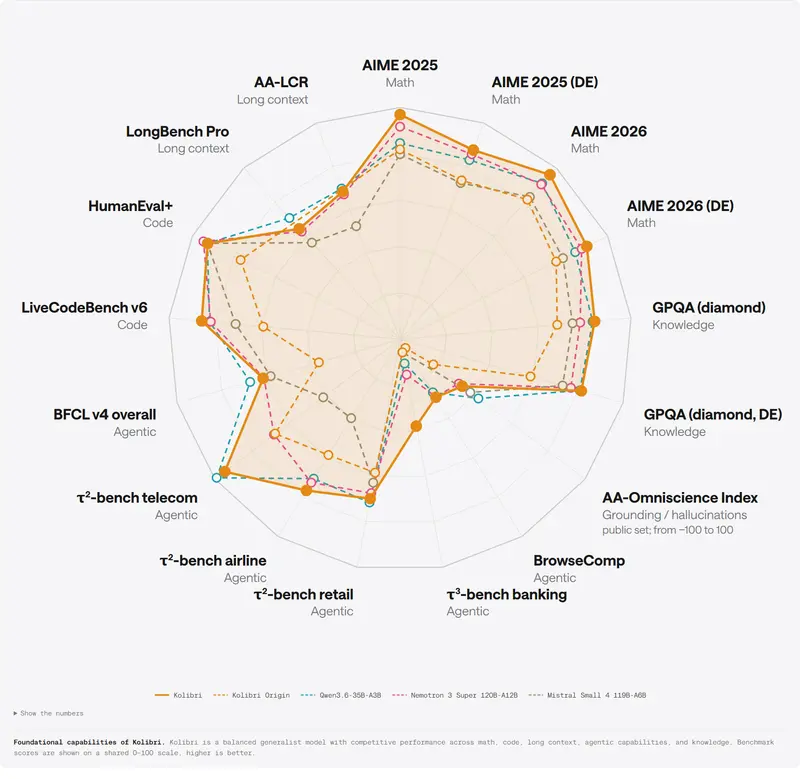
实测幻觉抑制提升明显:AA-Omniscience基准,Kolibri弃权率44%(Origin仅15%);RGB基准克制率86%,虚假信息生成大幅下降;M/A接地得分达到0.23,Origin为0。
4. 四级推理算力档位
模型支持无、低、中、高四种推理努力等级,客户可按需控制模型投入的计算资源,灵活权衡推理延迟、成本与回答质量,适配不同业务SLA需求。
在数学、编码、长上下文、接地检索任务上,Kolibri性能可对标活跃参数规模四倍的模型,例如Nemotron 3 Super;在智能体RAG基准Honeypot上超过同赛道多款更大规模开源模型。
团队还搭建政务、汽车、航空、制造业专属内部评估套件,不需要使用客户私有数据,即可针对行业场景持续优化模型的情境化能力。
Model Factory自动化训练管线
这套管线是本次快速迭代的核心,将大模型训练流程全部代码化、版本化。
- 每一次代码改动都会触发小型模型端到端测试,快速验证bug;
- 每小时自动保存训练检查点,并自动在多维度基准做评估;
- 训练遇到硬件故障、网络中断时自动恢复,最多仅回退250步,无需人工值守。
Kolibri预训练21天期间共遭遇38次非计划中断,全部由管线自动处理。
训练中引入精确分位数专家负载均衡,在固定开销下优化专家路由,解决MoE负载不均问题。
部署使用
模型开源在Hugging Face,Apache2.0协议。
推理依赖aleph-alpha-inference包与vLLM插件,官方提供容器镜像,支持最高1M上下文窗口。
基础启动命令示例:
pip install "aleph-alpha-inference>=1.0"
vllm serve Aleph-Alpha/Kolibri-1 --kv-cache-dtype fp8 \
  --reasoning-parser kolibri1 \
  --tool-call-parser kolibri1 \
  --enable-auto-tool-choice
如需开启1M超长上下文:追加参数 --max-model-len 1048576 --hf-overrides '{"max_position_embeddings": 1048576}'
推荐采样参数:temperature=1.0、top_p=0.97、top_k=128
核心要点总结
- Kolibri:78B总参数MoE,3B活跃参数,最高1M上下文,Apache2.0开源,主打欧盟主权本地部署。
- 原生英德双语,德语预训练占比21.3%,自研UniBPE分词器,减少德语场景token损耗。
- Merlin-Arthur训练框架,具备证据不足自动弃权能力,显著抑制幻觉,适配RAG、政务文档检索。
- 四级推理强度可调,可平衡算力开销与回答质量,面向公共管理、航空、汽车等强监管行业。
- Model Factory自动化训练平台,3个月完成两代模型迭代,训练集群故障可自动恢复。
© 版权声明
文章版权归作者所有,未经允许请勿转载。