IBM正式推出新一代开源推理模型家族 Granite 4.2,包含 3B、8B、30B 三个稠密参数量版本。不同于前代仅作为指令助手,Granite 4.2从底层架构就围绕显式推理能力打造,自带思考开关、可调节推理强度;8B与30B版本额外经过智能体强化学习训练,具备代码编辑、终端操控、网页搜索等实操能力,全部模型采用宽松的Apache 2.0协议开源,企业可免费商用。
- 官方介绍:https://research.ibm.com/blog/introducing-granite-4-2
- GitHub:https://github.com/ibm-granite/granite-4.2-language-models
- 模型:https://huggingface.co/collections/ibm-granite/granite-42-language-models
核心特性:可切换的原生推理模式
Granite 4.2内置思维链输出机制,回答问题前可输出完整思考过程。官方在聊天模板中开放了控制开关,提供三种模式可选:
- 思考模式:输出完整思维链,适合复杂推理任务
- 低推理力度模式:缩短思考开销,应对简单问题、节约算力
- 非思考模式:跳过推理过程,直接给出最终答案
3个版本均为稠密Transformer解码器架构,从零开始使用约15万亿Token完成预训练。8B、30B版本额外增加代理RL训练环节,模型在沙盒环境下学习编辑代码、操作终端、执行网页搜索;而3B版本仅完成基础强化学习对齐,没有智能体训练。
同期配套发布两款 Granite Speech 5.0 Turbo CTC语音模型,参数量4.7亿,语音转文字模型不含LLM骨干,主打超高吞吐速度。
部署门槛:从小型笔记本到企业集群全覆盖
得益于Apache‑2.0开源许可,开发者可以自由下载、微调、投入商业生产,不存在授权限制。
- 3B版本:适合独立开发者、初创团队。GGUF‑Q4_K_M量化包可借助 Ollama、LM Studio 在笔记本本地运行
- 8B版本:单张高性能GPU即可部署,面向中小企业团队
- 30B版本:推荐A100 / H100级别的算力,支持vLLM开启FP8、NVFP4高效推理;适合有数据本地化需求、受监管行业的大型企业
适配行业场景:软件开发智能体、DevOps自动化运维、深度研究搜索代理、长文档RAG知识库、工具调用、企业客服语音转录;金融、医疗、电信、政务等领域均可落地。
模型架构详情
Granite 4.2属于稠密模型,非MoE混合专家架构,基础配置:分组查询注意力(8个KV头)、RoPE(θ=10000000)、SwiGLU激活函数、RMSNorm归一化、bfloat16精度、解耦输入输出嵌入。
- 3B:40层,嵌入维度2560
- 8B:40层,嵌入维度4096
- 30B:64层,MLP隐藏维度32768
基础序列长度128K Token,长上下文预训练阶段最高拓展至 512K Token。
训练链路:多阶段异步RL强化学习链是最大亮点
本次模型能力提升的关键,在于一套五阶段的异步GRPO训练流水线,并非单次微调即可完成:
RLVR → 技能增强 → SWE代码环境训练 → 终端操控训练 → 网页搜索训练 → RLHF对齐
监督微调数据集总量约720万样本,合计100B Token,其中65B可训练。训练样本当中31.6%属于智能体任务,软件工程类任务占据智能体样本的69%。训练轨迹来源包括OpenHands、SWE‑agent、Codex等多个智能体框架;并且引入GPT‑OSS‑120B、Gemma 4作为结果评判器,对训练数据做SHA‑256去重,保证数据集质量。
训练算力部署于CoreWeave的英伟达GB200 NVL72集群,依托NeMo‑RL与NeMo‑Gym完成训练。另外引入来自CodeAlchemy流水线的1万亿Token合成代码数据;模型内置推测解码层,用来提升推理速度。
基准测试成绩
| 基准项目 | 3B | 8B | 30B |
|---|---|---|---|
| SWE‑Bench Verified | — | 47.67 | 57.00 |
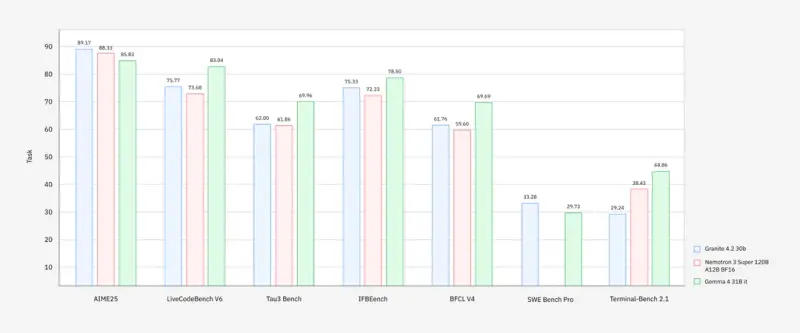
| Terminal‑Bench 2.1 | — | 20.56 | 29.24 |
| τ³‑bench | 50.99 | 66.34 | 68.05 |
| BFCL (v4) | 52.41 | 50.29 | 61.39 |
| AIME25 | 78.33 | 86.67 | 89.17 |
| GPQA | 54.80 | 64.14 | 66.41 |
| MMLU‑Pro | 67.84 | 74.04 | 77.60 |
| RULER 128K | 55.30 | 71.41 | 81.38 |
30B版本在代码实操榜单SWE‑Bench Verified取得57分,Terminal‑Bench终端操控得分29.24,企业级代码智能体能力亮眼。
Granite Speech 5.0 Turbo CTC语音模型
4.7亿参数语音模型采用CTC架构,完全抛弃大语言模型骨干,专注音频转写。在单张H200显卡上,吞吐量RTFx可达约12600,性能远超当前开源榜单头部(约6000),官方已经开放WebGPU演示。
© 版权声明
文章版权归作者所有,未经允许请勿转载。