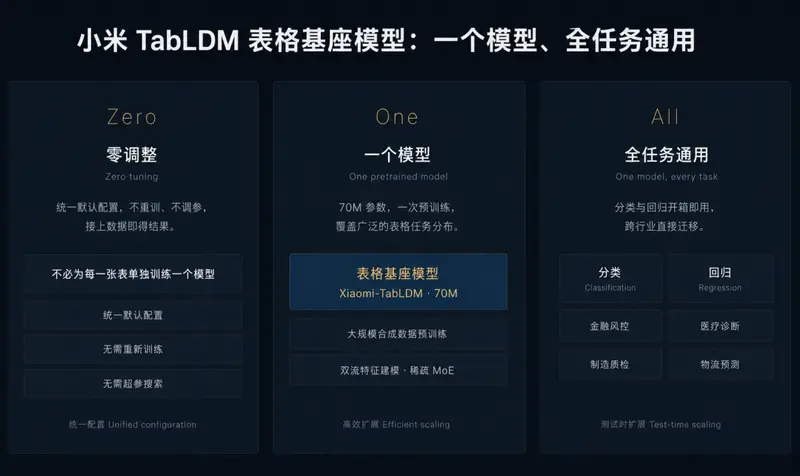
小米正式发布通用表格数据基础大模型 Xiaomi-TabLDM。该模型采用“一次预训练、跨任务使用”的基础模型范式,以单一预训练权重和统一默认配置直接适配不同表格数据集,无需针对每个新任务重新训练、调参或进行后置集成,即可完成分类与回归预测。
- GitHub:https://github.com/xiaomi-research/xiaomi-tabldm
- 模型:https://huggingface.co/occams/Xiaomi-TabLDM
这一设计旨在解决传统表格机器学习的部署痛点。在金融、医疗、制造、物流等领域,核心业务数据多以结构化表格形式存在,但传统方法通常需要为每个数据集单独训练模型,伴随多次迭代、参数调优及版本管理等繁重工程代价。Xiaomi-TabLDM 通过将基础模型能力引入结构化数据领域,试图将表格预测任务的边际部署成本降至接近零。
基于结构因果模型的预训练与稀疏混合专家架构
Xiaomi-TabLDM 的技术实现围绕预训练数据、模型架构与推理策略三个维度展开。在预训练阶段,模型完全基于结构因果模型(SCM)生成的大规模合成数据,覆盖不同数据规模、变量类型、依赖关系及函数关系,以此扩大预训练任务的分布广度,避免对特定真实数据集的过拟合。
模型架构方面,Xiaomi-TabLDM 引入了三项关键设计:双流特征分组(dual-stream feature grouping)用于从不同粒度建模特征关系;轻量级注意力残差(lightweight Attention Residual)降低计算开销;稀疏混合专家(sparse Mixture-of-Experts)则在保持推理效率的同时扩大模型容量。在推理阶段,模型进一步探索了 Test-Time Scaling 机制,即在预训练参数冻结的前提下,通过增加推理阶段的计算量持续提升预测性能,而非依赖微调。
公开基准评测排名与工业场景实测精度提升
在四大公开基准评测中,Xiaomi-TabLDM 均进入第一梯队。回归能力表现尤为突出:在 OpenML-CTR23 回归榜单排名第一;在 TALENT、TabArena 和 BCCO 的回归任务中均位列第二;在 TALENT 二分类任务中同样取得第一。在效率维度上,以 TabArena 回归任务为例,该模型在取得第二高 Elo 评分的同时,训练时间比排名第一的 TabFM 减少 82%,预测时间减少 68%。
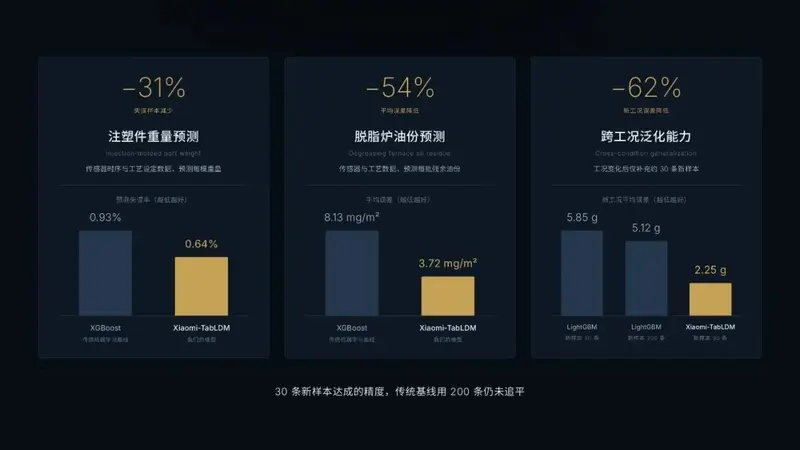
在真实工业场景验证中,Xiaomi-TabLDM 相比传统机器学习方法展现出更高的预测精度与跨工况适应能力:
- 材料性能预测: 无需微调即可将预测精度提升 130%,减少约 90% 的无效试模与装机测试。
- 零件重量预测: 相比 XGBoost,失误样本比例降低约 31%。
- 生产组分预测: 平均误差相比 XGBoost 降低约 54%;当生产工况发生变化时,仅补充约 30 条新工况样本作为上下文,即可将平均误差进一步降低约 62%。
scikit-learn 兼容接口与开源发布
Xiaomi-TabLDM 提供与 scikit-learn 兼容的 API 接口,开发者可通过 pip 直接安装使用,无需修改现有数据处理与评估流水线。这种接口设计降低了迁移门槛,使已有表格机器学习项目能够以最小代码改动接入基础模型能力。
目前,Xiaomi-TabLDM 的模型权重与完整代码已正式开源。研究者和工程师可基于开源资源复现论文结果、在自有数据上验证零样本性能,或在此基础上进行二次开发与领域适配。对于希望摆脱重复训练循环、快速验证表格 AI 价值的团队而言,该模型提供了一个低摩擦的起点。
© 版权声明
文章版权归作者所有,未经允许请勿转载。