开源纯循环神经网络(RNN)大模型 RWKV‑7 迎来 G1(GooseOne) 新版本系列,原生内置深度思考推理与函数调用能力,证明非‑Transformer 架构完全有能力胜任复杂 Agent 智能体任务,打破了行业长期以来的固有认知。
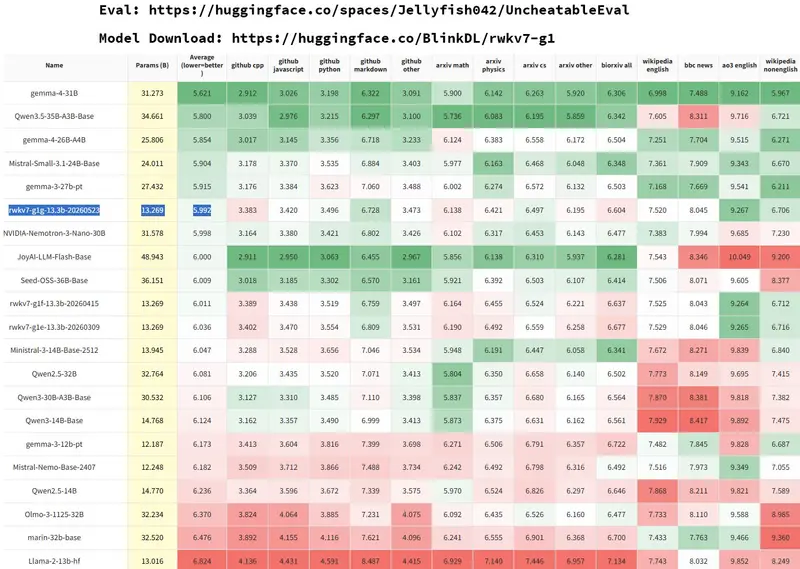
- GitHub:https://github.com/BlinkDL/RWKV-LM
- 模型:https://huggingface.co/BlinkDL/rwkv7-g1
架构核心优势
RWKV 属于无注意力机制的纯 RNN 路线,不存在 KV‑Cache。最突出的特性就是生成全程拥有恒定速度、恒定显存占用;上下文越长,相比 Transformer 模型的显存与延迟优势就越明显。
在单张 RTX 5090 显卡环境下,RWKV7‑G1 的预填充吞吐量最高可达每秒 11289 Token,长文本处理性能亮眼。
模型新增核心能力
- 原生深度思考推理
内置思考模式,可通过 “ 标签开启链式思考;模型能够分步拆解数学、逻辑难题,大幅提升复杂问题解答质量,也可通过指令关闭思考模式,直接输出答案。 - 原生函数/工具调用
G1 基底版本原生支持工具调用,可直接构建 Agent 工作流,完成联网检索、外部接口调用等任务,不再需要额外二次微调。 - 多语种与代码能力
预训练数据集包含网页、代码、数学推理、指令对话数据,支持上百种语言,代码生成表现优秀。
本地部署生态友好
项目已经放出 GGUF 量化权重包,完整兼容 llama.cpp、Ollama 生态。开发者仅需一条命令即可在消费级显卡、CPU、移动端设备上面低成本离线部署,无需依赖云端 API。
ollama run mollysama/rwkv‑7‑g1:2.9b
现已提供 2.9B、7.2B、13.3B 等多个参数规格可供选择,适配从边缘设备到高性能单卡的各类硬件环境。
赛道意义
长久以来,Agent、复杂推理任务普遍被认为是 Transformer 架构的优势领域。RWKV7‑G1 的落地代表纯 RNN 路线补齐了智能体短板,为本地优先、离线常驻助手、超长文档处理场景,提供了一条显存占用不会随上下文膨胀的全新技术方案。
© 版权声明
文章版权归作者所有,未经允许请勿转载。