面壁智能(ModelBest)正式发布了 MiniCPM5-2B,这是继 MiniCPM5-1B 之后 MiniCPM5 系列的第二款力作。作为一款面向端侧、本地部署和资源受限场景的 2B 稠密 Transformer 模型,MiniCPM5-2B 不仅在参数量上实现了翻倍,更在性能上达到了同尺寸开源模型的 SOTA(State-of-the-Art)水平,甚至在多项核心指标上超越了部分 4B 级模型。
- GitHub:https://github.com/OpenBMB/MiniCPM
MiniCPM5-2B
核心亮点:小身材,大能量
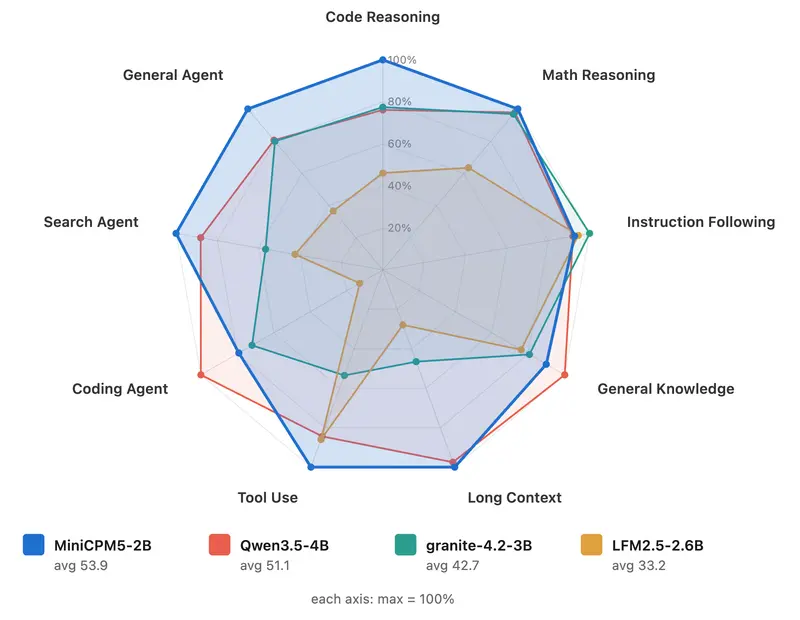
- 同尺寸 SOTA:在 LFM2.5-2.6B、Qwen3.5-2B、Gemma-4-E2B-it 等同尺寸模型的横向对比中,MiniCPM5-2B 以平均分 53.9 的成绩位居榜首,甚至超过了参与对比的所有更大规模模型(最高分 51.1)。
- 越级挑战能力:其整体表现可与 4B 级模型竞争,尤其在代码推理、数学推理、长文本处理、工具调用及 Agent 任务上展现出显著优势。
- 原生支持长上下文:拥有 131,072 (128K) 的超长上下文窗口,能够轻松处理长篇文档、复杂代码库和多轮对话历史。
- 高效架构:基于标准 LlamaForCausalLM 架构,采用 GQA(分组查询注意力),Q 头 16 / KV 头 2,层数 42,总参数量约 25 亿(非 Embedding 部分约 19.8 亿),确保了在端侧设备上的高效推理。
开源生态:数据与模型并重
面壁智能不仅开源了模型权重,还同步开放了其背后的高质量训练数据体系 UltraData,为社区提供了宝贵的研究资源:
| 数据集名称 | 内容描述 | 作用 |
|---|---|---|
| UltraX | 高质量网页预训练数据集 | 建立基础语言能力 |
| UltraData-Code | L0–L3 分级代码治理数据 | 显著提升代码生成与理解能力 |
| UltraData-SFT-Agent-2609 | 50 万 Agent 训练样本 | 赋能端侧 Agent 的综合规划与执行能力 |
| UltraData-RL-2609 | 超 8 万条高质量 RL 训练样本 | 覆盖数学、代码、通用知识与长文本推理,提升逻辑严密性 |
训练秘籍:RL + OPD 的双重加持
MiniCPM5-2B 的性能飞跃得益于其独特的后训练策略,特别是 强化学习(RL) 与 在线策略蒸馏(On-Policy Distillation, OPD) 的结合。
- Base & Mid-training:
- 采用逐级推进的训练配方,使用 Ultra-FineWeb、UltraX 等高质量语料建立稳定的基础语言能力。
- SFT(监督微调):
- 使用 400B tokens 的 deep-thinking SFT 数据,建立深度思考和通用对话能力。
- RL(强化学习):
- 使用 JustRL II 阐述的 critic-based 算法,针对数学、代码、Agent 和写作等方向训练专用 RL Teacher。
- 效果:RL 阶段在推理与通用能力上平均提升 10.96 分,Agent 能力平均提升 6.96 分。
- OPD(在线策略蒸馏):
- 能力合并:将 16 个 RL 训练所得的专家模型(含 5 个 agentic 专家)的能力蒸馏回同一个发布模型。
- 创新方法:在 response 序列的每个位置计算学生模型和教师模型 logits 的全词表反向 KL 散度作为优势估计值,替代传统的 verification-based advantage。
- 数据复用:直接复用各 RL teacher 训练时的 prompt 作为蒸馏数据,无需额外构造语料,极大提高了效率。
评测表现概览
在与 Qwen3.5-4B、granite-4.2-3B、Nemotron-3-Nano-4B 等更大规模模型的对比中,MiniCPM5-2B 依然保持了极强的竞争力:
- 代码与数学:得益于 UltraData-Code 和 RL 训练,其在复杂逻辑推理和代码生成任务上表现优异。
- Agent 任务:在工具调用、多步规划等 Agent 基准测试中,得分显著高于同尺寸基线,接近甚至超越部分 4B 模型。
- 长文本:128K 上下文窗口使其在处理长文档摘要、多轮对话记忆保持方面表现出色。
适用场景
- 本地个人助手:在笔记本电脑、高性能手机或边缘设备上运行,保护隐私的同时提供智能服务。
- Coding Agent:作为 IDE 插件的后端模型,提供实时的代码补全、解释和重构建议。
- 工具调用流程:在资源受限的环境中执行复杂的 API 调用和数据检索任务。
- 长文本分析:快速阅读和分析长篇报告、法律文档或技术手册。
© 版权声明
文章版权归作者所有,未经允许请勿转载。