基元律动(TokenRhythm)联合无问芯穹、清华大学、北京大学及阿里巴巴等机构,正式发布了 NeoHorse-1。这是业界首个明确以“Agent-Native”为设计理念的模型家族,包含 4B 和 9B 两个版本。NeoHorse-1 的核心突破在于将 Agent 在使用工具、接收反馈和修正错误过程中的执行轨迹转化为训练数据,探索通过路由框架实现模型的递归自我改进(Recursive Self-Improvement, RSI)。
- GitHub:https://github.com/TokenRhythm/NeoHorse
- 模型:https://huggingface.co/collections/TokenRhythm/neohorse-1
核心亮点:从“执行经验”到“模型能力”
1. 路由引导的代理后训练
NeoHorse-1 并非单纯依赖静态语料库,而是基于基元律动此前开发的开源 Routing Harness 系统 OpenSquilla 产生的执行轨迹进行训练。
- 数据源:保留了能力需求预测、路由选择、模型响应、工具调用和环境反馈的全链路信息。
- 训练方法:采用路由引导的课程 SFT 和路由引导的同策略蒸馏(On-Policy Distillation)。教师模型针对学生实际生成的内容提供指导,将执行中的成功经验与失败教训直接内化为模型参数。
2. 性能表现:小模型的大跨越
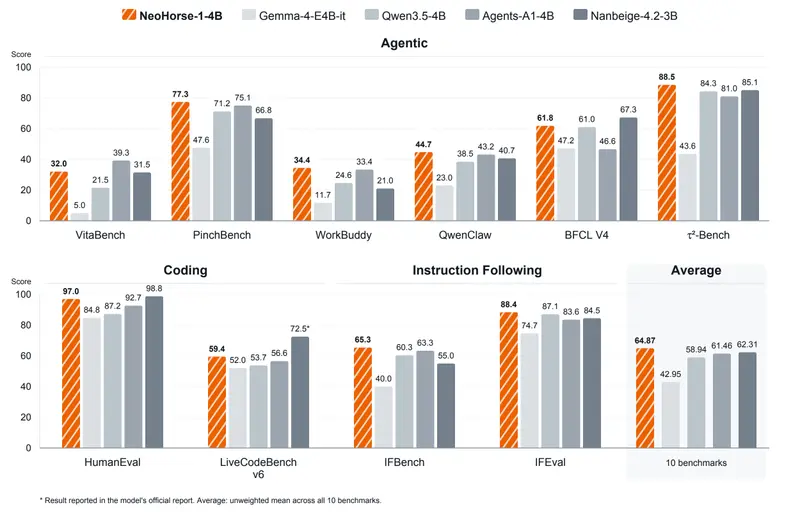
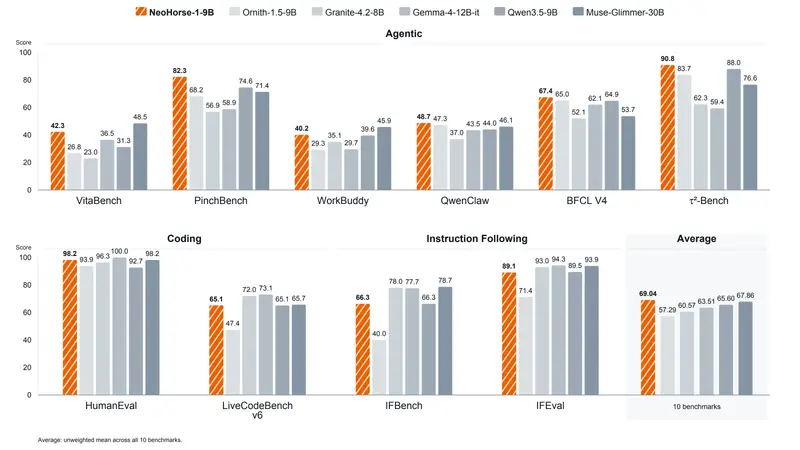
在涵盖 Agent 执行、工具交互、代码和指令遵循的 11 项基准测试中:
- NeoHorse-1-4B 在 4B 级模型中未加权平均分最高。
- 在五项关键基准上,4B 版本的表现甚至超过了 Qwen3.5-9B 底座。
- 改善主要集中在流程清晰、反馈可观察、结果可验证的任务上。虽然更大模型在复杂状态维护和长程调试中仍有优势,但 NeoHorse 证明了通过高质量轨迹训练,小模型也能获得极强的 Agent 执行力。
3. 高质量数据工程
团队对训练数据进行了极其严格的清洗与评估:
- 去重与去污染:精确移除重复数据,确保评估集的纯净。
- 六维语义评估:从目标完成度、证据一致性、错误恢复等多个维度对轨迹进行打分。
- 结构化标注:对子场景级的场景、目标和结果进行细粒度标注,确保模型学到的是逻辑而非巧合。
技术架构与生态协作
- 基础底座:基于阿里巴巴开源的 Qwen3.5-4B 和 Qwen3.5-9B 进行后训练,继承了其强大的原生多模态与长上下文能力(原生支持 262K 上下文,可扩展至 1M+)。
- 基础设施优化:无问芯穹提供了模型算法与芯片硬件的协同优化,显著提升了训练效率并降低了成本,加速了从任务信号处理到模型更新的迭代周期。
- 学术创新:清华与北大团队参与了算法设计,共同探索如何提高训练投入的能力回报,推动形成更陡峭的训练 Scaling 曲线。
为什么 NeoHorse-1 很重要?
- 验证了 RSI 的可行性:它证明了“Agent 执行 -> 评测暴露短板 -> 调整训练 -> 模型更新 -> 返回 Harness”这一闭环是有效的。这是迈向真正具备自我进化能力的 AI 系统的关键一步。
- 解决了“漏读邮件”式的幻觉问题:如开篇案例所示,传统模型容易忽略动态环境中的关键信息。NeoHorse 通过学习大量包含环境反馈的轨迹,学会了如何更谨慎地检查依赖、验证结果并从错误中恢复。
- 开源生态的协同典范:连接了模型底座(阿里)、算法研究(高校)、算力基础设施(无问芯穹)与 Agent 执行框架(基元律动),为国产开源模型的训练与迭代提供了一条可复制的路径。
模型下载与部署
| 检查点 | 参数量 | Hugging Face | ModelScope | 基础模型 |
|---|---|---|---|---|
| NeoHorse-1-4B | ~4B | Link | Link | Qwen3.5-4B |
| NeoHorse-1-9B | ~9B | Link | Link | Qwen3.5-9B |
- 权重格式:Safetensors / BF16
- 接口:文本输入/文本输出
- 适用场景:4B 版本适合轻量级本地部署或边缘设备;9B 版本适合需要更高容量和复杂推理的服务端部署。
© 版权声明
文章版权归作者所有,未经允许请勿转载。