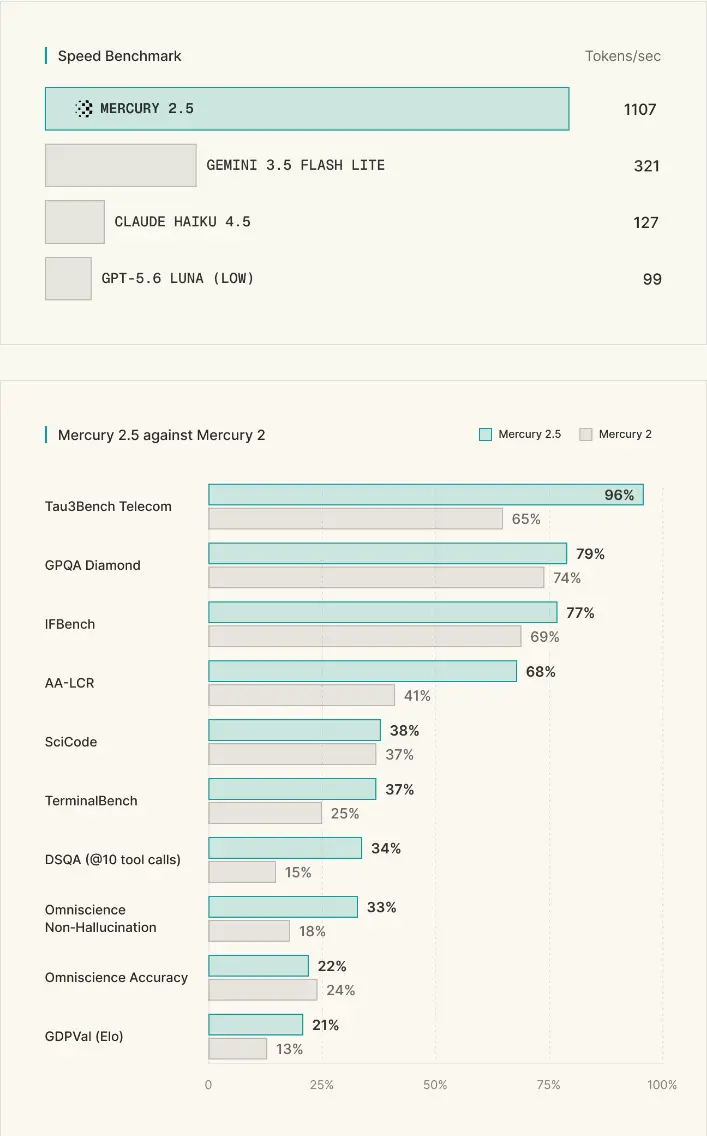
Inception正式推出Mercury 2.5,官方将其定义为目前能力最强的扩散式大语言模型,同时也是当前训练规模最大的扩散模型。对比上一代Mercury 2,新版本智能能力提升40%,并且保留了原方案低延迟、低成本的服务特性,综合质量可以对标多款成本优化的前沿模型,包括GPT-5.6 Luna、Gemini 3.5 Flash-Lite与Claude Haiku 4.5。
- 地址:http://chat.inceptionlabs.ai
Mercury 2.5在通用NVIDIA显卡上可实现每秒1107令牌的生成速度,上下文窗口最高支持26万token。模型自带可调推理、并行工具调用,还支持对齐规范的JSON输出。定价方面,标准价格为每百万输入token 0.2美元、输出token 0.75美元;上线阶段提供8折优惠,优惠后输入仅0.04美元/百万token,输出0.15美元/百万token。
本次迭代建立在Mercury 2的落地经验之上。上一代模型已经积累数千开发者进行开发,数十家企业落地生产,调用规模实现十倍级增长。来自真实业务场景的用户反馈与线上故障案例,成为Mercury 2.5调整评测标准与训练目标的依据,这也是这套反馈闭环产出的首个新版本。
模型主打对延迟高度敏感的场景:搜索、语音交互与代码系统。搜索类智能代理往往需要连续数十轮调用,完成任务规划、查询改写、结果重排、事实整理、来源摘要和答案校验。OpenCall就使用Mercury处理实时客户通话,整体响应中位数延迟接近170毫秒;P99响应耗时从数分钟缩短至1秒,P50延迟(包含推理)从0.4秒压到0.2秒以内。
另一个案例来自Augment Code,团队用Mercury完成上下文压缩、模型路由和MCP工具检索。把上下文压缩任务迁移到该模型后,延迟直接下降82%,由原来150秒缩短到27秒,成本削减90%,输出质量没有衰减,工具检索摘要任务可以在1秒内完成。
除主模型外,Inception同步放出Mercury Voice与Mercury Router的预览版本。Mercury Voice面向语音代理场景,首token生成时间低于170毫秒;Mercury Router负责分析用户提示词,在开源与闭源模型之间做调度,平衡质量、速度与开销。
Mercury 2.5可以通过Inception自有聊天产品、API,以及Baseten、OpenRouter平台调用。官方提供1亿免费API令牌供试用,企业客户还能申请专属算力、自动扩缩容、合规管控以及自定义数据留存策略。与此同时,Inception已经启动下一代更大规模模型的训练,计划在未来数月发布,并且不会牺牲扩散模型本身的速度与token效率优势。
© 版权声明
文章版权归作者所有,未经允许请勿转载。