在大模型领域,英伟达 的 CUDA 生态长期占据主导地位。但 AMD 正在通过开源全栈方案打破这一局面。近日,AMD 正式发布了 Instella-MoE-16B-A3B,这是一款完全在 AMD Instinct MI300X 和 MI325X GPU 上从头训练的混合专家(MoE)语言模型。
- 官方介绍:https://rocm.blogs.amd.com/artificial-intelligence/instella-moe/README.html
- GitHub:https://github.com/AMD-AGI/Instella-MoE
- 模型:https://huggingface.co/collections/amd/instella-moe
与以往仅发布权重不同,AMD 此次开源了包括数据混合、训练配置、推理代码以及每个训练阶段的权重在内的全套资产。这不仅是一个模型,更是一套基于 ROCm 生态的端到端训练最佳实践。
核心规格:小激活,大容量
Instella-MoE 采用了高效的 MoE 架构,旨在平衡模型容量与推理成本:
- 总参数量:160 亿(16B)。
- 活跃参数量:每 Token 仅激活 28 亿(2.8B)。这意味着在推理时,其计算负载远低于传统稠密模型。
- 上下文长度:支持高达 64K 的长文本窗口。
- 架构细节:27 层,隐藏大小 2048,词汇表规模约 12.9 万。每个 MoE 层包含 2 个共享专家和从 64 个路由专家中选出的 6 个。
两大系统级创新:速度提升的关键
为了实现高效的专家并行服务,AMD 在架构上引入了两项关键技术创新:
- 门控多头潜在注意力(Gated MLA):
在传统的多头潜在注意力基础上,添加了一个轻量级的学习输出门。这有助于模型更精准地控制信息流,提升表征能力。 - FarSkip-Collective 连接:
这是一种通信优化技术。它将过时和部分激活的数据传递到 MoE 和注意力层,使得专家并行的通信过程能与计算过程重叠。- 效果:预训练速度提升了 12.7%,首令牌时间(TTFT)最多减少了 39.2%。这对于降低推理延迟至关重要。
训练流程与性能表现
Instella-MoE 的训练完全基于 AMD 的软件栈(ROCm、Primus 和 Miles 框架):
- 预训练:使用了 7.1T Token 的开放语料库。
- 长上下文扩展:通过 YaRN 技术将窗口从 4K 扩展至 64K。
- 后训练:依次进行了 SFT(监督微调)、DPO(直接偏好优化)以及基于 Miles 框架的 RL(强化学习)。
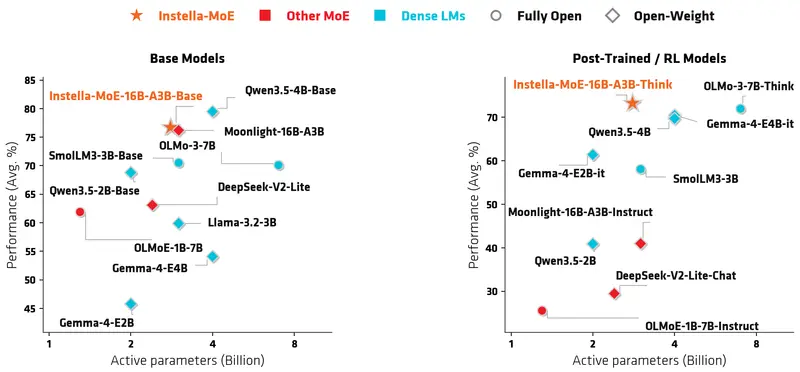
在基准测试中,Instella-MoE 展现了强大的竞争力:
- 基础模型平均分:76.7,在完全开放的同类模型中表现最强。
- 指令遵循能力:经过后训练,IFEval 分数从 77.08 提升至 83.70。
- 推理思维链:Think 模式下的平均分为 73.22,同样领先于开源同行。
部署与许可:研究优先,商用受限
对于希望尝试该模型的开发者,需要注意以下几点:
- 硬件要求:BF16 格式下,160 亿参数的权重约占 32 GB 显存。这意味着单张高显存的 AMD 加速器(如 MI300X)即可运行。
- 软件支持:AMD 提供了基于 SGLang 的推理代码,方便集成到现有工作流中。
- 许可限制:
- 模型权重:采用 ResearchRAIL 许可,仅限学术和研究用途,不可直接商用。
- 训练代码:采用 MIT 许可,这是更具价值的资产,企业可以自由复用其训练流程和优化技巧。
© 版权声明
文章版权归作者所有,未经允许请勿转载。