在 AI 智能体(Agent)日益普及的今天,云端 API 的成本、延迟和隐私顾虑始终是悬在开发者头上的达摩克利斯之剑。Liquid AI 今日发布的 LFM2.5-2.6B 试图彻底改变这一现状。这是一个专为设备端运行设计的 26 亿参数智能体模型,它足够小,可以在手机上流畅运行;足够快,能在 CPU 上保持实时响应;又足够强大,能够独立驱动规划、工具调用和多步骤任务处理。
- 模型:https://huggingface.co/LiquidAI/LFM2.5-2.6B
核心突破:打破“云依赖”,实现真正的本地智能
LFM2.5-2.6B 的最大价值在于它将智能体的运行成本降为零边际成本。
- 隐私优先:所有推理均在本地完成,数据不出设备。
- 无限并发:消除了按 Token 计费的限制,开发者可以大规模并行化后台任务,让智能体全天候运行而无需担心账单爆炸。
- 极致速度:得益于高效的 LFM2 架构,它在 M5 Max 芯片上的解码速度高达 220 tokens/秒,在 Ryzen AI Max+ 395 上为 113 tokens/秒,甚至在手机端也能达到 30 tokens/秒。这意味着一个功能完整的智能体可以在你的口袋里即时响应。
训练哲学:从“通用”到“专家”的蒸馏之路
为了在极小的参数量下实现强大的智能体能力,Liquid AI 采用了一套精密的四阶段后训练流程:
- 监督微调 (SFT):使用比 LFM2.5-8B-A1B 多七倍的数据量进行广泛覆盖,重点强化智能体任务、推理和工具使用。
- 教师专业化:从共享的 SFT 检查点出发,为指令遵循、数学、代码、工具使用等特定领域训练独立的专家模型,并通过强化学习(RLVR)进行深度优化。
- 多域策略内蒸馏 (MOPD):这是关键一步。学生模型在自身策略下生成输出,而各领域的专家教师提供令牌级反馈。这种路由化的监督帮助学生快速收敛,将多个专家的能力整合进单个小模型中。
- 智能体强化学习 (Agentic RL):在真实的智能体框架(如 OpenClaw、Hermes Agent)沙箱中进行多轮训练,让模型在实际生产力任务中学习如何可靠地调用工具和自动化工作流。
性能表现:小身材,大能量
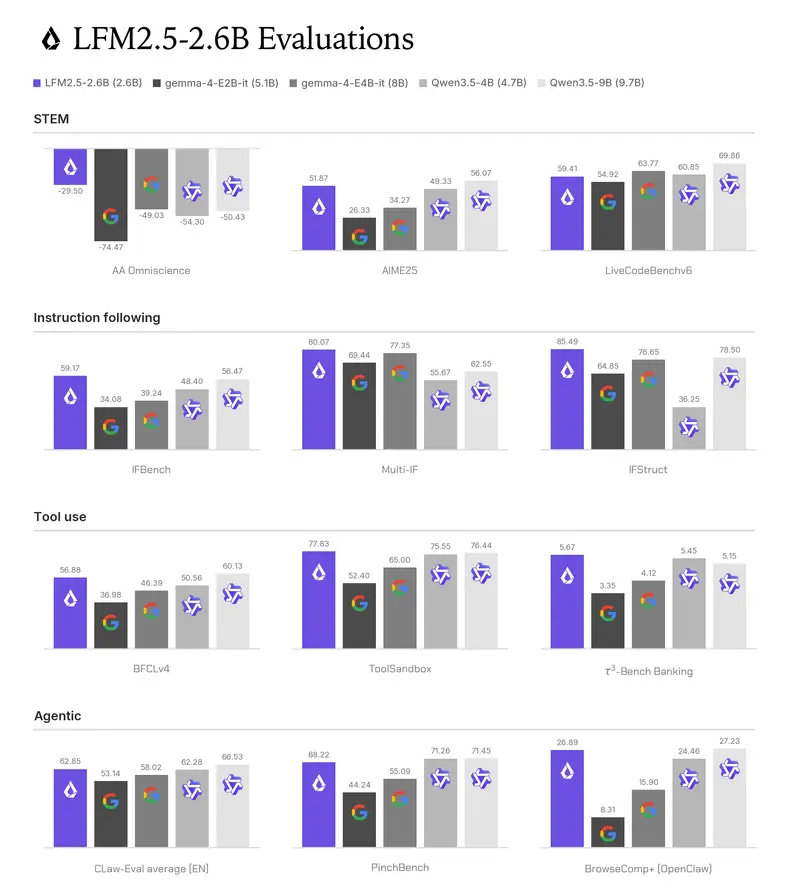
尽管只有 2.6B 参数,LFM2.5-2.6B 在多项基准测试中展现了惊人的竞争力,甚至超越了许多四倍于其大小的模型:
| 基准 | LFM2.5-2.6B (2.6B) | Gemma-4-E4B-it (8B) | Qwen3.5-9B (9.7B) |
|---|---|---|---|
| LiveCodeBenchv6 | 59.41 | 63.77 | 69.86 |
| IFBench | 59.17 | 39.24 | 56.47 |
| Multi-IF | 80.07 | 77.35 | 62.55 |
| ToolSandbox | 77.83 | 65.00 | 76.44 |
| Claw-Eval (Avg) | 62.85 | 58.02 | 66.53 |
它在指令遵循和工具使用基准上几乎全面领先,仅在极度复杂的编码任务上略逊于更大的 Qwen 模型。对于边缘设备上的高吞吐量工作负载而言,它是目前的最佳选择。
生态支持:首日即快,随处部署
LFM2.5-2.6B 提供了广泛的推理后端支持,确保你可以在任何硬件上高效运行:
- llama.cpp:提供 GGUF 检查点,适合 CPU 和边缘设备推理。
- MLX:针对 Apple Silicon 深度优化。
- vLLM / SGLang:适合 GPU 加速的高吞吐生产环境。
- ONNX:跨平台兼容性。
© 版权声明
文章版权归作者所有,未经允许请勿转载。