蚂蚁集团旗下 inclusionAI 今日正式推出下一代原生混合推理模型 Ling-3.0-flash。该模型以 124B 总参数和仅 5.1B 激活参数的极致稀疏化设计,在关键基准测试中持平甚至超越了此前 1T 级旗舰模型 Ring-2.6-1T 的表现,为生产环境中的复杂代理(Agent)工作流提供了兼具高性能与低成本的解决方案。
- 模型:https://huggingface.co/collections/inclusionAI/ling-30
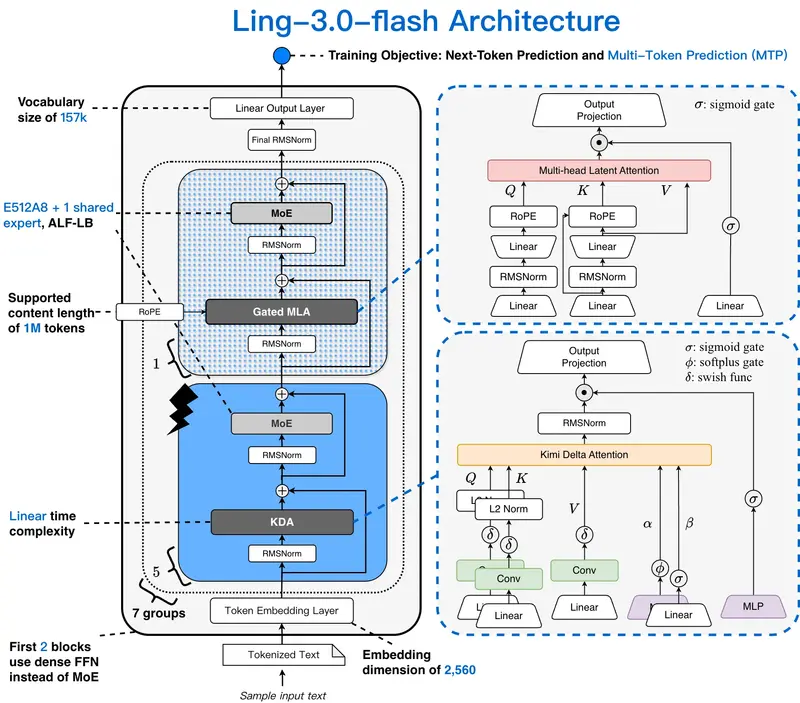
核心架构:原生混合线性注意力 + 稀疏 MoE
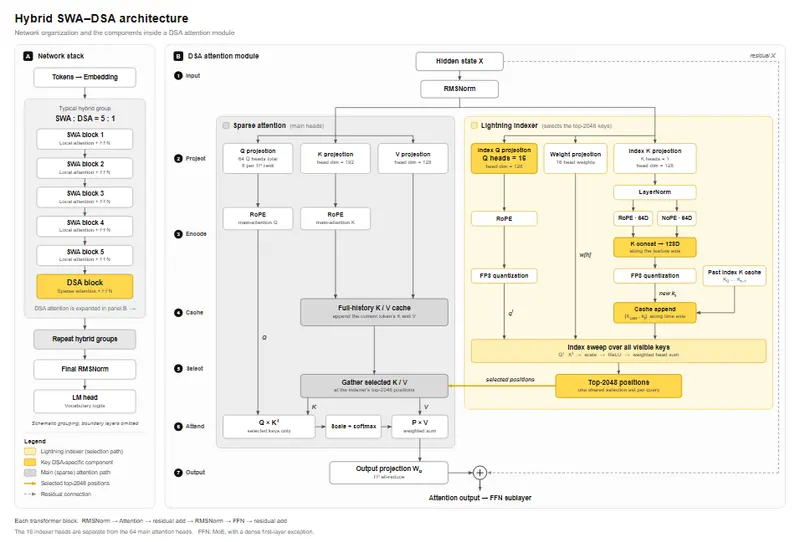
Ling-3.0-flash 从预训练之初就采用了创新的 原生混合线性注意力架构,通过 Kimi Delta Attention (KDA) 与 Multi-Head Latent Attention (MLA) 的交替堆叠(比例 5:1),实现了长上下文处理效率与计算成本的协同跃升。
- 细粒度控制:升级了 KDA 细粒度对角门控机制,配合 1/64 稀疏 MoE 结构,确保在每个 Token 生成时仅激活极小部分参数。
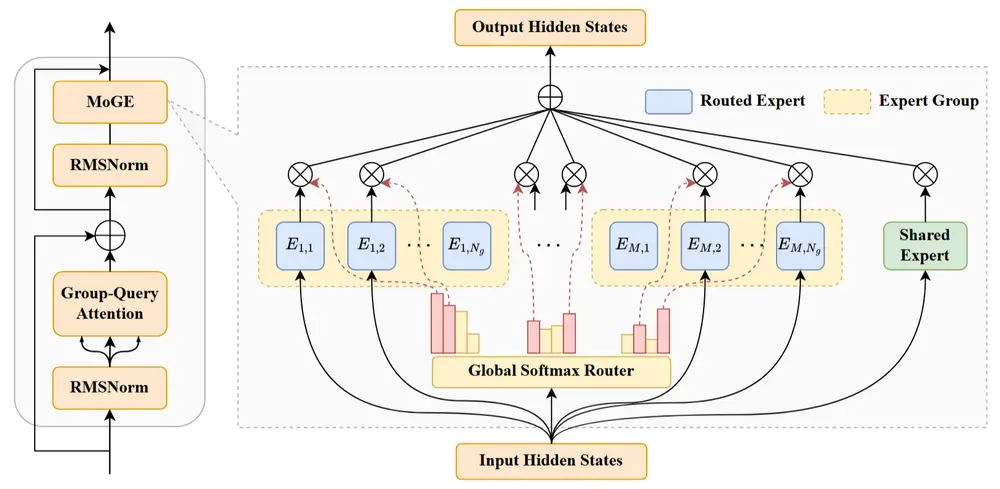
- 高效路由:拥有 512 个路由专家和 1 个共享专家,每次仅激活 8 个专家,在保持模型容量的同时大幅降低推理开销。
- 长上下文支持:训练计划覆盖从 8K 到 256K 的上下文长度,使其在处理超长文档和多轮对话时依然保持卓越的记忆与理解能力。
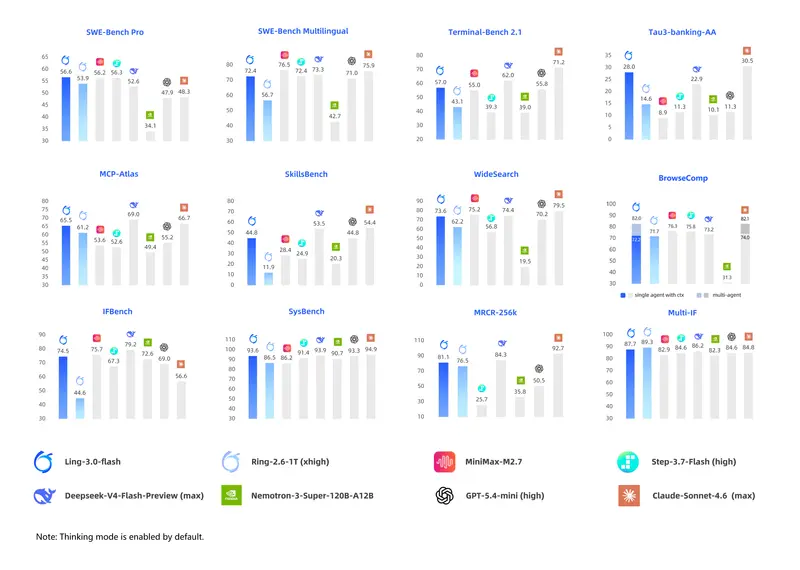
性能突破:专为代理工作流而生
Ling-3.0-flash 并非通用聊天模型的简单缩小版,而是专为实际生产力场景量身定制的“代理进化”模型:
- 端到端闭环执行:整合了 10,000+ 个交互式训练环境,在编码、通用任务及深度研究代理任务上实现了从规划到执行的完整闭环。
- 分层缓存加速:原生集成 SGLang HiCache + Mooncake 分层缓存架构,利用物理双池和集群共享 L3 缓存,消除了长时交互中的冗余重算。
- 首 Token 时间 (TTFT) 降低 60%-80%:在长输入场景下显著提升响应速度,带来更流畅的用户体验。
- 基准测试领先:在 SWE-Bench Pro、SWE-Bench Multilingual、Tau3-banking-AA、MCP-Atlas 和 SkillsBench 等代表性代码与代理基准上表现强劲,全面超越更大体量的 SOTA 竞争产品。
生态兼容:无缝接入主流框架
Ling-3.0-flash 在设计上充分考虑了开发者的使用习惯,已在多个主流 Agent 框架中提供出色的用户体验,包括:
- Claude Code
- Kilo Code
- Qwen Code
- Hermes Agent
- OpenClaw
© 版权声明
文章版权归作者所有,未经允许请勿转载。