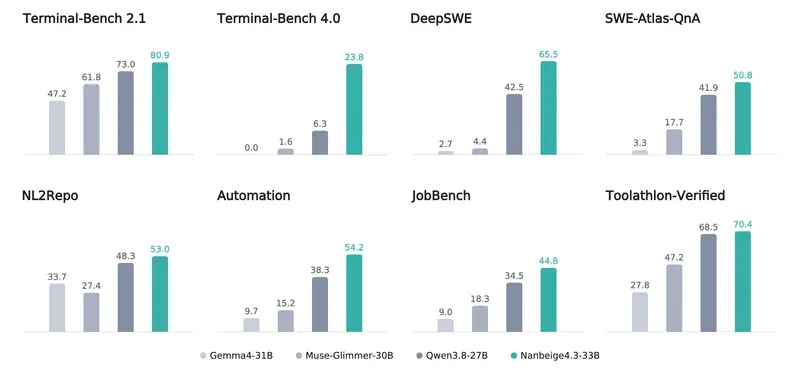
BOSS直聘旗下的人工智能团队南北阁(Nanbeige)正式开源了 Nanbeige4.3-33B。作为一款总参数量约 330 亿的稠密(Dense)语言模型,它不仅原生支持高达 512K 的超长上下文窗口,更在多项权威代理(Agent)编码、协作与推理基准测试中取得了领先于同量级前沿模型(如 Qwen3.8-27B、Muse-Glimmer-30B 和 Gemma4-31B)的卓越成绩。
- 模型:https://huggingface.co/collections/Nanbeige/nanbeige43
核心定位:推高轻量级 Agent 性能天花板的“旗舰教师”
Nanbeige4.3-33B 的发布并非孤立的产品更新,而是南北阁推高轻量级代理模型性能边界的战略性第一步。团队采取了“先构建高容量教师代理,再进行能力蒸馏”的研发策略。
- 强大的即时部署能力:作为约 30B 参数级别开放模型中的 SOTA(当前最佳)代表,它本身即为处理真实世界复杂任务提供了一个强大且推理成本高效的选项。
- 蒸馏管道的核心基座:该模型被明确设计为 Nanbeige4.3 系列的旗舰教师模型,其积累的先进代理能力将直接用于驱动即将推出的更小规模模型(如 Nanbeige4.3-3B)的蒸馏训练,从而在保持低推理成本的同时,最大化小模型的性能表现。
卓越的性能表现:全面领先的 Agent 能力
在统一的推理超参数和测试 harness 下,Nanbeige4.3-33B 在“最高思考努力”模式下展现了压倒性的优势:
- 代理编码(Agentic Coding):在极具挑战性的真实代码库任务中表现优异。例如,在 Terminal-Bench 2.1 中得分高达 80.9(Qwen3.8-27B 为 73.0),在 DeepSWE 中达到 65.5(Qwen3.8-27B 为 42.5),并在 SWE-Bench Pro 和 NL2Repo 等基准上均保持领先,展现了极强的代码理解、修改与多步调试能力。
- 代理协作(Agentic Collaboration):在需要复杂规划、工具调用和多环境交互的任务中优势显著。在 Automation Bench 中得分 54.2,在 JobBench 中得分 44.8。尤为亮眼的是在模拟商业环境的 YC-bench 中,其创造的虚拟价值高达 $1,025,437,远超其他对比模型。
- 硬核逻辑推理:在保留强大 Agent 能力的同时,模型的基础推理能力并未妥协。在 GPQA Diamond 科学问答中取得 89.5 的高分,在极具难度的 AIME 2026 数学竞赛基准中更是达到了 95.2 的顶尖水平。
工程优势与生态兼容
- 512K 原生长上下文:支持超长文档、大型代码库或复杂多轮对话的完整输入,为处理真实世界的大规模信息检索与整合任务提供了坚实基础。
- 主流 Harness 无缝集成:模型设计充分考虑了工程落地,能够以成本高效的推理方式无缝集成到主流的智能体工作流框架中,确保在真实业务场景下的稳定输出。
- 稠密架构的稳定性:相较于同参数量的 MoE(混合专家)模型,33B 的 Dense 架构在作为教师模型进行知识蒸馏时,能够提供更稳定、更密集的特征表示和梯度信号,有助于小模型更高效地学习复杂逻辑。
© 版权声明
文章版权归作者所有,未经允许请勿转载。