韩国知名游戏企业 KRAFTON(魁匠团)旗下的人工智能分支 KRAFTON AI 近日正式公布了其从头训练的 Raon-1 mini 模型预览版。作为一款总参数量约 30B(28.8B)、激活参数量仅 4.3B(A4B)的混合专家(MoE)语言模型,Raon-1 mini 在保持卓越多语言与代理执行能力的同时,实现了显著的速度与内存效率提升。该模型以 Apache 2.0 协议开源,并已在官网提供限时免费 API 试用。
核心架构创新:高效的混合 MoE 布局
Raon-1 mini 在架构设计上进行了深度优化,旨在平衡长上下文处理能力与推理成本。其 25 层网络采用了一种创新的混合布局:
- Raon Delta Attention (RDA):模型中的 18 层采用了 RDA 架构。该技术解耦了 Kimi Delta Attention 的擦除和写入门,在无需位置编码(NoPE)且保持固定大小状态的情况下,显著改善了长上下文性能。
- 门控 MLA(混合布局):剩余的 7 层保留了门控多头潜在注意力(MLA)机制以维持 KV 缓存。这种混合设计使得在 BF16 精度下,每 token 的 KV 缓存占用被严格控制在约 8 KiB,极大缓解了长文本推理的显存压力。
- Raon-mHC 优化:模型引入了 Raon-mHC(流形约束超连接),有效降低了类似 DeepSeek mHC 架构的计算成本,从而大幅加速了模型的训练过程。
- 稀疏 MoE 路由:模型包含 128 个路由专家,每个 token 仅激活其中的 6 个路由专家与 1 个共享专家,实现了极高的计算效率。
卓越的性能表现与多语言能力
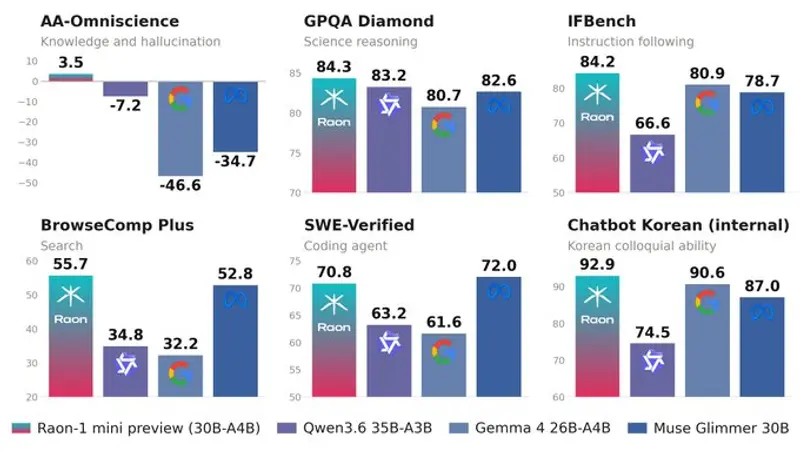
- 内置推理与指令遵循:Raon-1 mini 具备原生的“思考”能力,在多项数学和科学基准测试中取得领先结果。同时,其在指令遵循和搜索类任务上的表现优于同量级的对比模型。
- 强大的代理(Agent)执行:模型原生支持工具调用,可无缝接入 Hermes Agent、Pi 和 OpenCode 等主流代理工作流,胜任复杂的自动化任务。
- 多语言原生支持:虽然以韩语对话为核心优势,但模型在训练阶段涵盖了英语、日语、中文、西班牙语、法语和泰语,展现出扎实的跨语言泛化能力。原生支持高达 262,144 token 的超长上下文窗口。
极致的推理优化与部署友好性
为了降低开发者的使用门槛并提升生产环境的效率,Raon-1 mini 提供了全面的推理加速方案:
- 推测解码支持:官方配套提供了 DFlash2 草稿模型,通过推测解码技术进一步打破推理速度瓶颈。
- 先进的量化格式:模型提供 MXFP8 和 NVFP4 两种量化选项。特别是 NVFP4 格式,使得该模型能够在单块 32GB VRAM 的 NVIDIA RTX 5090 GPU 上流畅运行,为本地化、私有化部署提供了极具性价比的硬件方案。
© 版权声明
文章版权归作者所有,未经允许请勿转载。