Reflection AI正式推出首款前沿开放权重模型Beam,作为仅文本稀疏混合专家模型,主打编码、推理与AI智能体任务。官方宣称,在高级推理基准上性能可对标国内头部开放模型,推理所需计算量相比竞品降低3~4倍,西方开源大模型赛道竞争进一步升温。
- 申请地址:https://platform.reflection.ai
Beam为MoE架构,总参数5010亿,激活参数230亿,在23.8万亿token数据集完成预训练,支持最高100万上下文窗口。作为对比,智谱GLM-5.2总参数约7440亿,激活参数400亿。模型核心亮点是大规模高计算强化学习,动用10500张NVIDIA GB300 GPU,连续训练四周,产出超1亿条交互rollout,搭建近百万个高质量编码、STEM与工具使用训练沙箱。
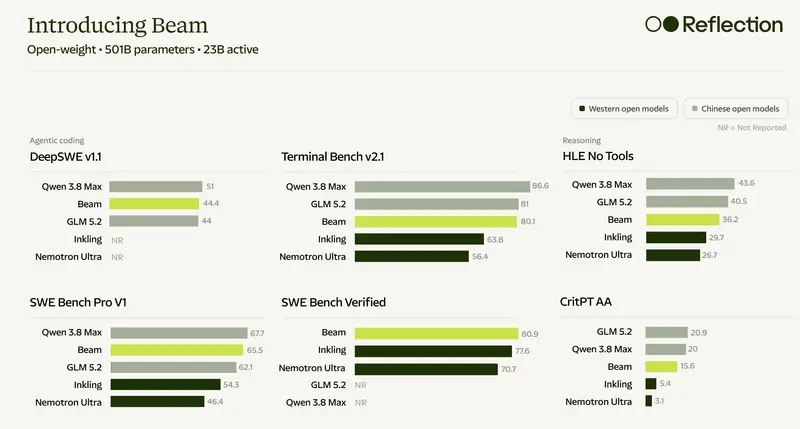
性能方面,官方自测结果显示,Beam推理能力和GLM-5.2持平,超越当前主流西方开放模型;编码基准得分高于Inkling。需要注意,Inkling属于多模态模型,而Beam目前仅支持文本输入。即便对比Qwen3.8-Max这类超大参数模型,Beam在推理成本上依然具备显著优势。用户还可以调节推理努力参数,按需平衡输出长度、回答质量与算力开销。
技术亮点
- MoE稳定优化:基于无辅助损失负载平衡方案改进,加入余弦衰减专家偏置更新,搭配深度缩放、SandwichNorm等技术,稳定残差流,保障专家均匀激活,为后续大规模RL打下基础。
- 高质量数据管线:预训练海量网页、代码、STEM技术文档,自研质量分类器筛选数据,淘汰大量低质网页内容,保留海量高质量技术文本;单独针对不同编程语言做数据均衡与清洗。
- 异步强化学习基础设施:全异步rollout与模型更新架构,新权重分发速度快,集群故障弹性强,可同时支撑17万并发沙箱环境,训练资源利用率最高达92.3%。
- 对齐与安全体系:采用多教师on-policy蒸馏、审议对齐技术,对抗性迭代构建安全数据集,抑制幻觉、越狱与过度拒绝问题,后续会开放安全评估套件。
项目背景与商业化定位
Reflection由两位前Google DeepMind研究员2024年创立,已经拿到包含英伟达、红杉在内约47亿美元融资,投前估值250亿美元。企业提前锁定算力,和SpaceX、Nebius签下70亿美元协议,保障2029年前持续获取GB300芯片。
产品面向企业、公共机构,主推“AI工厂”方案,帮助机构在自有私有数据上微调模型,搭建本地定制AI系统。目前已经和韩国新世界集团开展主权AI工厂试点,对冲基金、量化交易公司也是目标客户。
模型计划本月以Apache2.0许可证正式开放权重、技术报告与全套开发工具,接入各大云厂商与开源框架。现阶段正在红队安全测试,开发者可以注册等候名单获取早期访问权限。
要点小结
- 模型规格:501B总参数MoE,23B激活参数,1M上下文,纯文本模型,强编码、智能体能力
- 核心卖点:同等推理性能,推理计算量相比竞品少3~4倍;依托超大规模强化学习训练
- 竞争定位:对标GLM、Qwen等国内开源模型,直面Mistral、Meta、Inkling等西方开放模型以及OpenAI、Anthropic闭源模型
- 落地方向:企业私有化本地部署、机构AI工厂、量化与科研场景,Apache2.0开源
- 限制:仅文本,无原生多模态能力;性能结论为厂商自测,尚未经过第三方独立验证
© 版权声明
文章版权归作者所有,未经允许请勿转载。