清华与微软推出 TRELLIS.2:单图生成带透明材质的 3D 资产由清华大学、微软研究院与中国科学技术大学联合推出,TRELLIS.2 是一个参数量达 40 亿 的先进 3D 生成模型,专为从单张图像生成带完整 PBR 材质的高分辨率 3D 资产而设计。 项目主页...3D模型# 3D模型# TRELLIS.210个月前3890
HY-World 1.5:腾讯混元实时交互式 3D 建模框架,24FPS + 几何一致性双突腾讯混元团队推出的HY-World 1.5,凭借核心模块WorldPlay流式视频扩散模型,成功打破了现有3D世界生成模型“实时交互”与“长期几何一致性”不可兼得的技术瓶颈,实现了24 FPS的实时流...3D模型# HY-World 1.5# 腾讯10个月前4830
Meta AI发布SAM 3D:单图生成3D模型,开源全工具链+商业落地同步推进Meta AI近日推出 Segment Anything 模型家族的全新成员——SAM 3D,这是首个具备常识级 3D 理解能力的模型,可直接将普通 2D 照片转化为细节丰富的 3D 重建结果。此次发...3D模型# Meta AI# SAM 3D11个月前4740
腾讯混元推出 混元3D-Part:让3D模型像乐高一样“可拆解”在AIGC推动内容创作变革的当下,3D生成正成为下一个关键战场。然而,一个长期被忽视的问题是:大多数AI生成的3D模型都是“一体成型”的黑盒结果——无法拆分、难以编辑、不便生产。 腾讯混元推出 Hun...3D模型# Hunyuan3D-Part# 混元3D-Part1年前4820
腾讯混元推出 Hunyuan3D-Omni:统一框架实现多模态可控 3D 生成腾讯混元项目组近日发布 Hunyuan3D-Omni ——一个面向 3D 资产生成的统一框架,解决传统单图生成 3D 模型时存在的几何失真、姿态不可控等问题。 地址:https://3d.hunyua...3D模型# Hunyuan3D-Omni# 腾讯混元1年前4600
英伟达等提出 Lyra:基于自蒸馏的单图生成3D/4D场景新框架从游戏开发到机器人仿真,构建高质量虚拟环境的能力至关重要。然而,传统3D重建依赖多视角真实数据采集,成本高且难以规模化;而当前强大的视频扩散模型虽具备出色“想象力”,却受限于2D输出,无法满足需要空间...3D模型# Lyra1年前6710
SpatialGen:布局引导的多模态扩散模型,高效生成高保真3D室内场景在室内设计、VR/AR开发、机器人训练等领域,“高保真3D室内场景模型”是核心基础——设计师需要用它预览方案效果,VR设备需要靠它构建沉浸式环境,机器人则依赖它模拟真实导航场景。但长期以来,3D室内场...3D模型# 3D室内场景# SpatialGen1年前3600
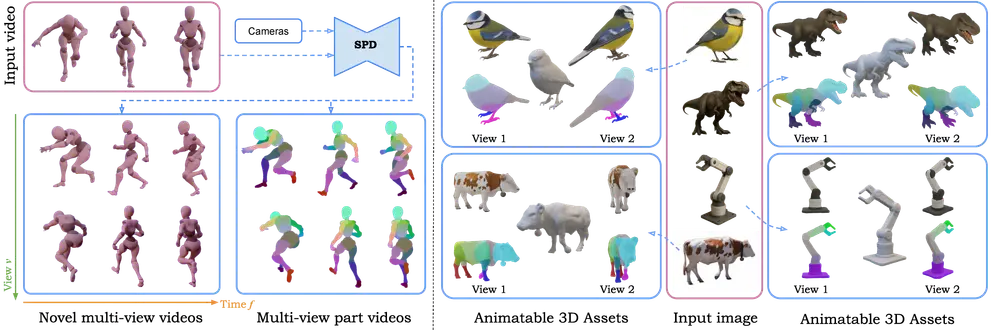
Stable Part Diffusion 4D:单目输入驱动多视图RGB与运动部件视频生成在动画制作、AR/VR开发、机器人运动规划等领域,“从单视角视觉信息生成多视图内容+结构化运动部件”是长期存在的技术难点——传统方法要么依赖多设备采集,要么难以保证运动部件在时间与空间上的一致性。 项...3D模型# SP4D# Stable Part Diffusion 4D1年前2930
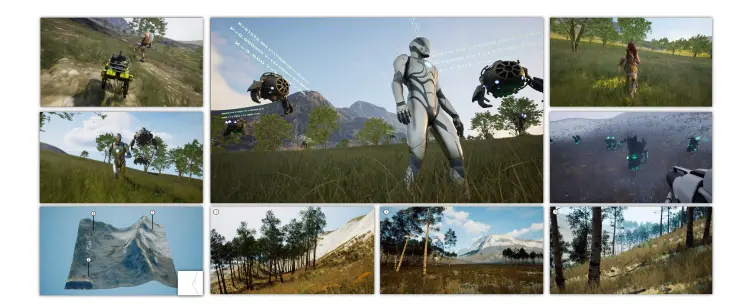
LatticeWorld:基于多模态指令的高效 3D 世界生成框架由网易、北京航空航天大学、清华大学与香港城市大学联合研究团队提出,LatticeWorld 是一个面向复杂 3D 虚拟环境自动生成的新框架。它通过融合轻量级大型语言模型(LLM)与工业级渲染引擎,探索...3D模型# LatticeWorld1年前2670
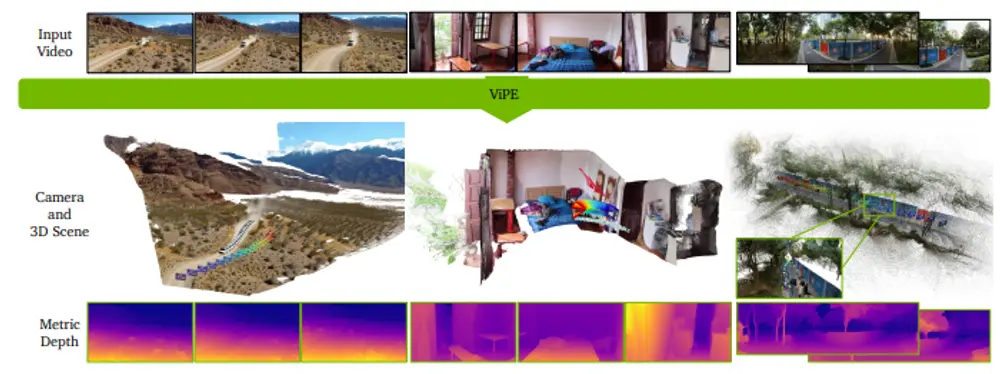
英伟达开源ViPE工具:从普通视频中精准提取3D信息,还附赠9600万帧标注数据集在空间AI领域,“3D几何感知”是许多技术落地的基础——无论是AR场景构建、自动驾驶环境感知,还是视频内容的3D重构,都需要精准的相机姿态、内参和深度信息。但长期以来,从野外随机拍摄的视频(如自拍、行...3D模型# ViPE# 英伟达1年前6520
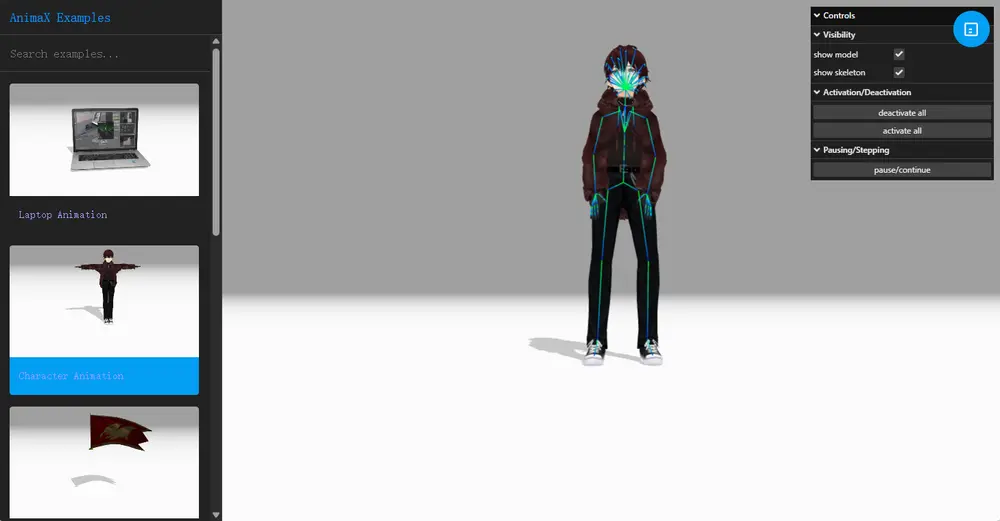
AnimaX:支持任意骨骼结构的高效 3D 动画生成框架由北京航空航天大学软件学院、清华大学、香港大学与 VAST 联合提出的新框架 AnimaX,为 3D 角色动画生成带来了一种高效且通用的解决方案。 项目主页:https://anima-x.githu...3D模型# 3D 动画生成# AnimaX1年前3460
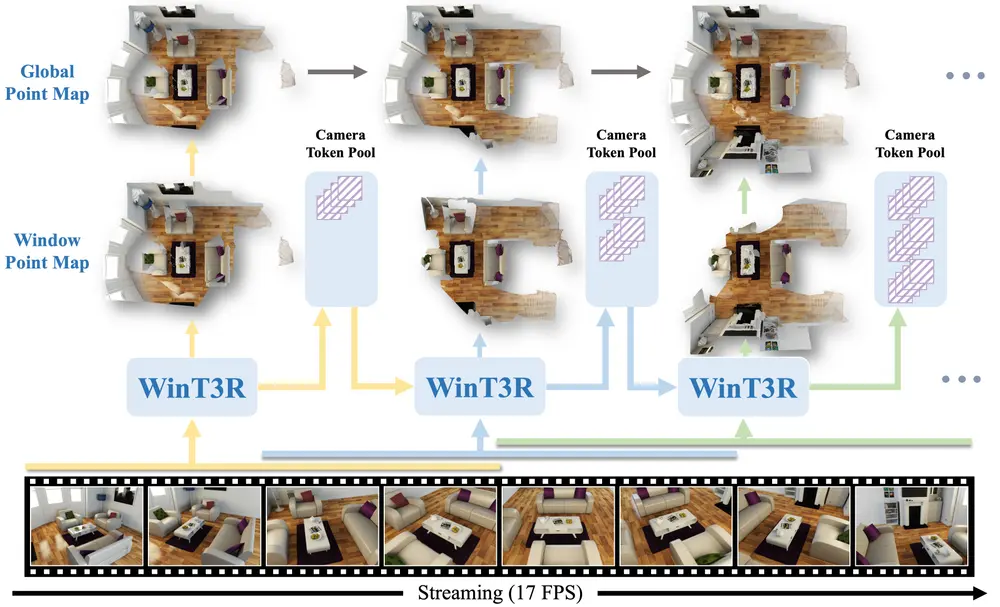
中科大等提出 WinT3R:一种兼顾高精度与实时性的在线 3D 重建新方法由中国科学技术大学、上海人工智能实验室、SII 与浙江大学联合提出的新模型 WinT3R(Window-based Streaming Reconstruction with Camera Token...3D模型# 3D 重建# WinT3R1年前4620