SD百科导航
  • 首页
  • 快讯
  • 早报
  • 模型
  • ComfyUI
  • 新技术
  • 百科
    • 教程
    • 硬件
    • 科普
  • 百科工具
    • 工具
  • 排行榜
    • 首页
    • 快讯
    • 早报
    • 模型
    • ComfyUI
    • 新技术
    • 百科
      • 教程
      • 硬件
      • 科普
    • 百科工具
      • 工具
    • 排行榜

    多模态大语言模型

    共 30 篇文章
    排序
    发布更新浏览点赞
    多模态大语言模型Omni-RGPT:在统一图像和视频的区域级理解

    多模态大语言模型Omni-RGPT:在统一图像和视频的区域级理解

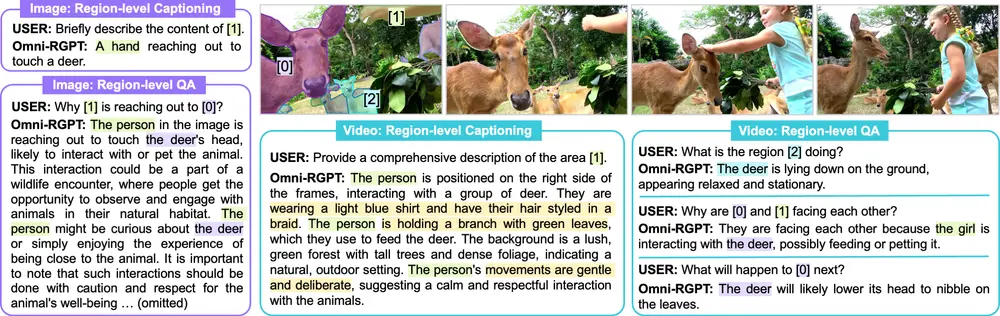
    英伟达和延世大学的研究人员推出多模态大语言模型Omni-RGPT,旨在统一图像和视频的区域级理解。Omni-RGPT通过一种新颖的区域表示方法——Token Mark,实现了对图像和视频中特定区域的深...
    新技术# Omni-RGPT# 多模态大语言模型
    2年前
    4070
    新型多模态大语言模型Sa2VA:将 SAM2 与 LLaVA相结合,实现对图像和视频的深入理解

    新型多模态大语言模型Sa2VA:将 SAM2 与 LLaVA相结合,实现对图像和视频的深入理解

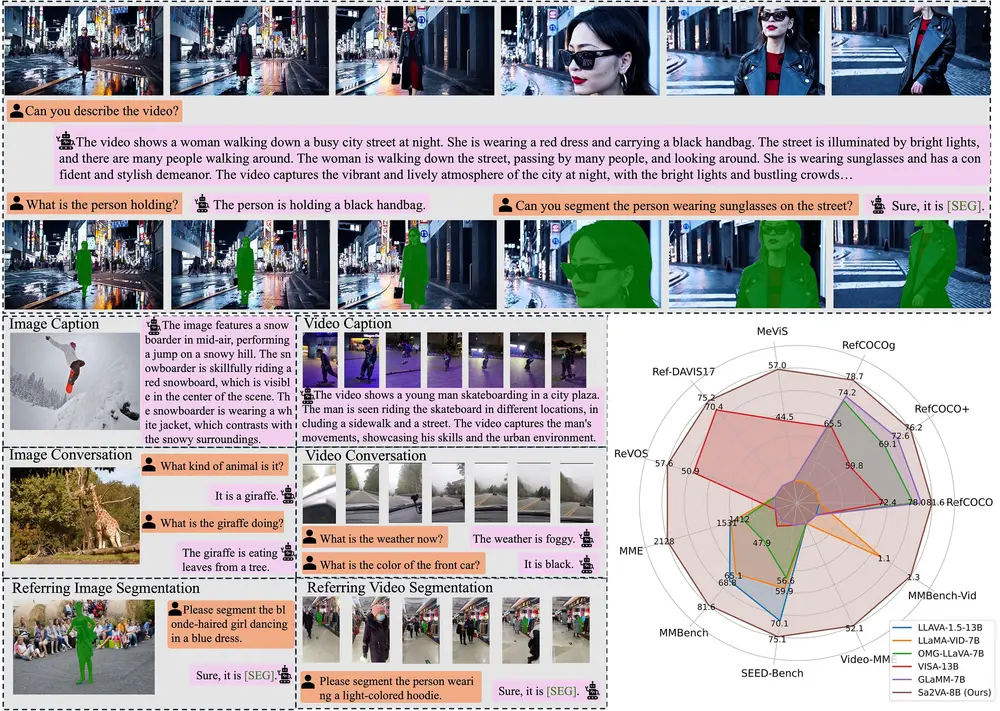
    加州大学默塞德分校、字节跳动、武汉大学和北京大学的研究人员推出新型多模态大语言模型Sa2VA,它将SAM-2视频分割模型与LLaVA视觉-语言模型相结合,实现了对图像和视频的密集、基于语义的理解。Sa...
    多模态模型# Sa2VA# 多模态大语言模型
    2年前
    4310
    任务偏好优化TPO:通过视觉任务对齐来提升多模态大语言模型的性能

    任务偏好优化TPO:通过视觉任务对齐来提升多模态大语言模型的性能

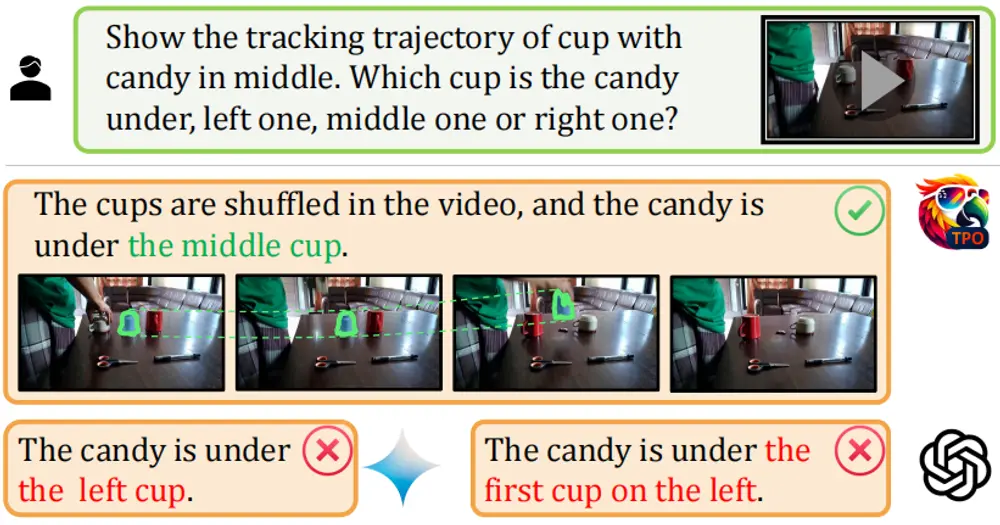
    上海人工智能实验室、浙江大学、中国科学技术大学、上海交通大学、中国科学院深圳先进技术研究院和南京大学的研究人员推出一种名为任务偏好优化(Task Preference Optimization, TP...
    新技术# TPO# 任务偏好优化# 多模态大语言模型
    2年前
    5790
    OLA-VLM:提升多模态大语言模型中的视觉感知能力

    OLA-VLM:提升多模态大语言模型中的视觉感知能力

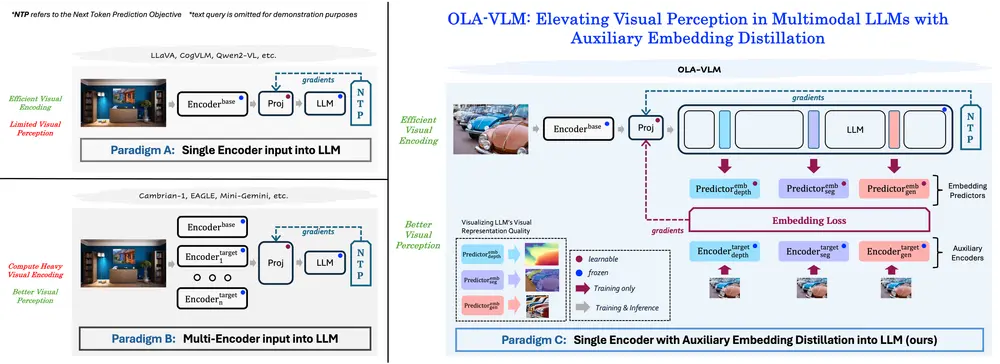
    开发当代多模态大语言模型(MLLMs)的标准做法是将视觉编码器的特征输入到大型语言模型(LLM)中,并通过自然语言监督进行训练。然而,这种方法存在一个潜在的局限性:仅依赖自然语言监督对于MLLM的视觉...
    新技术# OLA-VLM# 多模态大语言模型
    2年前
    4120
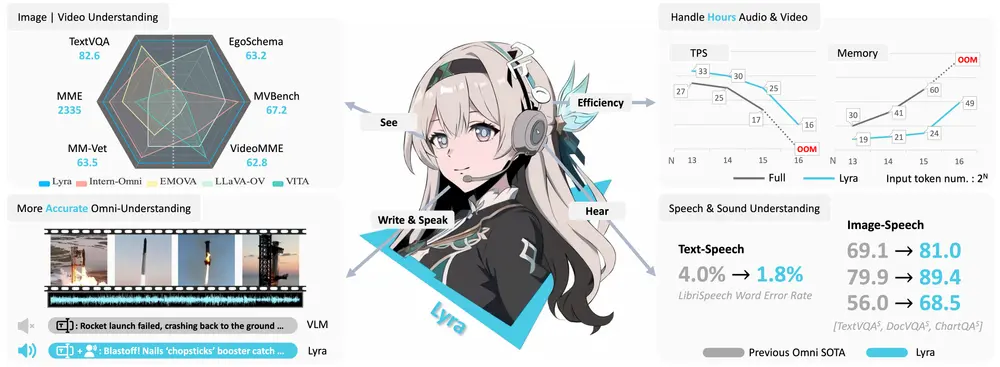
    多模态大语言模型Lyra:专注于增强多模态能力,特别是高级长语音理解、声音理解、跨模态效率和无缝语音交互

    多模态大语言模型Lyra:专注于增强多模态能力,特别是高级长语音理解、声音理解、跨模态效率和无缝语音交互

    随着多模态大语言模型(MLLMs)的发展,扩展到单一领域之外的能力对于满足更通用和高效AI的需求至关重要。然而,之前的全模态模型在语音处理方面存在不足,忽视了其与视觉、文本等其他模态的深度整合。为了解...
    多模态模型# Lyra# 多模态大语言模型
    2年前
    4980
    华为诺亚方舟实验室推出多模态大语言模型ILLUME

    华为诺亚方舟实验室推出多模态大语言模型ILLUME

    华为诺亚方舟实验室发布多模态大语言模型ILLUME,旨在无缝集成图像和文本的理解与生成。ILLUME凭借其创新的架构和训练策略,在显著减少预训练所需数据量的同时,达到了最先进的性能。ILLUME基于统...
    新技术# ILLUME# 华为诺亚方舟实验室# 多模态大语言模型
    2年前
    5160
    多模态大语言模型InternVL 2.5:处理和理解来自多种模态(如文本、图像和视频)的信息

    多模态大语言模型InternVL 2.5:处理和理解来自多种模态(如文本、图像和视频)的信息

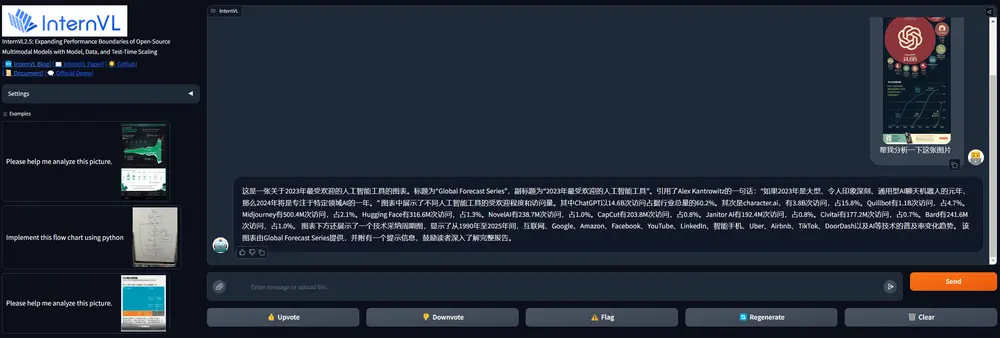
    InternVL 2.5 是由上海人工智能实验室、商汤科技研究院、清华大学、南京大学、复旦大学、香港中文大学和上海交通大学等多家机构联合推出的一款先进的多模态大语言模型(MLLM)。该模型基于此前发布...
    多模态模型# InternVL 2.5# 多模态大语言模型
    2年前
    4630
    微软推出全新多模态大语言模型家族Florence-VL

    微软推出全新多模态大语言模型家族Florence-VL

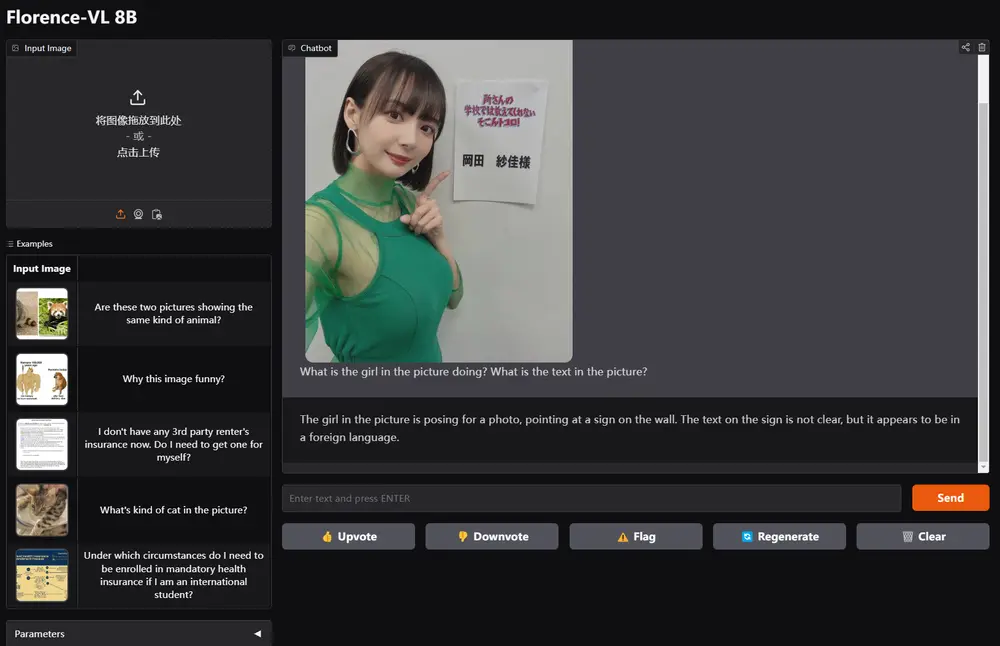
    马里兰大学和微软研究院的研究团队共同提出了Florence-VL,这是一个全新的多模态大语言模型(MLLMs)家族。Florence-VL的视觉表示由生成式视觉基础模型Florence-2生成,与传统...
    多模态模型# Florence-VL# 多模态大语言模型# 微软
    2年前
    4850
    多模态大语言模型ChatRex:提升对人类姿态的感知和理解能力

    多模态大语言模型ChatRex:提升对人类姿态的感知和理解能力

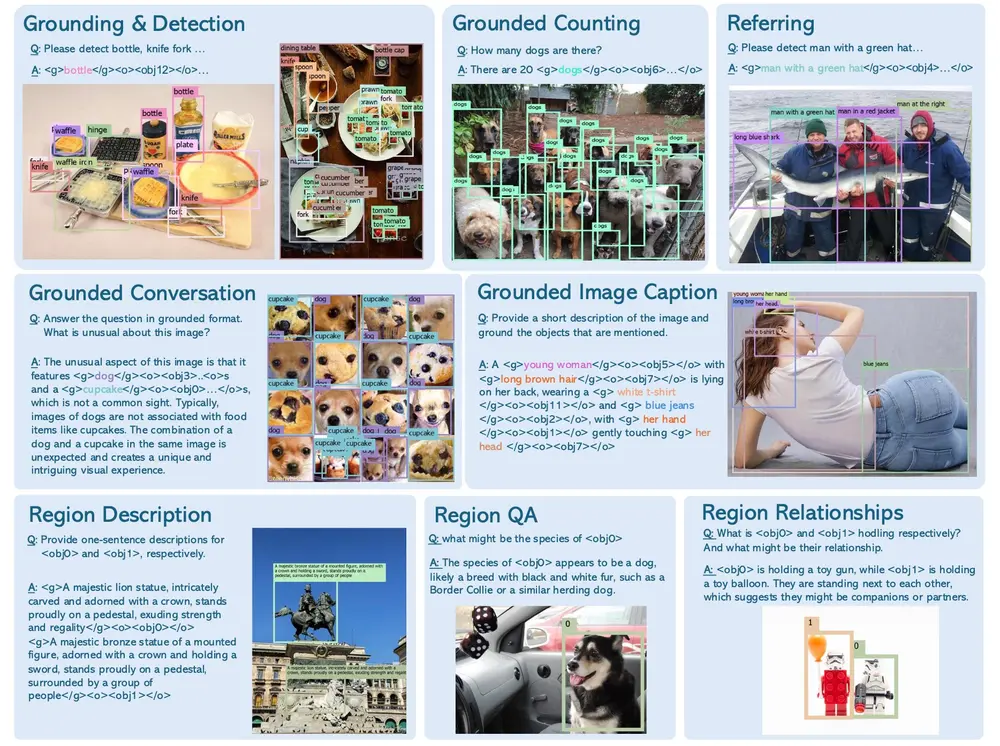
    IDEA的研究人员推出多模态大语言模型ChatRex,它旨在提升对人类姿态的感知和理解能力。ChatRex通过结合视觉和语言模型,能够执行多种与人体姿态相关任务,包括姿态理解、生成和编辑。这个模型特别...
    多模态模型# ChatRex# 多模态大语言模型
    2年前
    4250
    新型多模态大语言模型PUMA:不仅能理解文本指令,还能根据这些指令创作出精细的图像,或者对现有图像进行精确的编辑

    新型多模态大语言模型PUMA:不仅能理解文本指令,还能根据这些指令创作出精细的图像,或者对现有图像进行精确的编辑

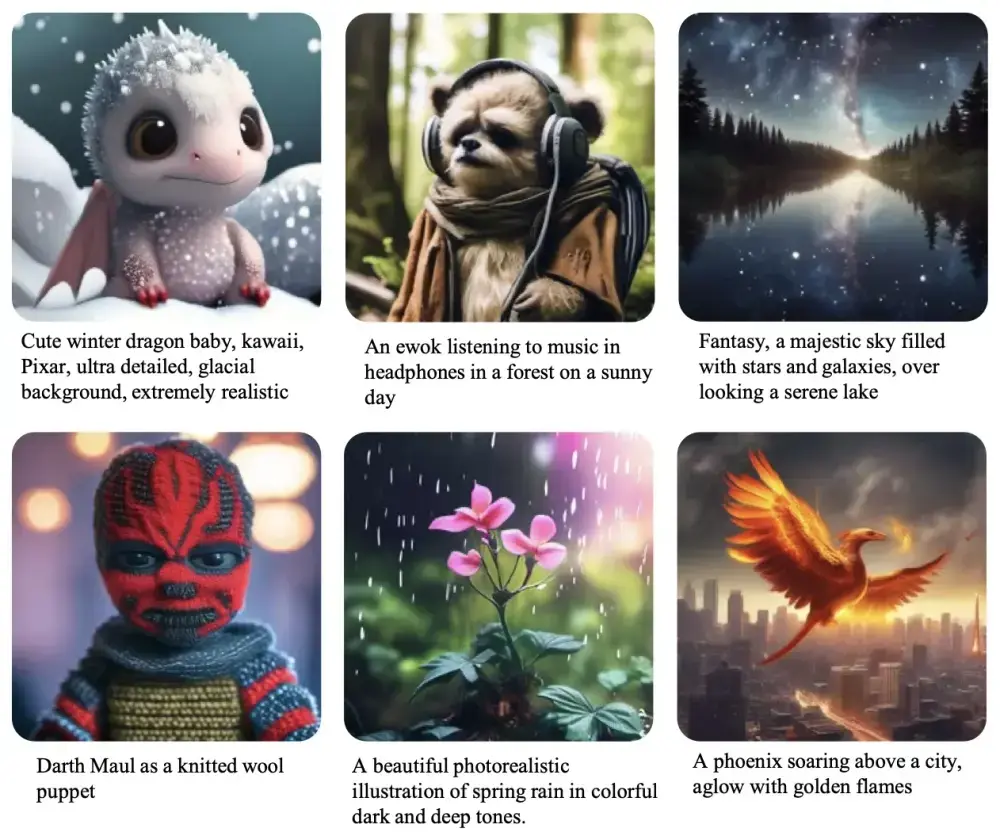
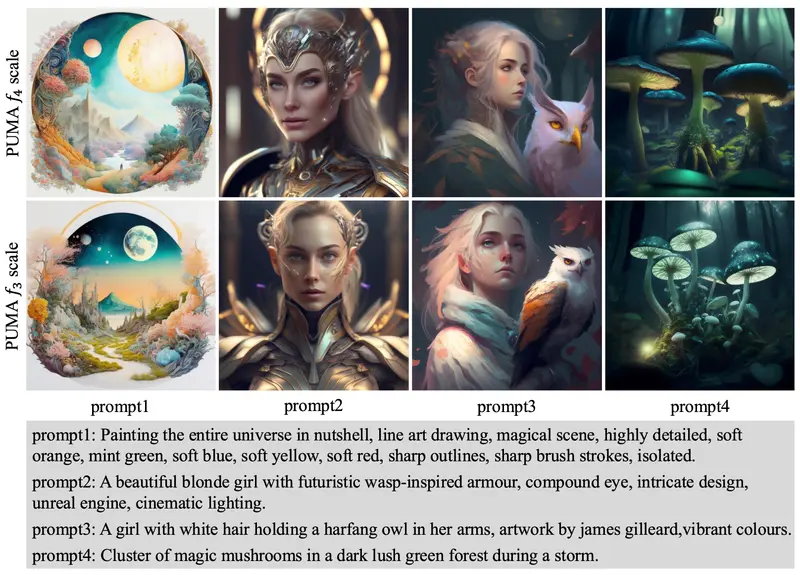
    近年来,多模态基础模型在视觉-语言理解领域取得了显著进展,同时也开始探索多模态大语言模型(MLLMs)在视觉内容生成方面的潜力。然而,现有的工作在统一MLLM范式中处理不同图像生成任务的多样化粒度需求...
    百科# PUMA# 多模态大语言模型
    2年前
    5830
    阿里国际推出多模态大语言模型 Ovis1.6-Gemma2-9B:能够同时处理和理解文本和视觉信息

    阿里国际推出多模态大语言模型 Ovis1.6-Gemma2-9B:能够同时处理和理解文本和视觉信息

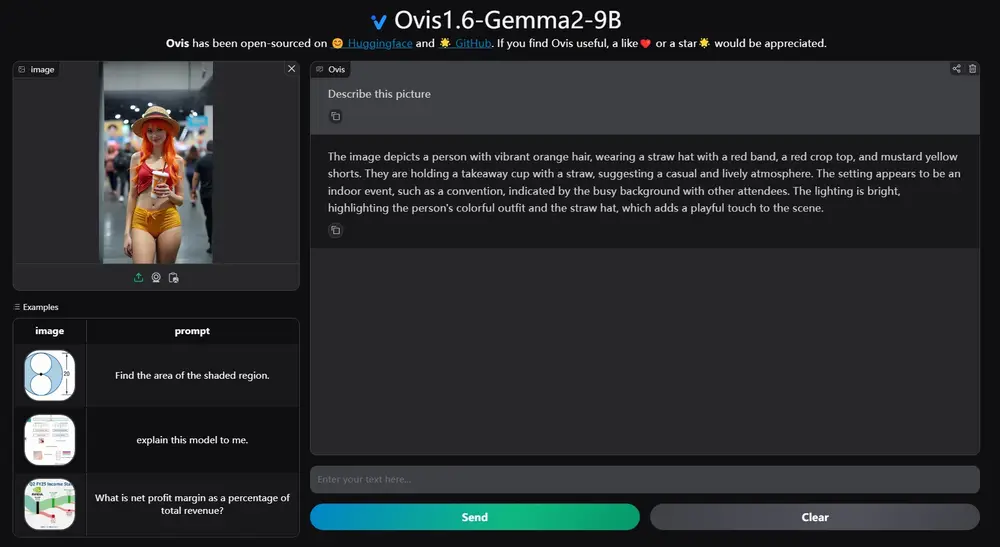
    Ovis1.6-Gemma2-9B是阿里国际推出的一款多模态大语言模型,Ovis是一种新颖的多模态大语言模型(MLLM)架构,旨在结构化地对齐视觉和文本嵌入。Ovis1.6-Gemma2-9B基于O...
    多模态模型# Ovis1.6-Gemma2-9B# 多模态大语言模型
    2年前
    7110
    多模态大语言模型Qwen2-VL-7B-Captioner-Relaxed:经过指令调整的Qwen2-VL-7B-Instruct版本

    多模态大语言模型Qwen2-VL-7B-Captioner-Relaxed:经过指令调整的Qwen2-VL-7B-Instruct版本

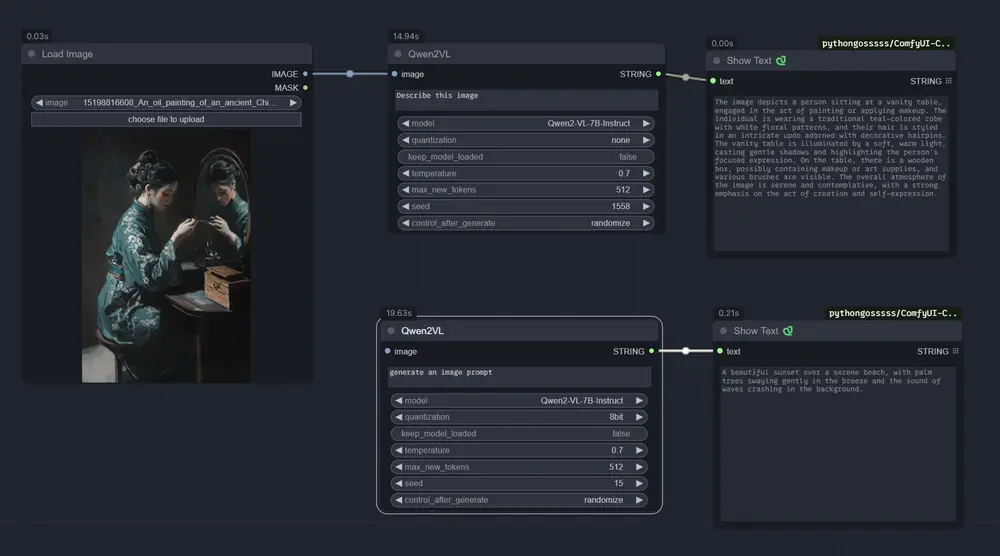
    Qwen2-VL-7B-Captioner-Relaxed 是 Qwen2-VL-7B-Instruct 的一个经过指令调整的版本,它是一个多模态大语言模型。这个经过精细调整的版本是基于一个为文生图模...
    多模态模型# Qwen2-VL-7B-Captioner-Relaxed# 多模态大语言模型
    2年前
    8250
    加载更多

    网址

    日榜周榜月榜
    LoginFlip

    LoginFlip

    LoginFlip 是一款专为 Chrome 浏览器设计的轻量级扩展,解决多账号管理痛点。它通过保存和恢复网站的登录状态(Cookie + localStorage),让你在不同身份(工作号、测试号、个人号等)之间实现秒级切换,彻底告别反复输入密码和退出登录的繁琐流程。
    Saga

    Saga

    Saga 是一个生成式 AI 平台,它引导创作者从想法到视频,协助从剧本写作到分镜头可视化的所有工作。由 Veo 3 和 Imagen 4 驱动,Saga 使电影制作人能够以前所未有的速度从剧本转向屏幕。Veo 3 的集成开启了“previz”和“animatics”的新工作流程,允许作家和导演以更高的保真度可视化、迭代和推销故事想法——在几分钟而非几周内。
    DeepGemini

    DeepGemini

    DeepGemini 作为一个灵活的多模型编排 API,为开发者和企业提供了强大的工具,以应对复杂的 AI 应用场景。通过多模型编排、角色管理和多种讨论模式,DeepGemini 不仅提升了 AI 应用的灵活性和多样性,还为团队协作和创意生成提供了全新的解决方案。
    HAJIMI Gemini API Proxy

    HAJIMI Gemini API Proxy

    HAJIMI Gemini API Proxy 是一个功能强大且易于使用的工具,为开发者提供了一个简单、安全且可配置的方式来访问 Google 的 Gemini 模型。通过 API 密钥管理、模型列表接口、聊天补全接口、密码保护、速率限制和与 OpenAI API 格式的兼容性,该工具极大地简化了 Gemini 模型的部署和使用流程。
    Medeo

    Medeo

    Medeo 允许用户通过简单的文本描述生成视频,无需复杂的编辑界面。它提供超过数百万的高清视频素材,AI 自动匹配场景素材,并优化脚本、添加配音和背景音乐,完美处理过渡和节奏。此外,它能将网页或文章转为专业视频,支持创建动画故事,并提供个人和社区资产库,方便 A/B 测试和多语言配音。
    LemonAI

    LemonAI

    Lemon 是一款开源的通用智能体(AI Agent),能够从需求计划到成果交付全流程自动化,它通过独立思考和系统规划,在虚拟环境中灵活调用各类工具,如编写并执行代码、智能浏览网页、操作网页应用、命令执行等。Lemon 擅长将复杂任务系统化分解并有序执行,自动分析任务、安排步骤优先级、动态调整计划,并实时跟踪进度。旨在助力用户高效完成各类任务。
    查看完整榜单
    SD百科导航
    SD百科导航是专注于AI创作领域的专业导航网站。我们全面涵盖Stable Diffusion、Flux、AI绘画、AI视频、AI音乐以及大语言模型等前沿内容。

    关于我们友链申请广告合作

    扫码关注微信公众号SD百科导航
    扫码关注微信公众号
    Copyright © 2026 SD百科导航 皖ICP备18025588号-5  皖公网安备34040002000401 
    网址
    网址文章软件模型
      ↵ENTER↓↑NAV

      网址

      日榜周榜月榜
      LoginFlip

      LoginFlip

      LoginFlip 是一款专为 Chrome 浏览器设计的轻量级扩展,解决多账号管理痛点。它通过保存和恢复网站的登录状态(Cookie + localStorage),让你在不同身份(工作号、测试号、个人号等)之间实现秒级切换,彻底告别反复输入密码和退出登录的繁琐流程。
      Saga

      Saga

      Saga 是一个生成式 AI 平台,它引导创作者从想法到视频,协助从剧本写作到分镜头可视化的所有工作。由 Veo 3 和 Imagen 4 驱动,Saga 使电影制作人能够以前所未有的速度从剧本转向屏幕。Veo 3 的集成开启了“previz”和“animatics”的新工作流程,允许作家和导演以更高的保真度可视化、迭代和推销故事想法——在几分钟而非几周内。
      DeepGemini

      DeepGemini

      DeepGemini 作为一个灵活的多模型编排 API,为开发者和企业提供了强大的工具,以应对复杂的 AI 应用场景。通过多模型编排、角色管理和多种讨论模式,DeepGemini 不仅提升了 AI 应用的灵活性和多样性,还为团队协作和创意生成提供了全新的解决方案。
      HAJIMI Gemini API Proxy

      HAJIMI Gemini API Proxy

      HAJIMI Gemini API Proxy 是一个功能强大且易于使用的工具,为开发者提供了一个简单、安全且可配置的方式来访问 Google 的 Gemini 模型。通过 API 密钥管理、模型列表接口、聊天补全接口、密码保护、速率限制和与 OpenAI API 格式的兼容性,该工具极大地简化了 Gemini 模型的部署和使用流程。
      Medeo

      Medeo

      Medeo 允许用户通过简单的文本描述生成视频,无需复杂的编辑界面。它提供超过数百万的高清视频素材,AI 自动匹配场景素材,并优化脚本、添加配音和背景音乐,完美处理过渡和节奏。此外,它能将网页或文章转为专业视频,支持创建动画故事,并提供个人和社区资产库,方便 A/B 测试和多语言配音。
      LemonAI

      LemonAI

      Lemon 是一款开源的通用智能体(AI Agent),能够从需求计划到成果交付全流程自动化,它通过独立思考和系统规划,在虚拟环境中灵活调用各类工具,如编写并执行代码、智能浏览网页、操作网页应用、命令执行等。Lemon 擅长将复杂任务系统化分解并有序执行,自动分析任务、安排步骤优先级、动态调整计划,并实时跟踪进度。旨在助力用户高效完成各类任务。
      查看完整榜单