SD百科导航
  • 首页
  • 快讯
  • 早报
  • 模型
  • ComfyUI
  • 新技术
  • 百科
    • 教程
    • 硬件
    • 科普
  • 百科工具
    • 工具
  • 排行榜
    • 首页
    • 快讯
    • 早报
    • 模型
    • ComfyUI
    • 新技术
    • 百科
      • 教程
      • 硬件
      • 科普
    • 百科工具
      • 工具
    • 排行榜

    图像模型

    共 289 篇文章
    用于文生图、图生图、图像编辑的模型
    百科工具模型ComfyUIAI合集web UI提示词
    大语言模型多模态模型图像模型语音模型3D模型Flux衍生视频模型世界模型决策模型
    排序
    发布更新浏览点赞
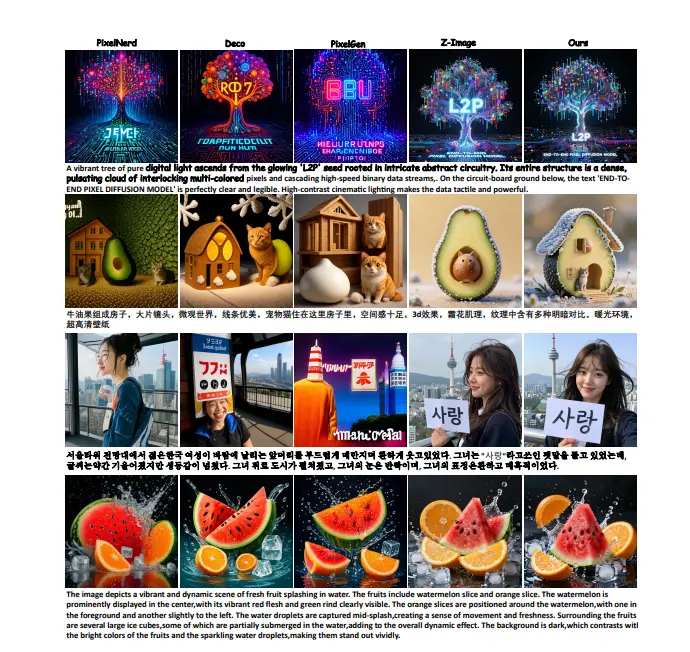
    腾讯优图提出 L2P:8 卡即可训练,零真实数据实现原生 4K 像素级扩散生成

    腾讯优图提出 L2P:8 卡即可训练,零真实数据实现原生 4K 像素级扩散生成

    由南京大学、腾讯优图等机构联合提出的 L2P (Latent-to-Pixel) 技术,为高分辨率图像生成提供了一条全新的低成本路径。作为一种高效的迁移范式,L2P 能够将预训练隐空间扩散模型(LDM...
    图像模型# L2P# L2P-z-image# 腾讯优图
    5个月前
    3220
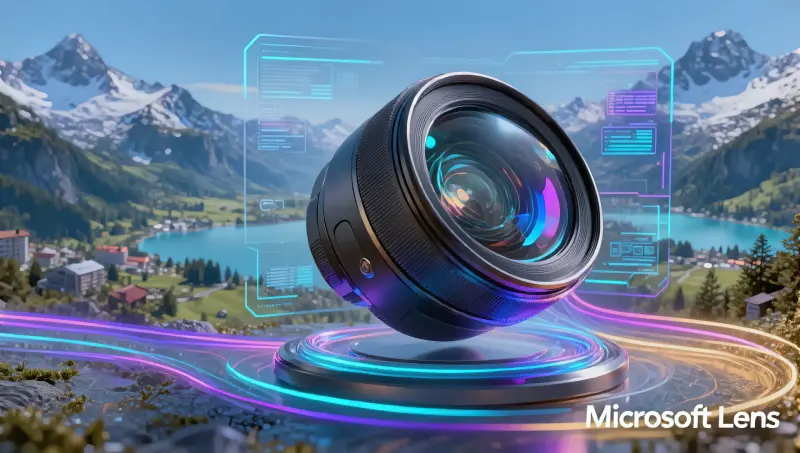
    微软发布 Lens:3.8B 参数文生图模型,以 1/5 算力媲美 SOTA,支持 4 步极速推理

    微软发布 Lens:3.8B 参数文生图模型,以 1/5 算力媲美 SOTA,支持 4 步极速推理

    微软正式推出 Lens,一款仅拥有 38 亿(3.8B)参数的基础文本到图像(T2I)生成模型。在主流大模型参数量动辄达到 6B 甚至 80B 的今天,Lens 证明了“小而美”的可能性:它通过极致的...
    图像模型# Lens# 微软# 文生图模型
    5个月前
    3460
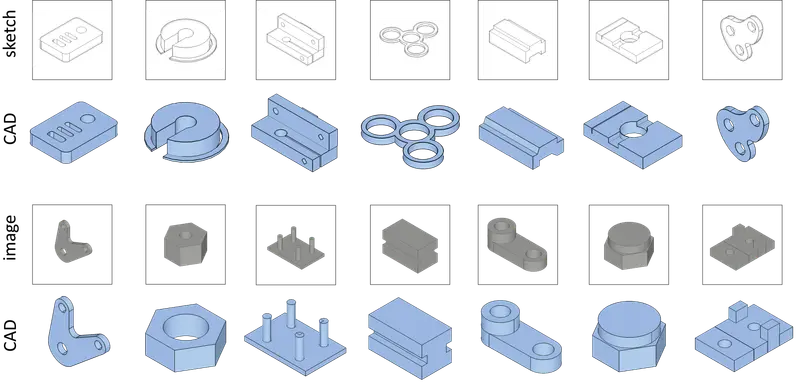
    MIT 发布 GenCAD:首个图像条件参数化 CAD 生成模型,输出可编辑命令序列而非静态网格

    MIT 发布 GenCAD:首个图像条件参数化 CAD 生成模型,输出可编辑命令序列而非静态网格

    麻省理工学院(MIT)研究团队提出了 GenCAD,这是首个基于图像条件的参数化计算机辅助设计(CAD)生成模型。与传统 AI 生成静态 3D 网格或点云不同,GenCAD 能够直接从输入图像或草图中...
    图像模型# CAD# GenCAD# MIT
    5个月前
    2810
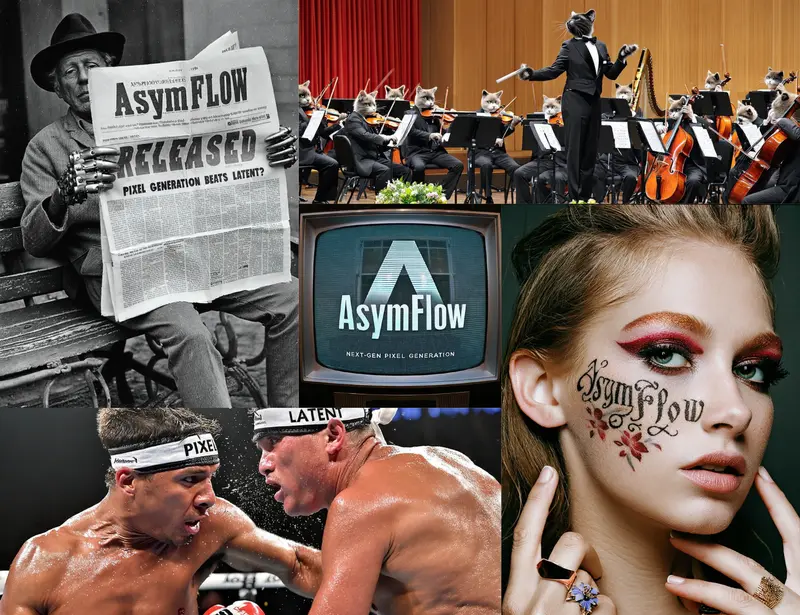
    斯坦福提出 AsymFlow:首个将预训练潜在模型微调至像素空间的流生成框架,ImageNet FID 1.57 刷新纪录,AsymFLUX.2 超越 FLUX.2 基础版

    斯坦福提出 AsymFlow:首个将预训练潜在模型微调至像素空间的流生成框架,ImageNet FID 1.57 刷新纪录,AsymFLUX.2 超越 FLUX.2 基础版

    在高维像素空间中进行基于流(Flow-based)的生成一直面临巨大挑战:即使数据具有低秩结构,速度场预测仍需处理高维噪声,导致训练困难且效率低下。近日,斯坦福大学研究团队提出了 Asymmetric...
    图像模型# AsymFlow# AsymFLUX.2 klein
    6个月前
    2480
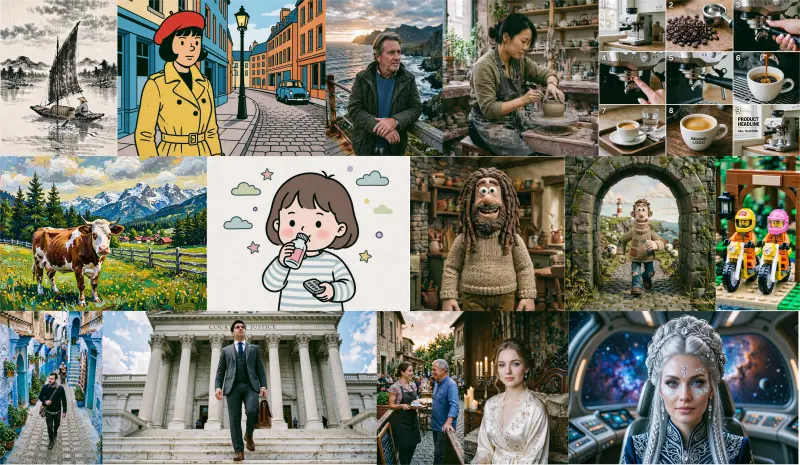
    Krea 正式发布Krea 2:从零构建的首个基础模型,支持 4 重风格参考与概念级情绪板

    Krea 正式发布Krea 2:从零构建的首个基础模型,支持 4 重风格参考与概念级情绪板

    在 AI 绘画领域,如何平衡“创造力”与“控制力”一直是最大的挑战。今天,Krea 正式推出其首个完全从零构建的基础模型——Krea 2。 地址:https://www.krea.ai/krea-2 ...
    图像模型早报# Krea# Krea 2
    6个月前
    4530
    智象未来发布HiDream-O1-Image:8B 参数原生统一生图模型,无需 VAE 与独立文本编码器

    智象未来发布HiDream-O1-Image:8B 参数原生统一生图模型,无需 VAE 与独立文本编码器

    在文生图领域,传统模型往往依赖复杂的流水线:独立的文本编码器(如 CLIP/T5)、潜空间压缩器(VAE)以及扩散主干网络。北京智象未来发布了 HiDream-O1-Image,一款革命性的原生统一图...
    图像模型# HiDream-O1-Image# 智象未来
    6个月前
    4300
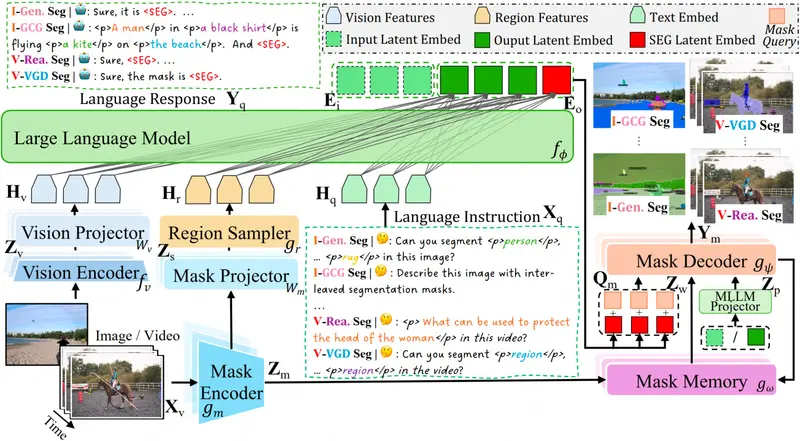
    X2SAM:中山大学发布统一图像-视频分割 MLLM,一句话精准圈出任意物体,支持对话式交互与稳定追踪

    X2SAM:中山大学发布统一图像-视频分割 MLLM,一句话精准圈出任意物体,支持对话式交互与稳定追踪

    在多模态大语言模型(MLLM)飞速发展的今天,AI 已经能流畅地“看图说话”,但在像素级精准感知——即准确圈出画面中的特定物体——方面仍显笨拙。与此同时,像 SAM(Segment Anything ...
    图像模型# X2SAM# 图像-视频分割模型
    6个月前
    2990
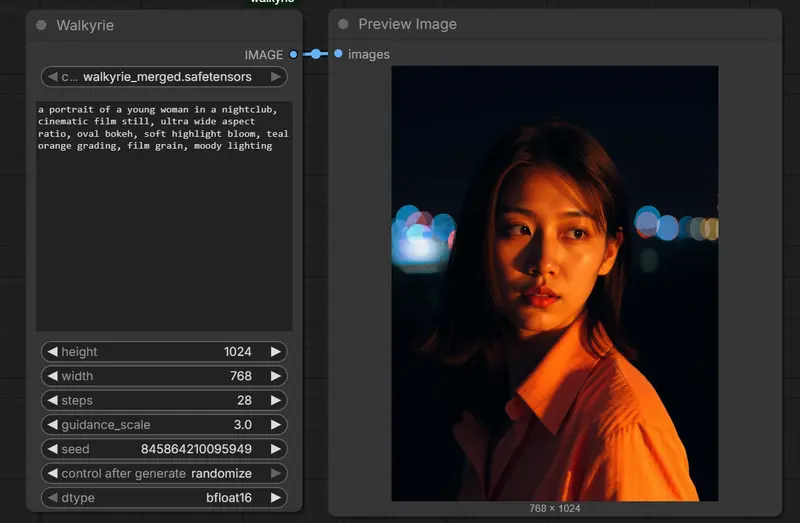
    Walkyrie 1.3B:基于 Wan2.1 架构的轻量级文本生图模型,6GB 显存即可运行的高质量 T2I 新选择

    Walkyrie 1.3B:基于 Wan2.1 架构的轻量级文本生图模型,6GB 显存即可运行的高质量 T2I 新选择

    在大型扩散模型日益臃肿的今天,如何在有限硬件上获得高质量生成效果成为一大挑战。Walkyrie 1.3B 是一个从强大的 Wan2.1-T2V-1.3B(文生视频)模型衍生而来的**文生图(T2I...
    图像模型插件# Walkyrie 1.3B# Wan2.1
    6个月前
    3480
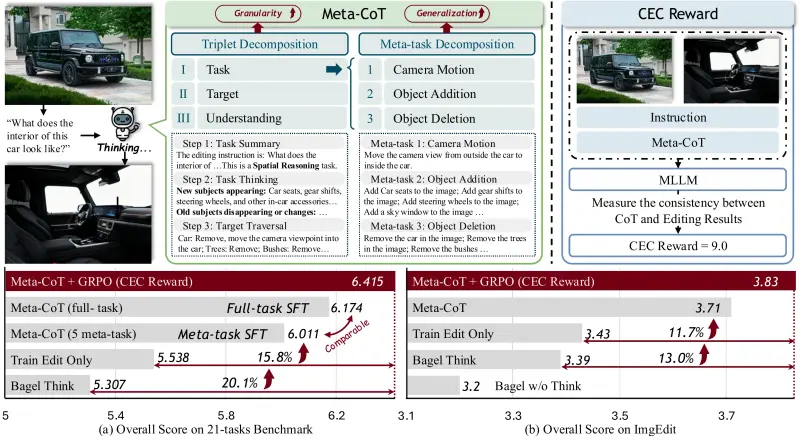
    清华 x 腾讯混元发布 Meta-CoT:让 AI 修图“先思考后动手”,复杂指令理解力提升 15.8%

    清华 x 腾讯混元发布 Meta-CoT:让 AI 修图“先思考后动手”,复杂指令理解力提升 15.8%

    在 AI 图像编辑领域,我们常遇到这样的尴尬:AI 虽然能听懂简单的“添加”或“删除”指令,但面对复杂描述(如“把相机视角移到车内”、“让人物变老同时保持背景不变”)时,往往出现“想的和做的不一样...
    图像模型# Meta-CoT
    6个月前
    2070
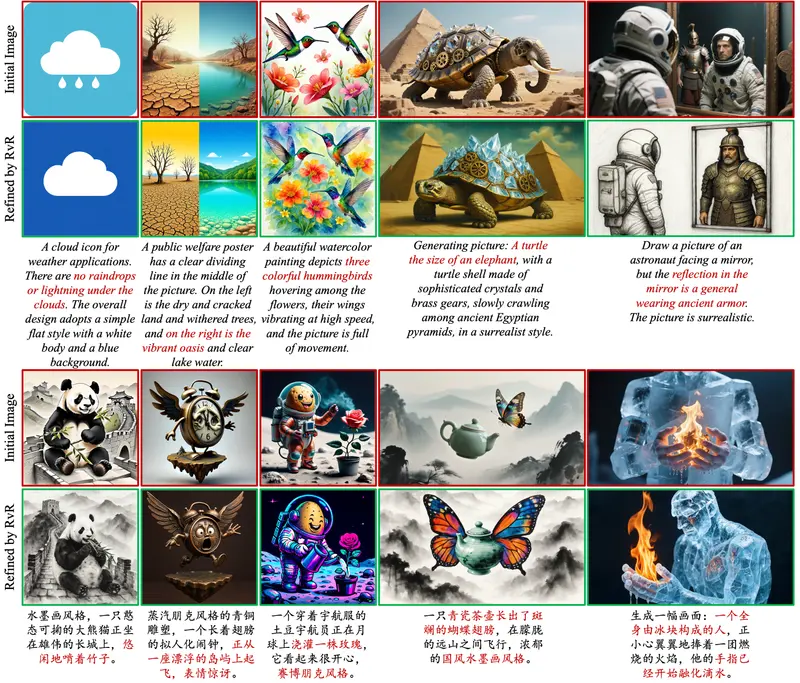
    清华 x 腾讯混元发布 RvR:用“重生成”取代“局部修图”,解决 AI 绘图不听话难题

    清华 x 腾讯混元发布 RvR:用“重生成”取代“局部修图”,解决 AI 绘图不听话难题

    在文字生成图片(Text-to-Image)领域,我们常遇到这样的尴尬:AI 生成的画面大体不错,但细节却“不听话”——物体数量不对、位置错乱、风格偏差,甚至完全忽略否定词(如“没有猫”)。传统的优化...
    图像模型# RvR# 修图
    6个月前
    2020
    Tuna-2:Meta AI 提出无编码器统一多模态模型,像素级端到端训练超越传统架构

    Tuna-2:Meta AI 提出无编码器统一多模态模型,像素级端到端训练超越传统架构

    在当前的统一多模态模型(Unified Multimodal Models)中,预训练的视觉编码器(如 VAE 或 CLIP)几乎是标配。这种模块化设计虽然成熟,却带来了一个根本性问题:理解任务与生成...
    图像模型# Meta AI# Tuna-2# 多模态模型
    6个月前
    2200
    Meta 推出的超高分辨率人体视觉基础模型Sapiens2

    Meta 推出的超高分辨率人体视觉基础模型Sapiens2

    Sapiens2 是 Meta AI 最新推出的一系列以人为中心的计算机视觉模型。它在 10 亿张高质量人类图像上进行了预训练,旨在解决传统人体视觉模型在细节还原与语义理解之间难以兼顾的痛点。Sapi...
    图像模型# Meta# Sapiens2
    6个月前
    2670
    加载更多

    网址

    日榜周榜月榜
    LoginFlip

    LoginFlip

    LoginFlip 是一款专为 Chrome 浏览器设计的轻量级扩展,解决多账号管理痛点。它通过保存和恢复网站的登录状态(Cookie + localStorage),让你在不同身份(工作号、测试号、个人号等)之间实现秒级切换,彻底告别反复输入密码和退出登录的繁琐流程。
    天府智能体 (Tianfu Agent) 

    天府智能体 (Tianfu Agent) 

    天府智能体 (Tianfu Agent) 作为全球首个专为深度命理推理设计的智能体,它并非简单的聊天机器人,而是一个融合了紫微斗数、子平八字、奇门遁甲三大传统术数体系的复杂 AI 系统。
    TapNow

    TapNow

    TapNow是一个面向创作者的专业级 AI 视觉内容平台,支持从脚本撰写、分镜头设计到高保真成片输出的完整流程,单人即可在 1–3 天内完成传统需 4–6 周的影视级项目。
    Open ASR 排行榜

    Open ASR 排行榜

    Open ASR 排行榜 对 Hugging Face Hub 上的语音识别模型进行排名和评估。我们报告平均 WER(字错误率)(⬇️ 越低越好)和 RTFx(实时因子)(⬆️ 越高越好),模型根据其平均 WER 从低到高进行排名。
    ITELLOU

    ITELLOU

    ITELLYOU(也称为NEXT, ITELLYOU)是一个专注于提供微软原版软件资源的非官方网站,主要帮助用户获取未经修改的微软产品镜像,如Windows操作系统、Office办公软件和开发工具等。
    PPT Master

    PPT Master

    PPT Master 是一个创新的 AI 辅助视觉内容创作系统,通过多角色协作(策略师、图片生成师、执行师、优化师),实现从内容策划到视觉优化的完整工作流。系统不仅支持生成符合顶尖咨询公司(如麦肯锡、波士顿咨询)标准的商业演示文稿,还支持小红书帖子、朋友圈海报、Instagram 等多种社交媒体和营销物料格式。
    查看完整榜单
    SD百科导航
    SD百科导航是专注于AI创作领域的专业导航网站。我们全面涵盖Stable Diffusion、Flux、AI绘画、AI视频、AI音乐以及大语言模型等前沿内容。

    关于我们友链申请广告合作

    扫码关注微信公众号SD百科导航
    扫码关注微信公众号
    Copyright © 2026 SD百科导航 皖ICP备18025588号-5  皖公网安备34040002000401 
    网址
    网址文章软件模型
      ↵ENTER↓↑NAV

      网址

      日榜周榜月榜
      LoginFlip

      LoginFlip

      LoginFlip 是一款专为 Chrome 浏览器设计的轻量级扩展,解决多账号管理痛点。它通过保存和恢复网站的登录状态(Cookie + localStorage),让你在不同身份(工作号、测试号、个人号等)之间实现秒级切换,彻底告别反复输入密码和退出登录的繁琐流程。
      天府智能体 (Tianfu Agent) 

      天府智能体 (Tianfu Agent) 

      天府智能体 (Tianfu Agent) 作为全球首个专为深度命理推理设计的智能体,它并非简单的聊天机器人,而是一个融合了紫微斗数、子平八字、奇门遁甲三大传统术数体系的复杂 AI 系统。
      TapNow

      TapNow

      TapNow是一个面向创作者的专业级 AI 视觉内容平台,支持从脚本撰写、分镜头设计到高保真成片输出的完整流程,单人即可在 1–3 天内完成传统需 4–6 周的影视级项目。
      Open ASR 排行榜

      Open ASR 排行榜

      Open ASR 排行榜 对 Hugging Face Hub 上的语音识别模型进行排名和评估。我们报告平均 WER(字错误率)(⬇️ 越低越好)和 RTFx(实时因子)(⬆️ 越高越好),模型根据其平均 WER 从低到高进行排名。
      ITELLOU

      ITELLOU

      ITELLYOU(也称为NEXT, ITELLYOU)是一个专注于提供微软原版软件资源的非官方网站,主要帮助用户获取未经修改的微软产品镜像,如Windows操作系统、Office办公软件和开发工具等。
      PPT Master

      PPT Master

      PPT Master 是一个创新的 AI 辅助视觉内容创作系统,通过多角色协作(策略师、图片生成师、执行师、优化师),实现从内容策划到视觉优化的完整工作流。系统不仅支持生成符合顶尖咨询公司(如麦肯锡、波士顿咨询)标准的商业演示文稿,还支持小红书帖子、朋友圈海报、Instagram 等多种社交媒体和营销物料格式。
      查看完整榜单