在计算机视觉领域,单目深度估计(Monocular Depth Estimation) 一直是个既基础又棘手的难题。它的目标很简单:只凭一张普通的二维彩色照片,推算出画面中每个像素点距离镜头的远近,生成一张“深度图”。
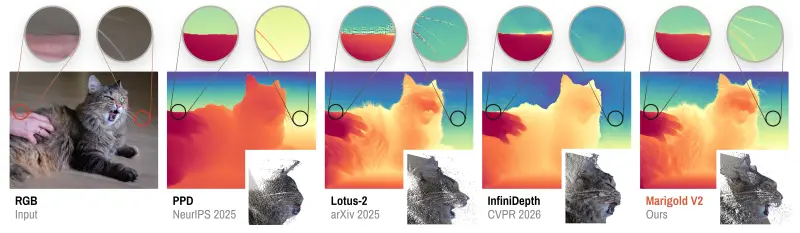
这张深度图是三维重建、背景虚化、AR 增强现实以及机器人视觉的“基石”。然而,过去的 AI 模型往往有两个致命弱点:
- 细节糊化:遇到毛发、树叶、细小栏杆等复杂边缘时,容易把边界算成一团模糊的噪点。
- 门槛极高:效果好的模型通常需要几十张高端显卡训练数周,普通实验室难以复现。
近日,华为拜耳实验室(Huawei Bayer Lab) 推出了 Marigold V2。它基于现成的图像编辑大模型改造而来,不仅解决了“边缘糊化”的老大难问题,更将训练成本大幅降低——只需单台 32G 显存的消费级显卡,几天即可完成训练。
- GitHub:https://github.com/huawei-bayerlab/marigold-v2
- 模型:https://huggingface.co/huawei-bayerlab/marigold-v2-0
- 魔搭:https://www.modelscope.cn/models/huawei-bayerlab/marigold-v2-0
- ComfyUI:https://huggingface.co/Comfy-Org/marigold-v2-0
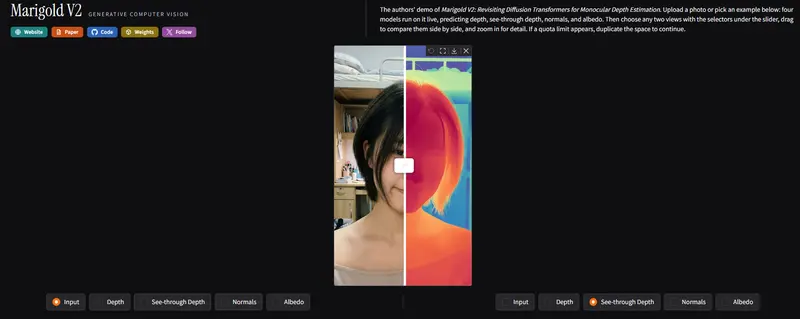
- Demo:https://huggingface.co/spaces/toshas/Marigold-V2
核心突破:从“看个大略”到“看清发丝”
如果把普通深度 AI 比作一个只能分清“墙壁”和“桌子”远近的观察者,那么 Marigold V2 就像是一个能看清“猫的每一缕毛发”和“灌木丛每一片枝叶”前后关系的精细工匠。
1. 独创 SinkLoss:容忍噪点,锐利边缘
传统模型强制要求预测的每个像素与标准答案严格对应,这导致模型容易“学进”数据集中的噪声,把边缘算糊。
Marigold V2 引入了 SinkLoss 策略:它不要求点对点死磕,而是将图片切分成小块,只要小块内的深度值分布集合与真实情况一致即可。这种“局部匹配”机制让模型学会了忽略数据集本身的随机噪点,从而大幅减少错误像素,让物体轮廓如刀切般锐利。
2. iREPA-depth 语义对齐:专注几何,无视色彩干扰
大多数模型用彩色原图做特征引导,容易被颜色误导。Marigold V2 改用标准答案深度图提取的几何特征来约束模型。这意味着 AI 不再被“红色的苹果”或“绿色的叶子”迷惑,而是专注于学习“凸起”和“凹陷”的结构本身,收敛更快,结构理解更准。
3. 极低门槛:复用 DiT 主干,QLoRA 微调
Marigold V2 没有从零搭建庞大网络,而是复用了成熟的 Qwen-Image-Edit 图像编辑模型主体。通过冻结大部分权重,仅使用轻量化的 QLoRA 适配器进行微调,使得单块 32G 显卡在几天内就能完成高质量训练。这让小团队和普通科研组也能轻松复现顶尖成果。
功能全景:不止于深度
Marigold V2 的设计具有极强的通用性,同一套两阶段训练流程稍作调整,即可适配多种稠密视觉回归任务:
- 高精度单目深度估计:支持高分辨率图像推理,单卡不爆显存。
- 稀疏点补全深度:从少量深度点恢复完整场景。
- 玻璃透视深度:尝试解决透明物体的深度判断难题。
- 表面法线估计:推断物体表面的朝向,用于重新打光。
- 固有色分解:分离光照与物体本身的颜色。
性能表现:零样本泛化能力强
在多套公开数据集(包括极具挑战性的 ETH3D)上的测试显示:
- 综合误差更低:在室内、室外及野外实拍场景中,整体指标优于大量主流开源模型。
- 细节保留更好:在衡量边缘和细小结构的指标上显著提升,树叶、栏杆等细节清晰可见。
- 高分辨率鲁棒性:相比同类模型在大尺寸图片下容易显存溢出,Marigold V2 在单张 32G 显卡上仍能稳定运行大图推理。
注意局限:目前模型输出的是相对远近(非绝对米数);对于强反光、严重虚焦或运动模糊的照片,判断仍存在困难;推理速度尚未达到实时级别。
应用场景:从手机摄影到机器人感知
- 计算摄影后期:
- 极致虚化:利用精细的深度图,对人像发丝、宠物毛发进行更自然的背景虚化,告别“抠图边缘锯齿”。
- 照片重打光:结合深度与法线信息,在后期软件中改变照片的光源方向,创造全新氛围。
- AR/VR 与三维重建:
- 单图转 3D:将一张生活照快速转化为可浏览的简易 3D 场景,用于 VR 回忆或虚拟布景。
- 游戏资产生成:美术概念图一键生成深度图,导入引擎直接实现虚拟相机运镜。
- 机器人与自动驾驶:
- 作为感知系统的补充,帮助机器人识别障碍物的相对距离,尤其在缺乏激光雷达的低成本方案中价值巨大。
- 科研与教育:
- 完整的训练方案和代码公开,为计算机视觉研究提供了新的基线。iREPA-depth 和 SinkLoss 思路可被借鉴用于其他密集预测任务。
© 版权声明
文章版权归作者所有,未经允许请勿转载。