商汤科技今日正式开源了多模态模型 SenseNova U1.5-Lite-Preview 的预览版本。作为基于 NEO-Unify 架构的系统性迭代,该模型仅以 8B-MoT(混合专家Transformer)的轻量级规模,实现了原生 4K 分辨率图像生成、精细质感还原以及可持续的迭代编辑能力。
- GitHub:https://github.com/OpenSenseNova/SenseNova-U1/blob/main/docs/u1.5_preview.md
- Hugging Face:https://huggingface.co/sensenova/SenseNova-U1.5-8B-MoT-Preview
- 魔搭社区:https://modelscope.cn/models/SenseNova/SenseNova-U1.5-8B-MoT-Preview
如果说此前的 SenseNova U1 验证了“语言、视觉语义与像素生成统一建模”的可行性,那么 U1.5 则进一步证明了这一架构在高分辨率、复杂指令遵循和真实世界质感上的扩展潜力。
核心突破:从“可行”到“好用”
1. 原生 4K 生成:细节经得起放大
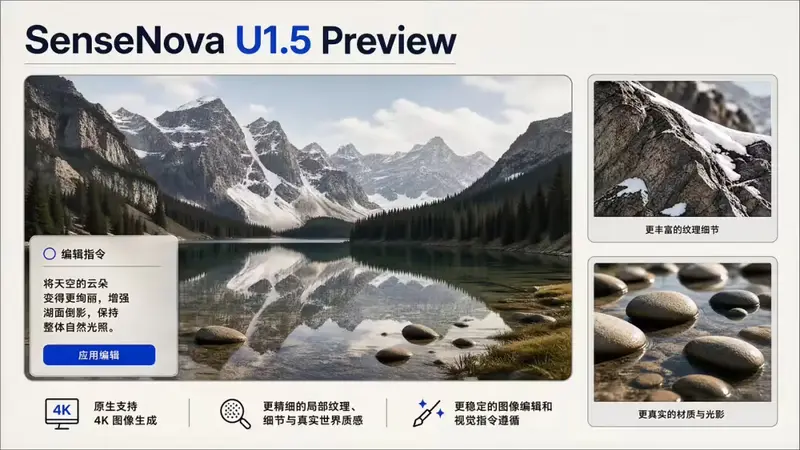
U1.5-Lite-Preview 不再依赖分块拼接或后期超分,而是直接在训练阶段扩展至 4K 分辨率。
- 真实质感:在自然风光、商业摄影及产品海报中,能够呈现细腻的材质纹理与光影层次。
- 超大画幅一致性:例如在生成的 WAIC 发展历程长卷中,即便横跨多年叙事且包含大量文字图标,放大后依然清晰稳定,无网格伪影或拼接痕迹。
2. 极致的视觉控制:写得越细,出图越准
模型重点优化了对长篇自然语言和结构化指令的理解能力。
- 复杂约束执行:能够处理包含主体互动、位置布局、视觉风格及特定文字内容的多维需求。
- Prompt Enhance Skill:配套提供了实验性技能,可将用户简短的想法自动整理为包含布局、风格、文字等完整约束的创作方案,降低编写复杂提示词的门槛。
- 基准提升:在 Qwen-Image-Bench 上,得分从 U1 的 47.14 提升至 55.20(配合 Prompt Enhance)。
3. 文字与版式升级:信息密集场景更稳定
强化了中英文文字生成及复杂版式组织能力。无论是杂志内页、旅行攻略还是复杂信息图,都能在保持视觉风格的同时,确保文字准确、版式清晰,解决了以往模型在处理高密度信息时容易出现的乱码或排版混乱问题。
4. 编辑能力进化:从“抽卡”到“迭代修改”
依托 encoder-free 视觉建模方式,U1.5-Lite-Preview 减少了固定编码器带来的信息压缩瓶颈,使编辑更加精准可控:
- 局部精准修改:支持针对标题、数字、图标等元素进行定向增删、位置调整或美化,且不影响非编辑区域。
- 文字自然融入:修改真实场景中的文字时,能自动保持原有字体、材质、透视及遮挡关系。
- 交互式编辑:支持通过画框、坐标或 marker 标记指定修改范围,实现“哪里不对改哪里”的精细化操作。
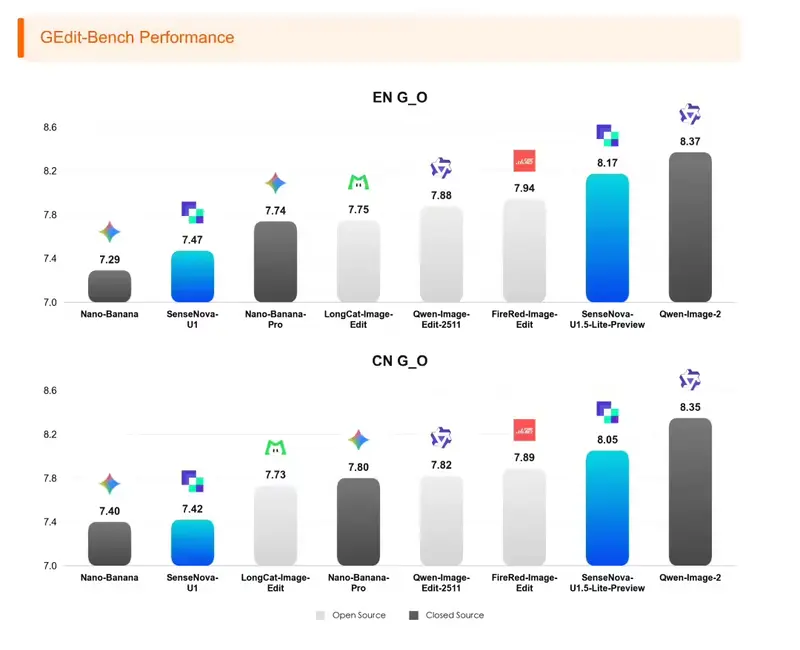
- 基准提升:在 ImgEdit-Bench 上得分从 3.90 提升至 4.37;在 GEdit-Bench-zh 上从 7.42 提升至 8.05。
技术架构:NEO-Unify 的深度优化
U1.5-Lite-Preview 并非简单的参数堆叠,而是针对真实创作痛点的系统性重构:
- 生成头重设计:减弱视觉 Token 网格对最终图像的影响,解决高分辨率下的纹理断裂问题。
- 编辑数据重组:强化模型对原图内容、主体身份及空间结构的保持能力,避免编辑过程中的“漂移”现象。
- 统一智能体视角:模型不再是连接不同模态的系统,而是一个能跨越语言、视觉与行动进行学习和创造的统一智能体。
© 版权声明
文章版权归作者所有,未经允许请勿转载。