蚂蚁集团旗下 inclusionAI 团队正式推出 LLaDA‑Image,一款6B参数开源统一图像生成与编辑模型家族。整套模型分为两个版本:50步采样的基础版 LLaDA‑Image,主打高质量文生图与指令引导编辑;经过 Twin‑DMD 蒸馏的极速版 LLaDA‑Image‑Turbo,仅需2‑4步采样即可完成快速生成与编辑。两款模型原生支持文生图、VQ条件生成、参考图像编辑以及中英文画面文字渲染。
- GitHub:https://github.com/inclusionAI/LLaDA-Image
模型版本一览
| 模型 | 描述 | 采样步骤 | Hugging Face(检查点) | ModelScope(检查点) |
|---|---|---|---|---|
| LLaDA‑Image | 用于高保真文本到图像生成和指令引导编辑的基础模型 | 50 | BF16: inclusionAI/LLaDA-Image | BF16: inclusionAI/LLaDA-Image |
| LLaDA‑Image‑Turbo | 用于快速生成和编辑的蒸馏模型 | 4 | BF16: inclusionAI/LLaDA-Image-Turbo | BF16: inclusionAI/LLaDA-Image-Turbo |
项目核心亮点
✅ 生成与编辑一体化:单份权重同时承担文生图、参考图指令编辑任务,无需部署独立编辑网络;主干网络与DiT模块采用统一扩散架构,在同一训练框架下迭代优化。
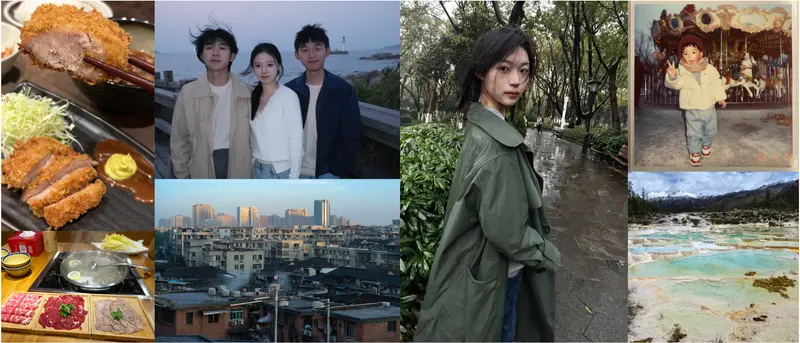
✅ 高写实生成效果:能够产出细节丰富、光照自然、构图连贯的高质量图像。
✅ 创新训练路径:先视觉,后语言:训练前期使用纯图像数据预训练,建立视觉先验,之后再引入图文配对数据,降低对高价图文标注数据集的依赖。训练时冻结主干网络,仅训练轻量化适配器,控制训练成本,保护原有模型能力。
✅ 蒸馏提速方案:依托 Twin‑DMD 蒸馏技术推出 Turbo 快速版本,大幅缩短出图耗时,平衡生成速度与画面质量。
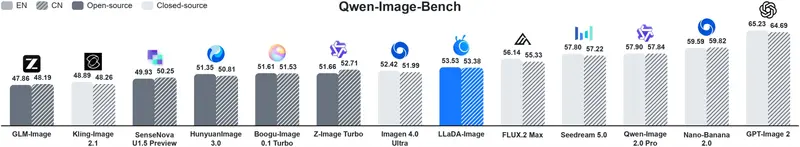
✅ 榜单成绩亮眼:在 Qwen‑Image‑Bench 评测当中,英文赛道得分53.53,中文赛道得分53.38,拿下开源模型SOTA。
✅ 完整训练配方开源可复现:除模型权重以外,数据筛选规则、分阶段训练安排、超参数、后处理方案全部对外开放,可供其他开发者二次迭代。
项目背景
现如今 AI 画图工具已经走进大众视野。市面上效果顶尖的图像生成系统大多属于闭源商业产品,开发者只能调用接口,无法查看完整训练细节、训练数据配比和模型搭建思路。反观现有的开源图像模型,普遍存在两大短板:一部分模型高度依赖成本高昂的图文配对数据集;另一部分模型生成画面的真实感不足,经常出现人物五官扭曲、物体纹理失真、画面文字乱码错字等问题。
除此之外,很多开源项目将文生图、图片编辑拆分为两套完全独立的模型。用户想要同时拥有两项能力,就需要下载多个权重文件,部署与使用流程繁琐。还有不少模型为了快速刷高榜单分数,大量使用 AI 合成图像作为训练素材,虽然评测成绩亮眼,但生成实拍质感照片时画面违和感严重。
在此背景之下,LLaDA‑Image 从零开启训练,训练数据集以真实实拍照片为主,AI合成图片占比很低。研究团队完整公开模型权重、训练代码以及从原始数据到成品模型的全链路训练方案。项目想要验证一个方向:依托真实实拍照片为主的数据集,是否可以从零训练出实力强劲的开源图像生成模型。
主要功能
- 文字生成高质量图片:接收中英文自然语言提示词,生成写实摄影、国风绘画、海报、文物、美食、风光等多种风格图像,擅长还原实拍照片的纹理、光影与材质细节。
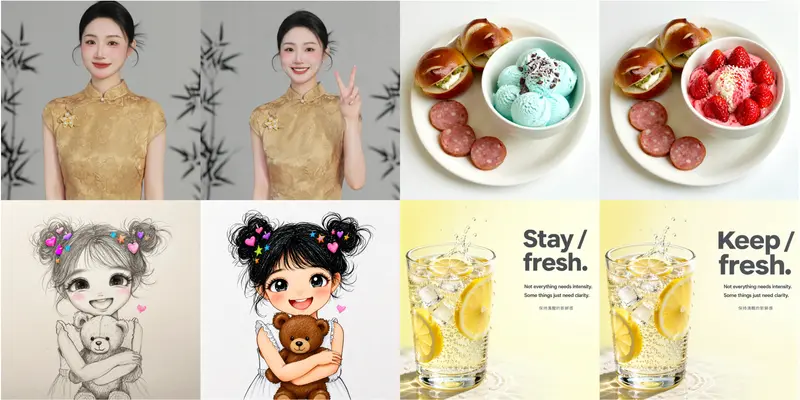
- 图像指令式编辑:上传一张参考原图之后,使用自然语言下达修改指令,即可更换画风、修改画面文字、替换物体颜色、更换背景、增减画面元素;编辑过程尽可能保留不需要改动的原有画面内容。
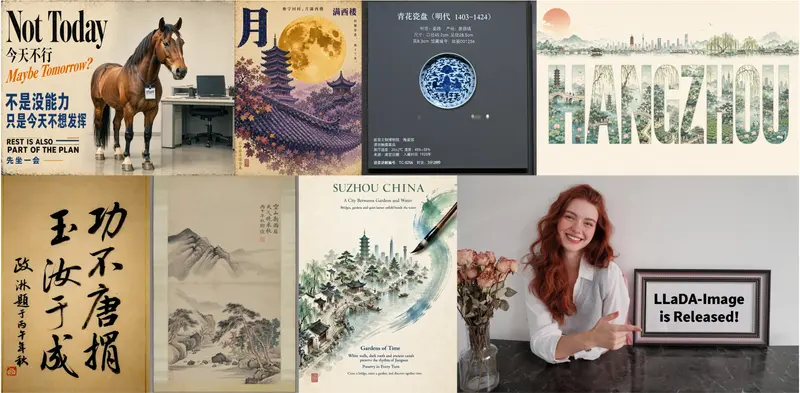
- 双语文字渲染:支持在图像内生成中文、英文文字,海报、展签、书法标语等场景下,文字错字、乱码问题得到明显改善。
- 快慢双版本可选:完整版模型画质出色;Turbo蒸馏版步数少、出图速度快,适配对生成效率要求较高的场景。
- 可复现的完整训练流程:科研人员与开发者可以完整复现整套训练过程,并且基于现有成果开展二次开发。
工作原理
LLaDA‑Image整体由三大模块组成:负责解析文字与图像信息的多模态理解模块;衔接理解模块和生成模块的转换连接器;负责输出像素画面的扩散Transformer生成主干。
整套训练流程分五个阶段循序渐进:
第一阶段:预训练,只用图片学习视觉常识
该阶段几乎不使用图文配对素材,仅投喂海量真实图像。模型不需要解读文字,单纯从画面中学习物体形态、山川地貌、食物器物特征、光影变化、材质纹理等基础视觉知识。训练时会随机遮挡图片当中的一部分区域,要求模型补全被遮挡内容,迫使模型学习物体结构与空间关系,而不是死记硬背整张照片,为后续训练打下扎实的视觉基础。
第二阶段:中期训练,提升图像分辨率
延续纯图像训练思路,逐步提升训练图片的分辨率。模型开始学习高清图像的细节特征;项目采用多比例分桶训练策略,图片无需强制裁剪拉伸为正方形,保留原图横版、竖版长宽比例,从而让模型掌握生成不同画幅图像的能力。这一阶段依旧没有大规模接入文字指令训练。
第三阶段:图文对齐监督微调
在模型具备充足视觉认知能力之后,引入大量图文配对数据,教会模型读懂人类提示词,将文字描述转化为对应的画面。训练过程当中分辨率逐步提升,从中等尺寸过渡至高清图像。项目针对性补充人像、含文字画面的训练样本,补强人物生成、画面文字绘制两大薄弱环节。
第四阶段:生成任务与编辑任务联合训练
该阶段不再只训练文生图任务,混入大量图像编辑样本一同训练。样本输入包含原始参考图片、修改指令以及修改完成后的目标图像。编辑任务设计两条独立的信息通道:一条通道读取文字编辑指令;另一条通道专门解析原图,同时提取画面语义信息和像素细节。双通道协同工作,实现指定区域修改、其余画面尽量保持不变。训练时文生图样本和编辑样本混合投喂,防止模型在学习编辑功能之后遗忘图像生成能力。
第五阶段:蒸馏得到快速Turbo版本
完整版模型需要经过多轮降噪迭代才能产出高质量图像。团队使用TwinFlow蒸馏方案,将完整版模型的能力迁移到少步数的快速模型当中。蒸馏过程设置两套角色,一套图像生成模块、一套分布评判模块互相配合,最终得到仅需少量采样步骤就可以逼近原版画质的Turbo版本。
推理阶段,完整版执行标准多轮降噪流程生成图像;Turbo版本直接使用蒸馏后的少步数方案。执行图像编辑任务时,参考图像走独立通路,与文字编辑指令完成信息融合,再交由生成主干输出最终修改图像。
测试结果
研发团队选用多套主流图像评测数据集,将LLaDA‑Image与多款开源、闭源图像模型开展横向对比测试。
- 文生图综合能力位列开源模型第一
在面向创作者的综合评测集Qwen‑Image‑Bench当中,LLaDA‑Image中英文赛道得分均为开源模型最高分。评测维度覆盖画面质量、美学观感、提示词匹配度、实拍照片还原、创意生成等多个方向,模型在画面质量、美学效果、指令匹配三项指标上表现亮眼。 - 画面文字生成能力优秀
经过两套专门针对图像文字生成任务的评测测试,模型能够生成海报、展签、插画内多处中英文文字;多文字区块同时出现时,错字、乱码的发生率较低,综合表现处于第一梯队。当画面内文字数量过多、排版极度复杂时依旧有概率出现瑕疵,这也是当前AI图像模型普遍存在的短板。 - 指令式图片编辑效果
在GEdit‑Bench图像编辑数据集上完成十余类编辑任务测试,涵盖画风转换、文字修改、背景替换、物体更换、属性调整等场景。测试结果显示,单模型可以同时胜任生成与编辑任务,语义理解得分表现优秀;不过和专门面向编辑场景开发的模型相比,图像精细质感方面还有进一步提升的空间。 - Turbo快速版本效果
蒸馏之后的Turbo版本仅需2‑4步采样,生成速度大幅提升。综合评测分数对比完整版小幅下降,但性能依旧明显优于同类型少步数开源图像模型,可以适配速度优先的业务场景。 - 人工样例定性测试效果
人像、风光、文物、美食、国风海报等复杂提示词场景下,模型可以生成实拍质感极强的图像,人物皮肤、布料纹理、器物材质、环境光影还原效果出色;同时也能够完成实拍照片转漫画、古风绘画等风格转换任务。
项目团队也在论文当中坦诚模型现存短板:物体计数任务很容易出错;原生输出分辨率有限,暂不支持原生2K超大分辨率;复杂多区块文字排版稳定性不足;面对部分小众专业题材时偶尔会出现事实错误。
普通用户日常使用
- 本地部署保障隐私安全:模型完全开源,支持本地电脑离线运行,用户上传的参考图像不会发送至外部服务器,照片隐私得到保护。
- 中文提示词友好:模型对于中文自然语言理解能力出色,普通用户无需记忆复杂英文关键词,大白话就可以完成图像生成与编辑。
- 降低高质量图像模型使用门槛:以往高水准图像生成能力大多掌握在闭源商业产品手中,这套完全开放的方案,让小团队、个人爱好者也能够用上接近商业水准的图像生成工具。
客观局限与伦理提醒
该模型依旧存在当前AI图像生成工具的共性缺陷,物体计数容易出错,超复杂文字排版偶发乱码。同时模型可以生成高度逼真的人像照片,存在深度伪造风险。在生成人像、真实人物相关图像前,务必取得当事人授权;AI产出图像建议标注合成来源,严禁用于造谣、伪造证据等违规用途。
© 版权声明
文章版权归作者所有,未经允许请勿转载。